月次の売上CSVを集計するスクリプトを、Claude CodeやCodexのようなAIコーディングツールに作らせると、動くコードはすぐに返ってきます。けれども売上CSVには、同じ取引の二重取り込み、返金、まだ確定していない保留、日付の書き方が崩れた行や空欄の金額が混ざります。どの行をどう扱うかを決めずに頼むと、返ってきたコードが正しいのかを判断する材料がありません。
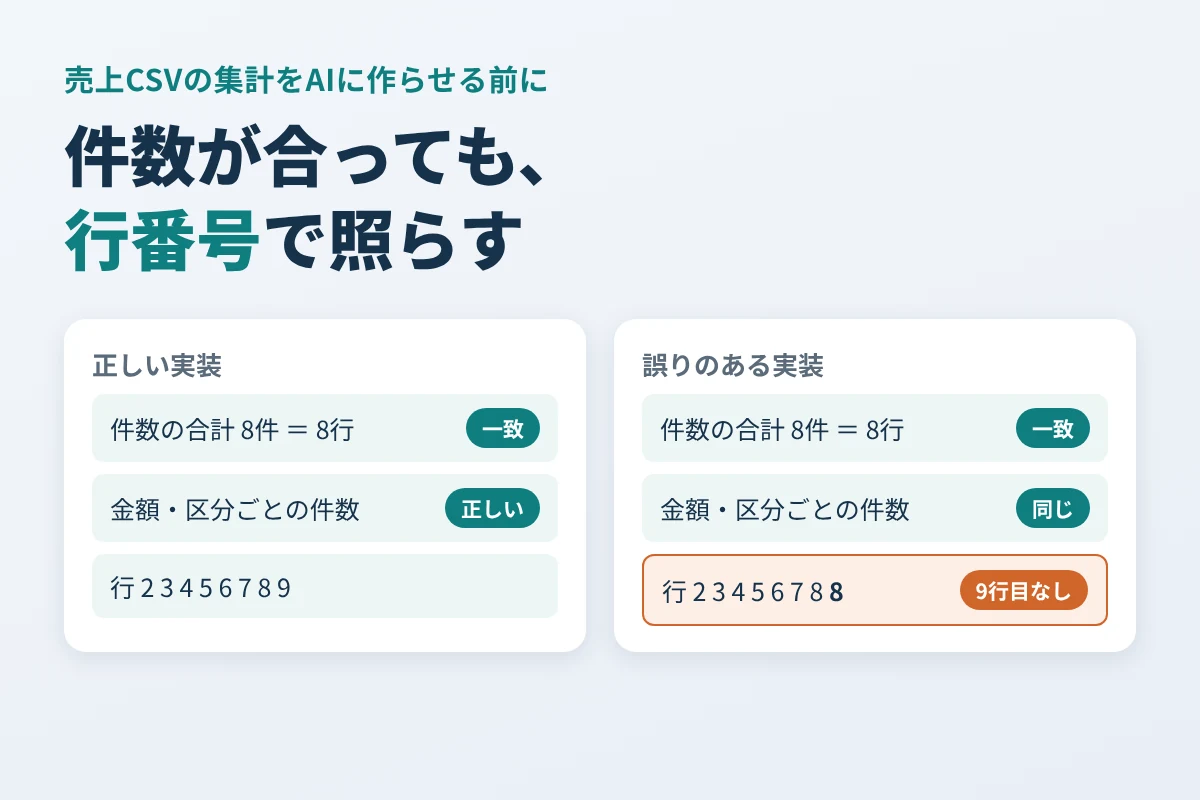
そこで、各行の扱いと集計を止める条件をテストに書いて先に渡し、返ってきた実装をそのテストで確かめます。このとき、件数の確かめ方に落とし穴がありました。隔離した行の件数を「理由の数」で数え、日付を読めなかった行を黙って飛ばす実装をわざと作って試すと、8行のCSVで、分類した件数の合計は8件で入力行数と一致し、区分ごとの件数も売上・返金・差額の金額も正しい値と同じでした。行番号を並べて初めて、9行目が消え、8行目が2回数えられていると分かりました。
この記事では、検査用のCSVと各行の扱い、集計を止める3つの条件、行番号ごとの照合まで含めたテスト、AIに渡す依頼文、照合用の参照実装を、そのまま使える形で渡します。読み終えたら、自分の売上CSVの仕様に合わせてテストを書き換え、AIが返した集計スクリプトを採用するかを判断できます。
検査用のCSVと、各行の扱い
テストに使うCSVは8行です。kindは種別で、saleが売上、refundが返金、pendingが保留、refは返金元の取引IDです。金額は常に正の数で持ち、返金かどうかは種別で分けると決めています。
id,date,kind,amount,ref
A1,2026-09-01,sale,10000,
A2,2026-09-02,sale,3000,
A2,2026-09-02,sale,3000,
R1,2026-09-05,refund,3000,A2
P1,2026-09-06,pending,5000,
X1,2026-09-07,sale,oops,
X2,2026/09/08,sale,,
X3,09-04-2026,sale,800,
1行目は見出しなので、データは2行目から9行目です。各行の扱いは次のとおりです。
| 行 | 扱いと理由 | 差額への反映 |
|---|---|---|
| 2行目 A1 | 売上 | +10,000円 |
| 3行目 A2 | 売上 | +3,000円 |
| 4行目 A2 | 重複:3行目と全項目が同じ | 入れない |
| 5行目 R1 | 返金:A2の返金 | −3,000円 |
| 6行目 P1 | 保留:種別がpending | 入れない |
| 7行目 X1 | 隔離:金額がoops | 入れない |
| 8行目 X2 | 隔離:日付がスラッシュ区切り、金額が空欄 | 入れない |
| 9行目 X3 | 隔離:日付の月日の順が決められない | 入れない |
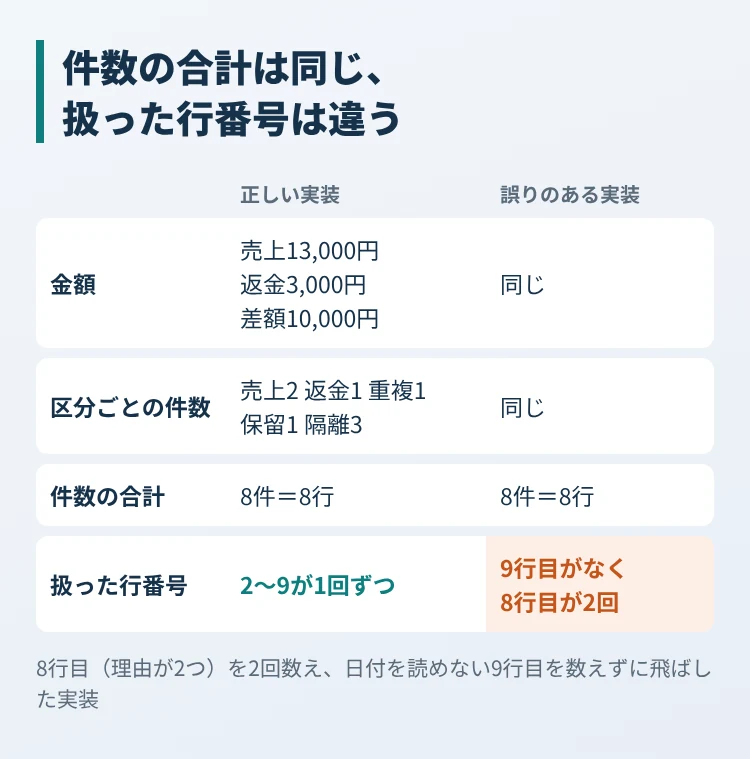
売上は10,000円+3,000円=13,000円、返金は3,000円、差額は10,000円です。件数は売上2・返金1・重複1・保留1・隔離3で、合計8行になります。
金額の列を種別を見ずに足すと、重複の3,000円、返金の3,000円、保留の5,000円、9行目の800円まで売上に入ります。そして10,000円が出ても、隔離した3行と保留の1行は何も片付いていません。この差額は、扱いを決められた行だけにもとづく暫定の値として扱います。
書式の崩れた行は、直さずに隔離して理由を全部残す
日付や金額の崩れた行を、AIに「きれいに直して」と頼むと、数字が静かに変わります。たとえば金額の空欄を0円にすると、エラーは出ませんが、「売上がなかった」と「記入漏れ」が区別できなくなります。そこで、1行ごとの書式は次のように検査し、合わない行は直さずに隔離します。
| 項目 | 受け付ける値 | しないこと |
|---|---|---|
| 日付 | 実在するYYYY-MM-DD | スラッシュ区切りや月日の順を推測で直さない |
| 金額 | 1以上の整数 | 空欄を0円にしない。文字を数字に読み替えない |
| 種別 | sale、refund、pendingのどれか | 知らない種別を売上として扱わない |
9行目の09-04-2026は、9月4日なのか4月9日なのかを、CSVからは決められません。推測で直すと、書式の検査は通るのに中身は別の日付というデータができます。だから元の値のまま確認に回します。
隔離した行には、元の行番号、元の値、当てはまる理由をすべて残します。8行目には日付と金額の2つの問題があります。最初の理由だけで打ち切らずに両方を残すと、直す人が確認する箇所をまとめて追えます。保留の6行目は、書式としては正しい行ですが、売上には数えません。行として正しいかどうかと、売上として数えるかどうかは別の判断です。
集計を止める3つの条件
隔離とは別に、集計そのものを続けてはいけない状態があります。次の3つは、集計値を出す前に止めます。
-
同じIDで内容が違う行がある(重複なのか別の取引なのかを決められない)。
-
返金の
refが、同じCSVの売上にない。 -
1つの売上に対する返金の累計が、元の売上を超える。
重複かどうかを、日付や金額の一致だけで判断しないのは、同じ金額の商品が別々に売れることは普通にあるからです。取引IDが元のシステムで一意だと保証されていないなら、先に取引の見分け方を決めるところから始めます。
件数が合っても、行が正しく扱われたとは限らない
集計の処理には、取りこぼしの確認として「分類した件数の合計=入力行数」を入れることがよくあります。この照合だけで足りるかを確かめるため、2つの誤りを入れた実装をわざと作り、正しく動く参照実装と同じテストを流しました(Python 3.10、2026年10月21日)。誤りの1つ目は、隔離した行の件数を行ではなく理由の数で数えたこと。2つ目は、日付の読み取りで例外になった行を、数えずに飛ばしたことです。
        if "/" in row["date"]:
            reasons.append("日付がYYYY-MM-DDでない")
        else:
            try:
                date.fromisoformat(row["date"])
            except ValueError:
                continue  # 読めない日付の行を、数えずに飛ばす
        # (金額の検査は省略)
        if reasons:
            for reason in reasons:  # 隔離の件数を、理由の数だけ数える
                lines.append((line, "quarantine"))
結果は次のとおりです。
| 確かめたこと | 参照実装 | 誤りを入れた実装 |
|---|---|---|
| 売上・返金・差額 | 13,000円・3,000円・10,000円 | 同じ |
| 区分ごとの件数 | 売上2・返金1・重複1・保留1・隔離3 | 同じ |
| 件数の合計と入力行数 | 8件と8行で一致 | 8件と8行で一致 |
| 扱った行番号 | 2, 3, 4, 5, 6, 7, 8, 9 | 2, 3, 4, 5, 6, 7, 8, 8 |
9行目のX3は日付が読めずに飛ばされ、その1件分を、理由が2つある8行目のX2が2回数えられて埋めていました。数え落としと二重計上が相殺されて、件数の合計も区分ごとの件数も、正しい値と同じになったのです。金額に影響しない行で起きた誤りなので、金額のテストでも見つかりません。
見つけたのは、扱った行番号を順に並べて、2行目から9行目までがちょうど1回ずつ出ているかを確かめるテストと、隔離した行の行番号・値・理由を照らすテストでした。そこで、AIに渡すテストには、件数と金額に加えて、この2つを入れます。
AIに渡すテスト:test_sales.py
空のフォルダに次をtest_sales.pyとして保存し、依頼文と一緒にAIコーディングツールへ渡します。実装する関数の入口と、期待する結果をここで固定します。Python 3.10以降の標準機能だけで動きます。
コードを開く
import unittest
from sales import summarize

DATA = """id,date,kind,amount,ref
A1,2026-09-01,sale,10000,
A2,2026-09-02,sale,3000,
A2,2026-09-02,sale,3000,
R1,2026-09-05,refund,3000,A2
P1,2026-09-06,pending,5000,
X1,2026-09-07,sale,oops,
X2,2026/09/08,sale,,
X3,09-04-2026,sale,800,
"""


class SalesTests(unittest.TestCase):
    def test_totals_and_counts(self):
        result = summarize(DATA)
        self.assertEqual((result["revenue"], result["refund"], result["net"]),
                         (13000, 3000, 10000))
        self.assertEqual(result["counts"], {"sale": 2, "refund": 1, "duplicate": 1,
                                            "pending": 1, "quarantine": 3})

    def test_every_line_once(self):
        lines = [line for line, _ in summarize(DATA)["lines"]]
        self.assertEqual(lines, list(range(2, 10)))

    def test_quarantine_keeps_values_and_all_reasons(self):
        got = [(q["line"], q["id"], q["row"]["date"], q["row"]["amount"], q["reasons"])
               for q in summarize(DATA)["quarantine"]]
        self.assertEqual(got, [
            (7, "X1", "2026-09-07", "oops", ["金額が正の整数でない"]),
            (8, "X2", "2026/09/08", "", ["日付がYYYY-MM-DDでない", "金額が空欄"]),
            (9, "X3", "09-04-2026", "800", ["日付がYYYY-MM-DDでない"]),
        ])

    def test_conflicting_id(self):
        with self.assertRaisesRegex(ValueError, "同一IDの内容が不一致"):
            summarize(DATA + "A2,2026-09-02,sale,4000,\n")

    def test_missing_sale(self):
        with self.assertRaisesRegex(ValueError, "返金元がない"):
            summarize(DATA + "R2,2026-09-10,refund,100,A9\n")

    def test_excess_refund(self):
        with self.assertRaisesRegex(ValueError, "売上を超える返金"):
            summarize(DATA + "R2,2026-09-10,refund,1,A2\n")


if __name__ == "__main__":
    unittest.main()
6つのテストのうち、最初の1つが金額と件数、次の2つが行番号ごとの照合と隔離した行の中身、残りの3つが集計を止める条件です。
依頼文
依頼文には、テストに書いた扱いを言葉でも書き、テストを変えないことを頼みます。
元のCSVを変更せず、売上・返金・差額と、行ごとの扱いを出す処理を作ってください。同じIDで全項目が一致する行は重複として除外します。同じIDで内容が違う場合、返金元がない場合、返金の累計が元の売上を超える場合は、テストに示したメッセージの
ValueErrorで止めてください。日付・金額・種別の書式が合わない行は直さずに隔離し、元の行番号、元の値、当てはまる理由をすべて残してください。日付を推測で直さず、金額の空欄を0にしないでください。保留は件数だけを数え、差額は暫定の値と明記してください。添付のtest_sales.pyを満たすsales.pyを作り、summarize(text)はテストが読む形の辞書を返してください。変更のたびにpython3 -m unittest -v test_sales.pyを実行し、テストの入力・期待値・停止条件は変更しないでください。
返ってきた実装を確かめる
依頼する前に、テストのファイルのハッシュ(内容から計算する短い識別値)を控えておきます。
shasum -a 256 test_sales.py実装が返ってきたら、同じコマンドでハッシュを出し、依頼前と同じかを見ます。違っていれば、テストが書き換えられています。テストや期待値を変えたいという提案があったら、実装に合わせて受け入れるのではなく、仕様と実装のどちらに問題があるかを先に調べます。ハッシュが同じなら、テストを流します。
python3 -m unittest -v test_sales.py照合用の参照実装(下)で流したときの結果です。返ってきた実装でも6件がokになれば、テストに書いた扱いは満たしています。
test_conflicting_id (test_sales.SalesTests) ... ok
test_every_line_once (test_sales.SalesTests) ... ok
test_excess_refund (test_sales.SalesTests) ... ok
test_missing_sale (test_sales.SalesTests) ... ok
test_quarantine_keeps_values_and_all_reasons (test_sales.SalesTests) ... ok
test_totals_and_counts (test_sales.SalesTests) ... ok

----------------------------------------------------------------------
Ran 6 tests in 0.001s

OK
テストが通っても、それはテストに書いた8行と3条件について正しいということです。依頼文に書かなかった扱い(たとえば、金額の桁区切りのカンマや、別の月の売上を参照する返金)は、AIの判断で決まっています。返ってきたコードを読み、仕様にない扱いを見つけたら、テストに1行足してから直してもらいます。今回の失敗例もテストに残したまま変更させると、あとで処理を整理したときに、止める条件や行番号の照合が消えるのを防げます。
照合用の参照実装:sales.py
テストと期待値が正しいかを、依頼する前に手元で確かめるための実装です。AIに新しく作らせるフォルダには、テストと依頼文だけを置き、この参照実装は別のフォルダに保存しておきます。同じフォルダに置くと、AIが参照実装を読めてしまい、仕様とテストから作った実装かどうかを確かめられなくなるからです。
コードを開く
import csv
import io
import re
from datetime import date


def check_row(row):
    """1行の書式を検査し、当てはまる理由をすべて返す。直さない。"""
    reasons = []
    if not re.fullmatch(r"\d{4}-\d{2}-\d{2}", row["date"]):
        reasons.append("日付がYYYY-MM-DDでない")
    else:
        try:
            date.fromisoformat(row["date"])
        except ValueError:
            reasons.append("日付が実在しない")
    if row["amount"] == "":
        reasons.append("金額が空欄")
    elif not re.fullmatch(r"[1-9]\d*", row["amount"]):
        reasons.append("金額が正の整数でない")
    if row["kind"] not in {"sale", "refund", "pending"}:
        reasons.append("種別が不明")
    return reasons


def summarize(text):
    rows = list(csv.DictReader(io.StringIO(text)))
    seen, sales, refunds = {}, {}, []
    lines, quarantine = [], []
    for line, row in enumerate(rows, start=2):  # 1行目は見出し
        key = row["id"]
        if not key:
            raise ValueError("IDなし")
        if key in seen:
            if row != seen[key]:
                raise ValueError("同一IDの内容が不一致")
            lines.append((line, "duplicate"))
            continue
        seen[key] = row.copy()
        reasons = check_row(row)
        if reasons:
            quarantine.append({"line": line, "id": key, "row": row.copy(), "reasons": reasons})
            lines.append((line, "quarantine"))
        elif row["kind"] == "pending":
            lines.append((line, "pending"))
        elif row["kind"] == "sale":
            sales[key] = int(row["amount"])
            lines.append((line, "sale"))
        else:
            refunds.append((row["ref"], int(row["amount"])))
            lines.append((line, "refund"))
    returned = {}
    for ref, amount in refunds:
        if ref not in sales:
            raise ValueError("返金元がない")
        returned[ref] = returned.get(ref, 0) + amount
        if returned[ref] > sales[ref]:
            raise ValueError("売上を超える返金")
    revenue, refund = sum(sales.values()), sum(returned.values())
    counts = {name: sum(1 for _, c in lines if c == name)
              for name in ("sale", "refund", "duplicate", "pending", "quarantine")}
    return {"revenue": revenue, "refund": refund, "net": revenue - refund,
"counts": counts, "lines": lines, "quarantine": quarantine}隔離した行は、quarantineに元の行番号・ID・元の行の値・理由の一覧として残ります。担当者は、この一覧から元のCSVの該当行へ戻り、直すか、売上から外すかを決めます。
自分の売上CSVへ広げるときに決めること
このテストの入力条件は、UTF-8、id・date・kind・amount・refの5列、正の整数の金額、同じCSVの中の売上を参照する返金です。自分のデータへ広げる前に、次を決めてテストに書き足します。
-
文字コード(表計算ソフトから書き出したCSVは、UTF-8でないことがあります)、列の名前、金額の桁区切りと通貨。
-
計上日のルールと、前の月の売上に対する返金の照合先。
-
取引IDが一意でない場合の、取引の見分け方。
元のファイルは読み取り専用のコピーで扱い、隔離した行と保留の行を担当者が片付けるまでは、確定の月次売上として配らない、という扱いも仕様に足しておきます。
コメントを残す