カテゴリー: Codex

  • AIの設計案を別のセッションで実装させる前に、原仕様にない制約を見分け、引き継ぎ票で分けて渡す

    AIの設計案を別のセッションで実装させる前に、原仕様にない制約を見分け、引き継ぎ票で分けて渡す

    AIのあるセッションで設計案を作り、実装は新しいセッションや別のAIに任せたい。そのとき受け手が読むのは、承認済みの仕様と、設計者が足した提案が混ざった1枚の設計案です。原仕様にない一文が承認済みの要件と同じ顔で並んでいると、受け手はそれを要件として実装します。

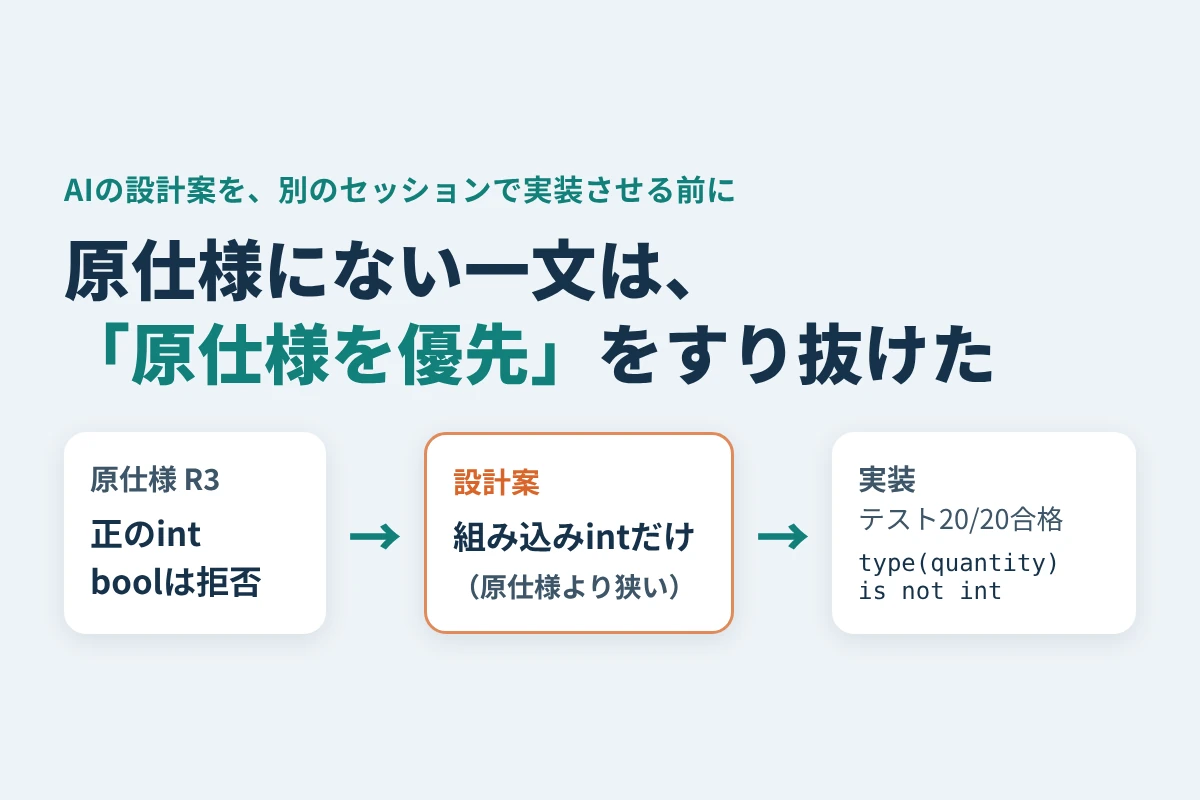
    Codexに在庫予約機能の設計案を作らせ、その設計案を原仕様と一緒に別のセッションへ渡して実装させたところ、まさにそれが起きました。設計案は8つの要件すべてに触れ、boolが数量として通ってしまうリスクも正しく指摘していましたが、その対策の一文で、原仕様の「正のint」を「組み込みintだけ」に狭めていました。受け手には「設計案と原仕様が食い違ったら原仕様を優先」と添えましたが、実装はこの制約をそのまま取り込み、テストにはすべて合格しました。今回、原仕様が何も書いていない点への制約の追加は、この優先の一文では防げませんでした。

    この記事では、設計案を原仕様の要件ごとに照らして原仕様にない制約を見分ける手順と、原仕様・設計提案・未決事項を欄で分けて渡す引き継ぎ票、受け手に要件とテストの対応を返させる受領確認を、この実例で示します。読み終えたら、自分の設計案から、実装の前に渡せる引き継ぎ票を作れます。

    設計案の一文が、実装に入るまで

    題材は、Pythonの在庫予約関数 reserve(stock, requests) の追加です。原仕様(SPEC.md)は8つの要件で、数量については次のように書いています(R3)。

    R3: quantity must be a positive int; reject bool, zero, negative, float with ValueError.

    Codex CLIの新しいセッションに、原仕様・既存コード・15件のテストを渡し、ファイルを変えずに設計案だけを作らせました(2026年9月21日、1回)。設計案の「要件」と「変更案」には、次の2行がありました。

    quantity は bool を除く正の組み込み int のみ許可する。

    type(quantity) is int and quantity > 0 を検証する。

    同じ設計案の「具体的な失敗リスク」には、「isinstance(quantity, int) だけでは True を受理してしまう。」とあります。Pythonの bool は int のサブクラスなので、この指摘は正しく、R3の「boolを拒否」に沿っています。ただ、対策として書かれた type(quantity) is int は、bool以外のintのサブクラス(intを継承したクラスの値)まで拒否します。R3はそこまで書いていません。

    この設計案を PLAN.md として原仕様と一緒に置き、別の新しいセッションに実装させました(同じ日、1回)。依頼文には次の一文を入れています。

    Read PLAN.md as an advisory design. SPEC.md is authoritative if they differ.

    受け取った実装の数量の判定は、設計案のとおりでした。

    if type(quantity) is not int or quantity <= 0:

    この実装は、事前に渡した15件のテストと、実装後に足した5件のテストにすべて合格しました。完了報告は「数量の厳密な検証(bool、0、負数、浮動小数を拒否)」と書くだけで、原仕様より狭めたことには触れていません。

    原仕様だけを渡して実装させた別の実装と、intのサブクラスの値を渡して比べました。class Quantity(int) で作った Quantity(1) などを、在庫5の商品への1件の予約として、保存しておいた2つの実装に渡した結果です(Python 3.13)。

    渡した数量 原仕様だけで実装した版 設計案を添えて実装した版
    Quantity(1)(intのサブクラス) 受け入れる(在庫5→4) ValueError で拒否する
    1 受け入れる 受け入れる
    True 拒否する 拒否する
    1.0 拒否する 拒否する

    どちらの実装も同じ20件のテストにすべて合格しているので、テストの結果だけを見ると差はありません。原仕様だけで実装した版の点検の手順は、Codexの合格報告を受け入れる前の点検の記事で扱っています。

    原仕様はintのサブクラスの扱いを明記していないため、設計案の「組み込みintだけ」は、矛盾ではなく仕様の具体化として取り込まれたと解釈できます。今回確かめたのは、優先順位の一文だけでは追加制約の採用を防げなかったことです。そこで、原仕様にある要件と設計者の提案を欄で分け、追加制約を承認するかどうかも実装前に決める方法を提案します。
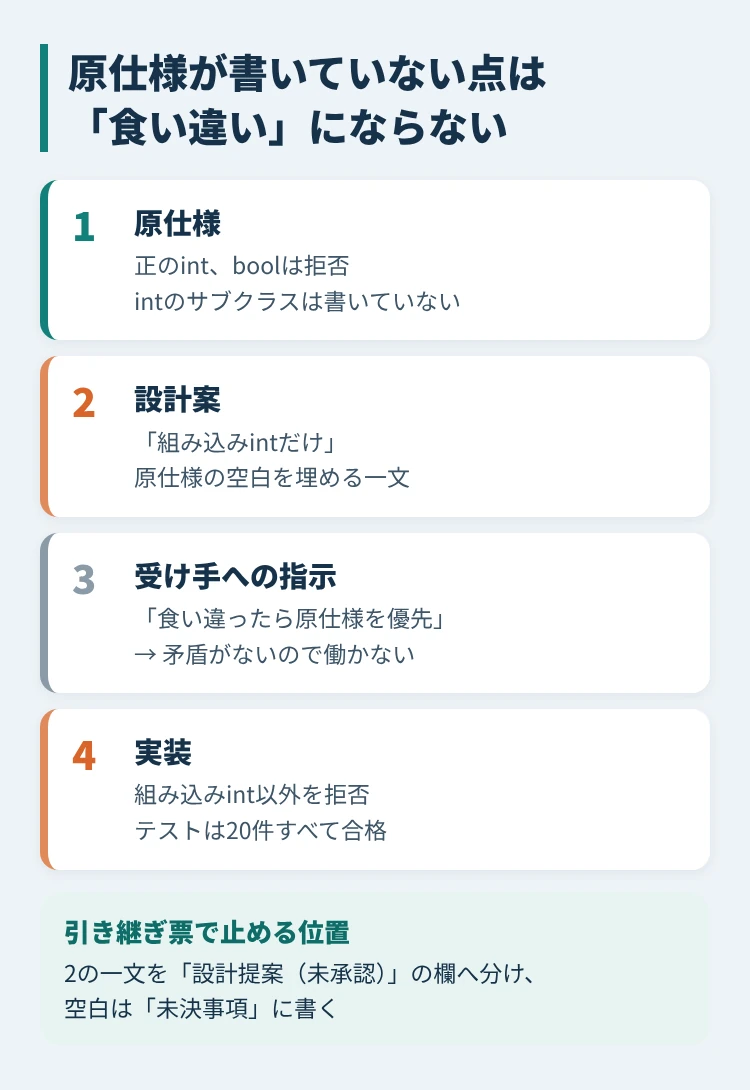
    設計案の一文が、原仕様の空白を通って実装に入った流れと、引き継ぎ票で原仕様と設計提案を分ける位置を示す図
    今回の実装では、原仕様にない制約の追加を、優先の一文だけでは止められませんでした。

    手順1:設計案を、原仕様の要件ごとに照らす

    渡す前に、設計案の要件や方針の一文ずつを、原仕様の要件番号と照らします。照らした結果には、次の3つの印のどれかを付けます。

    印 当てはまる記述 引き継ぎ票での扱い
    同じ 原仕様の要件を言い換えただけ 「原仕様」欄に要件番号で書く
    狭い・広い 原仕様の要件より条件を絞る、または緩める 「設計提案」欄に移し、承認するまで要件にしない
    原仕様にない 原仕様のどの要件にも当たらない方針 「設計提案」欄に移す。決める人がいなければ「未決事項」へ

    今回の設計案に印を付けると、たとえば次のようになります。

    設計案の記述 照らした原仕様 印と扱い
    入力を変更せず、常に新しい在庫辞書を返す R1 同じ:原仕様欄にR1と書く
    全リクエストを検証後に在庫を反映し、欠品・在庫不足・重複矛盾時は ValueError R4・R6 同じ:原仕様欄にR4・R6と書く
    bool を除く正の組み込み int のみ許可する R3(正のint、boolを拒否) 狭い:設計提案欄へ。intのサブクラスの扱いを未決事項にする
    エラーメッセージやエラー優先順位は仕様外。テストで文言へ依存させない なし 原仕様にない:設計提案欄へ(原仕様と矛盾しないので、承認すれば採用できる)

    設計案が8つの要件すべてに触れていても、この照合は省けません。網羅しているかと、頼んでいない条件を足していないかは、別の問いだからです。今回の「狭い」の一文は、正しいリスク指摘のすぐ隣にありました。指摘が的確なほど、その対策の一文も要件のように読めてしまいます。

    印を付けるときに迷ったら、2つの書き方で結果が割れる値を実際に渡してみます。次のコードを int_boundary.py として保存し、python3 int_boundary.py で実行すると、intのサブクラスも受け入れる判定(正のintで、boolを除く)と設計案の判定(組み込みintだけ)の違いが出ます。

    class Quantity(int):
        pass
    
    for value in [True, 1, Quantity(1)]:
        positive_int = isinstance(value, int) and not isinstance(value, bool) and value > 0
        builtin_only = type(value) is int and value > 0
        print(type(value).__name__, positive_int, builtin_only)
    bool False False
    int True True
    Quantity True False

    3行目の Quantity だけ結果が割れます。割れた値があれば、その記述は「同じ」ではなく「狭い・広い」です。

    手順2:引き継ぎ票に、原仕様・設計提案・未決事項を分けて書く

    照らした結果を、次の引き継ぎ票に書き写します。受け手が読む資料はこの票と、原仕様・テスト・対象のコードです。設計案は添えてもかまいませんが、判断の根拠は票の欄で示します。

    目的:誰のどの問題を解決するか
    対象:リポジトリ、基準コミット、作業ブランチ
    原仕様:承認済みの要件を番号つきで(R1〜)。設計案で言い換えた文ではなく原文を書く
    設計提案:原仕様より狭い・広い記述と、原仕様にない方針。それぞれ「承認済み」か「未承認」かを書く
    未決事項:決める人、決まるまで実装で触れない部分
    調査済み:読んだファイル、関数、確かめた挙動
    変更範囲:変更してよい場所、維持する公開API
    検査:実行コマンド、合格の条件、既に分かっている失敗
    禁止事項:依存の追加、データ移行、外部送信など
    復旧:変更を戻せる単位と、戻せない副作用
    受領確認:要件ごとに確かめるテストと、採用する設計提案を返してから実装する

    今回の例なら、設計提案と未決事項の欄は次のようになります。

    設計提案:
    - 数量は組み込みintだけを受け入れる(R3より狭い。未承認)
    - エラーの文言と優先順位はテストで固定しない(原仕様にない。承認済み)
    未決事項:
    - intのサブクラスの数量を受け入れるか(決める人:[呼び出し側の担当])
      決まるまで、数量判定の実装と、その判定を含む機能の取り込みを保留する。独立して進められる部分だけ実装する

    未決事項に「決まるまでの扱い」を書いておくのは、受け手が空白を自分で埋めないためです。今回の実装は、空白を設計案の一文で埋めていました。

    手順3:受け手に、要件とテストの対応を返させる

    実装を始める前に、受け手に次の2つを返してもらいます。

    実装の前に、次の2つを返してください。
    1. 原仕様の要件番号ごとに、それを確かめるテスト名(なければ「なし」)
    2. 引き継ぎ票の設計提案のうち、実装に取り入れるものと、その理由
    返した内容に不明点や矛盾があれば、実装を始めずに質問してください。

    1で「なし」が返ってきた要件は、テストが守っていない要件です。今回なら、R3に対して返るのは test_05〜test_08(bool・0・負数・float)で、intのサブクラスを確かめるテストはありません。そこが、引き継ぎで受け手の判断に任されている場所です。2で「未承認」の提案を取り入れると返ってきたら、実装の前に止めて決めます。

    返答が正しくても、実装がそのとおりになるとは限りません。実装を受け取ったら、差分と、未決事項に当たる値を渡した結果で確かめます。確かめ方は合格報告を受け入れる前の点検の記事の手順4と同じです。

    自分の案件で書き換える箇所と、渡す前の確認

    引き継ぎ票の各欄は、自分の案件で次のように書き換えます。

    • 原仕様:設計案の要約ではなく、承認済みの要件の原文を番号つきで貼る。

    • 設計提案:手順1で「狭い・広い」「原仕様にない」の印を付けた記述をすべて移し、承認の状態を書く。

    • 未決事項:決める人と、決まるまでの実装の扱いを書く。

    • 検査:実行するコマンドと、合格の条件(テスト件数、変更してよいファイル)を書く。

    渡す前に、次の3つを確かめます。

    1. 設計案の要件・方針の文に、すべて印が付いている。

    2. 「狭い・広い」「原仕様にない」の記述が、原仕様欄に混ざっていない。

    3. 未決事項のそれぞれに、決める人か、決まるまでの扱いが書いてある。

    3つがそろえば、受け手は設計案を「承認済みの要件」と「提案」に分けて読めます。今回の type(quantity) is int の一文も、設計提案の欄に「未承認」と書き、実装前に質問するよう受領確認で求めます。この引き継ぎ票で実装し直す検証は行っていないため、採用後も差分と境界値で確かめます。

    出典と確認日

  • AIにリファクタリングを任せる前に、テストが何を守っているかを、わざと壊した版で確かめる

    AIにリファクタリングを任せる前に、テストが何を守っているかを、わざと壊した版で確かめる

    重複したコードの共通化のようなリファクタリングは、AIに任せやすい仕事です。挙動を変えない変更なので、既存のテストが全部通れば終わりにしたくなります。ただ、テストが全部通ったことは、テストが見ている挙動が変わらなかったことしか示しません。守りたい挙動をテストが本当に見張っているかは、別に確かめる必要があります。

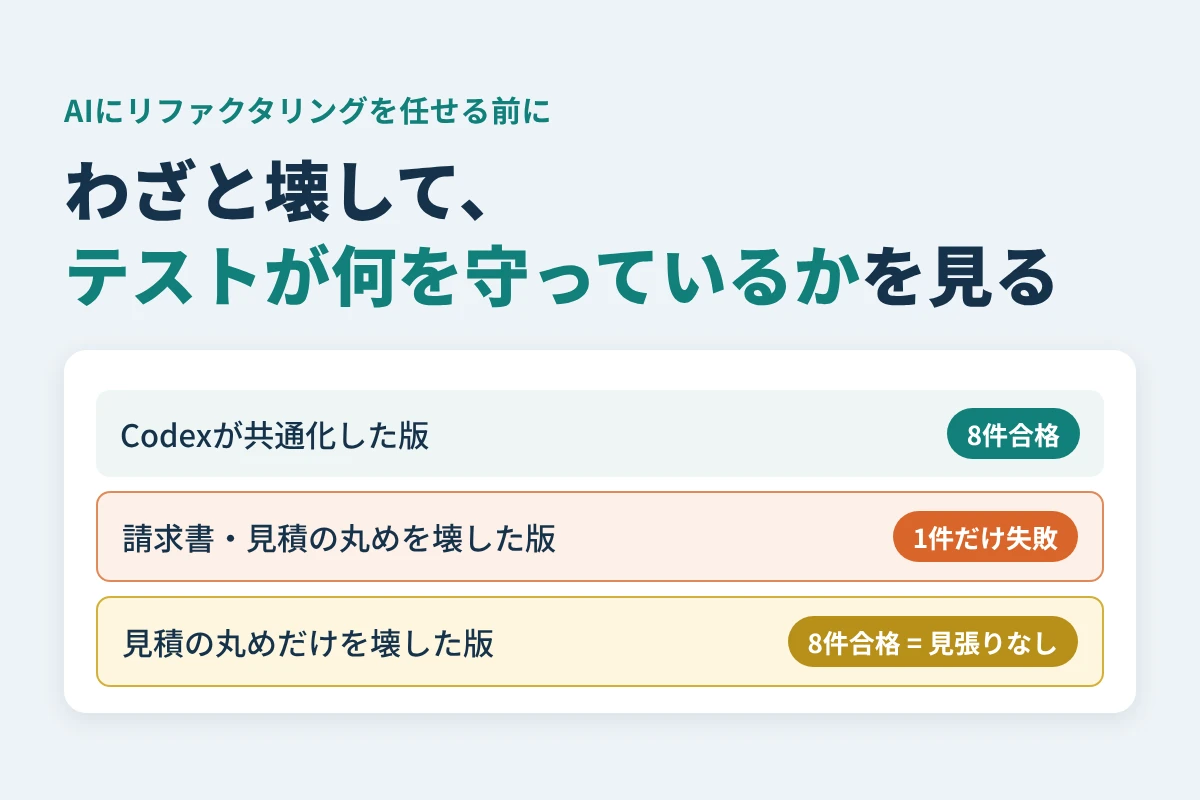
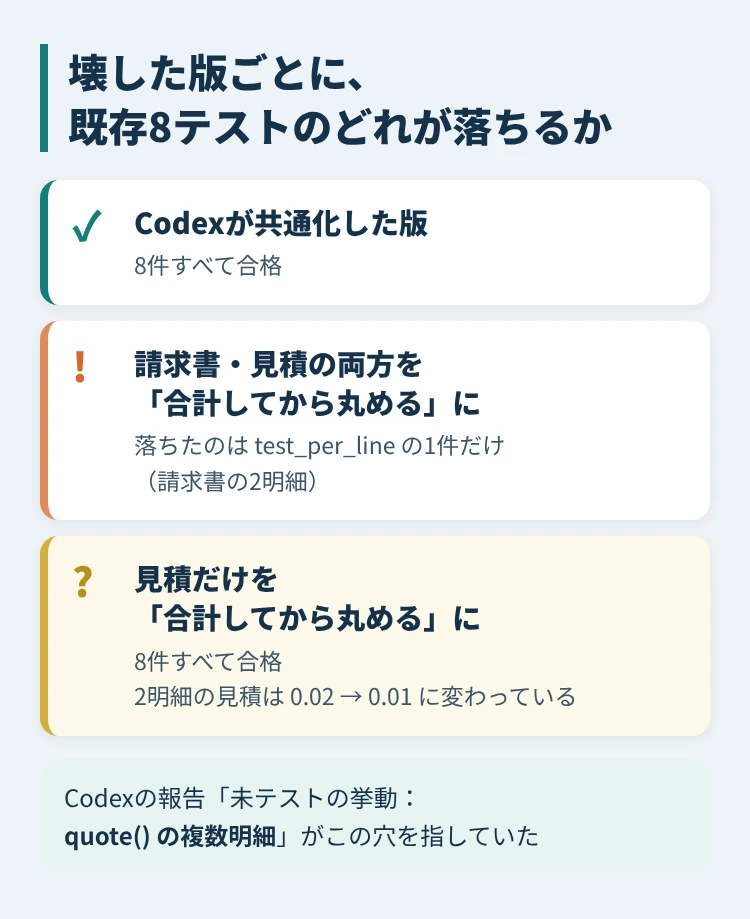
    請求書と見積で重複していた明細の金額計算を、Codexに1つの関数へまとめさせました。既存の8件のテストはすべて合格です。そのうえで、明細ごとに丸めていた計算を「合計してから丸める」に変えた版をわざと作って走らせると、落ちたのは請求書側の1件だけでした。見積側だけを同じように壊した版では、8件が1件も落ちません。見積の丸め順序を見張るテストはなかったのです。そしてCodexの完了報告は、「未テストの挙動」としてまさにその見積の複数明細を挙げていました。

    この記事では、守りたい挙動を1つずつ壊してテストを走らせ、どのテストが落ちるかを確かめる手順を、この実例で示します。読み終えたら、AIにリファクタリングを任せる前に、どの挙動のテストを足しておくべきかを判断できます。

    題材:請求書と見積の明細計算を1つにまとめる

    元のコードでは、invoice()(請求書)と quote()(見積)が同じ明細の計算を2回書いていました。どちらも明細ごとに金額を小数第2位で丸め(四捨五入)、それを合計します。

    from decimal import Decimal, ROUND_HALF_UP
    def invoice(lines):
        total=Decimal("0")
        for price, quantity in lines:
            total+=(Decimal(price)*quantity).quantize(Decimal("0.01"),rounding=ROUND_HALF_UP)
        return format(total,".2f")
    def quote(lines):
        total=Decimal("0")
        for price, quantity in lines:
            total+=(Decimal(price)*quantity).quantize(Decimal("0.01"),rounding=ROUND_HALF_UP)
        return {"amount":format(total,".2f"),"currency":"JPY"}

    Codex CLIの新しいセッションに、重複した明細の計算を非公開の補助関数に抜き出すこと、シグネチャ・出力・例外・Decimalの丸めを保つこと、既存テストを変えないこと、まだテストしていない挙動を報告することを、英語の仕様書で1回依頼しました(2026年9月21日、Python 3.13)。Codexは _line_amount() を追加して両方から呼ぶ形にし、変更は billing.py だけ、既存の8テストはすべて合格と報告しました。

    def _line_amount(price, quantity):
        return (Decimal(price)*quantity).quantize(Decimal("0.01"),rounding=ROUND_HALF_UP)

    既存の8テストは次のとおりです。7件が invoice()、1件が quote() を見ています。

    import unittest
    from billing import invoice, quote
    class Compat(unittest.TestCase):
        def test_empty(self): self.assertEqual(invoice([]),"0.00")
        def test_whole(self): self.assertEqual(invoice([("10",2)]),"20.00")
        def test_half(self): self.assertEqual(invoice([("0.005",1)]),"0.01")
        def test_per_line(self): self.assertEqual(invoice([("0.005",1),("0.005",1)]),"0.02")
        def test_negative(self): self.assertEqual(invoice([("-0.005",1)]),"-0.01")
        def test_quantity(self): self.assertEqual(invoice([("0.005",2)]),"0.01")
        def test_quote(self): self.assertEqual(quote([("2.555",1)]),{"amount":"2.56","currency":"JPY"})
        def test_generator(self): self.assertEqual(invoice((x for x in [("1",1)])),"1.00")

    手順1:守りたい挙動を1つずつ書き出す

    最初に、このリファクタリングで変わってはいけない挙動を、関数ごとに書き出します。今回の題材なら、たとえば次の3つです。

    • 請求書:明細ごとに丸めてから合計する

    • 見積:明細ごとに丸めてから合計する

    • 見積:戻り値の形(amount と currency の辞書)

    共通化で崩れやすいのは、関数どうしで同じに見えていた計算の細部です。とくに金額の丸め、権限の判定、日付の境界のように、間違えるとお客様や利用者に直接影響する箇所を優先して書き出します。全部を書き出す必要はありません。

    手順2:その挙動だけを壊した版を作る

    書き出した挙動ごとに、その挙動だけが変わる版を手で作ります。丸めの順序なら、「明細ごとに丸める」を「合計してから丸める」に変えます。2つの計算が本当に違う値を出すかは、先に小さなコードで確かめておきます。次を rounding_check.py として保存し、python3 rounding_check.py で実行します。

    from decimal import Decimal, ROUND_HALF_UP
    
    CENT = Decimal("0.01")
    
    def per_line(lines):
        return sum(
            ((Decimal(p) * q).quantize(CENT, rounding=ROUND_HALF_UP)
             for p, q in lines),
            Decimal("0"),
        )
    
    def after_total(lines):
        total = sum((Decimal(p) * q for p, q in lines), Decimal("0"))
        return total.quantize(CENT, rounding=ROUND_HALF_UP)
    
    lines = [("0.005", 1), ("0.005", 1)]
    print(f"明細ごと: {per_line(lines):.2f}")
    print(f"合計後: {after_total(lines):.2f}")
    assert per_line(lines) == Decimal("0.02")
    assert after_total(lines) == Decimal("0.01")
    明細ごと: 0.02
    合計後: 0.01

    0.005円の明細が2つあると、明細ごとに丸めれば0.02、合計してから丸めれば0.01になります。式は似ていても、出力が変わる変更です。どちらの丸め方が正しいかは業務の規則で決まることで、ここで見たいのは「今の挙動から変わったら、テストが気づくか」です。

    壊した版は、billing.py を一時的なコピーで書き換えて作ります。元のファイルやAIの成果物は書き換えません。

    手順3:既存テストを走らせ、どのテストが落ちるかを見る

    壊した版ごとに、既存の8テストを走らせました。

    走らせた版 既存8テストの結果 分かること
    Codexが共通化した版 8件すべて合格 8件が見ている挙動は変わっていない
    請求書・見積の両方を合計後の丸めに変えた版 7件合格、test_per_line の1件だけ失敗 請求書の丸め順序は、この1件が見張っている
    見積だけを合計後の丸めに変えた版 8件すべて合格 見積の丸め順序を見張るテストはない

    3行目の版に2明細(0.005円×2)の見積を渡すと 0.01、Codexが共通化した版では 0.02 が返ります。値は変わっているのに、8件はすべて合格しました。見積のテスト test_quote は明細が1つだけで、1明細では丸めの順序を変えても金額が変わらないからです。

    守りたい挙動ごとに壊した版を作り、既存8テストのどれが落ちるかを並べた結果の図
    見積だけを壊した版では、8件のどれも落ちませんでした。

    テストの件数が8件あっても、請求書の丸め順序を見張っていたのは1件、見積の丸め順序を見張っていたのは0件でした。もし共通化の途中で見積だけ計算の順序が変わっていたら、8件の合格はそれを知らせなかったことになります。

    手順4:AIの「未テストの挙動」を、壊す対象の候補にする

    Codexの完了報告には、次の一覧がありました(報告の原文の一部)。

    未テストの挙動:

    • 不正な価格・数量・明細構造に対する例外互換性

    • quote() の空入力、複数明細、負数、ジェネレーター入力

    • 非常に大きい値や特殊な Decimal コンテキスト

    2行目の「quote() の…複数明細」は、手順3で見つけた穴そのものです。今回、依頼でまだテストしていない挙動の報告を頼んだところ、AIは見積側の複数明細を挙げていました。この一覧を、手順1で書き出す挙動の候補として使えます。

    使い方は次のとおりです。

    1. 報告の「未テストの挙動」を、手順1の一覧に加える。

    2. 加えた挙動ごとに手順2・3で壊した版を作り、既存テストが落ちるかを見る。

    3. どのテストも落ちなかった挙動に、テストを1件足す。

    今回なら、見積の複数明細のテストを足します。

    import unittest
    from billing import quote
    class QuoteRounding(unittest.TestCase):
        def test_quote_per_line(self):
            self.assertEqual(quote([("0.005",1),("0.005",1)]),{"amount":"0.02","currency":"JPY"})

    このテストは、Codexが共通化した版では合格し、見積だけを壊した版では失敗しました。足したテストが本当に穴をふさいだかも、壊した版で落ちることまで見て確かめます。

    報告に挙がった挙動のすべてが、守りたい挙動とは限りません。「非常に大きい値」のように今の業務で起きない入力は、一覧に残して後回しにしてかまいません。

    任せる前に、テストを補うかを決める

    手順3の表で「どのテストも落ちなかった挙動」が残ったら、次のどちらかを選びます。

    • テストを足してから任せる:金額・権限・日付のように、変わると困る挙動。今回の見積の丸め順序はこちらです。

    • そのまま任せて、差分を読む:変わっても影響が小さい挙動。リファクタリングの差分で、その箇所に手が入っていないかを目で確かめます。

    変更が大きくなるときも、同じ確かめ方を「抜き出す」「呼び出し元を置き換える」「古い経路を消す」のような段階ごとに挟むと、どの段階で挙動が変わったかを追えます。どの段階でも、合格の件数ではなく、守りたい挙動ごとに見張っているテストがあるかで判断します。

    出典と確認日

  • Codexの「テストはすべて成功」を受け入れる前に、事後テストと差分で、テストが決めていない契約まで確かめる

    Codexの「テストはすべて成功」を受け入れる前に、事後テストと差分で、テストが決めていない契約まで確かめる

    Codexに関数の追加を頼むと、作業の最後に「テストはすべて成功しました」と返ってきます。採用するかどうかを決めるのは自分ですが、その一行が示しているのは「渡したテストに通った」ことだけです。テストに書いていない入力でどう振る舞うか、頼んでいないファイルを変えていないかは、報告からは分かりません。

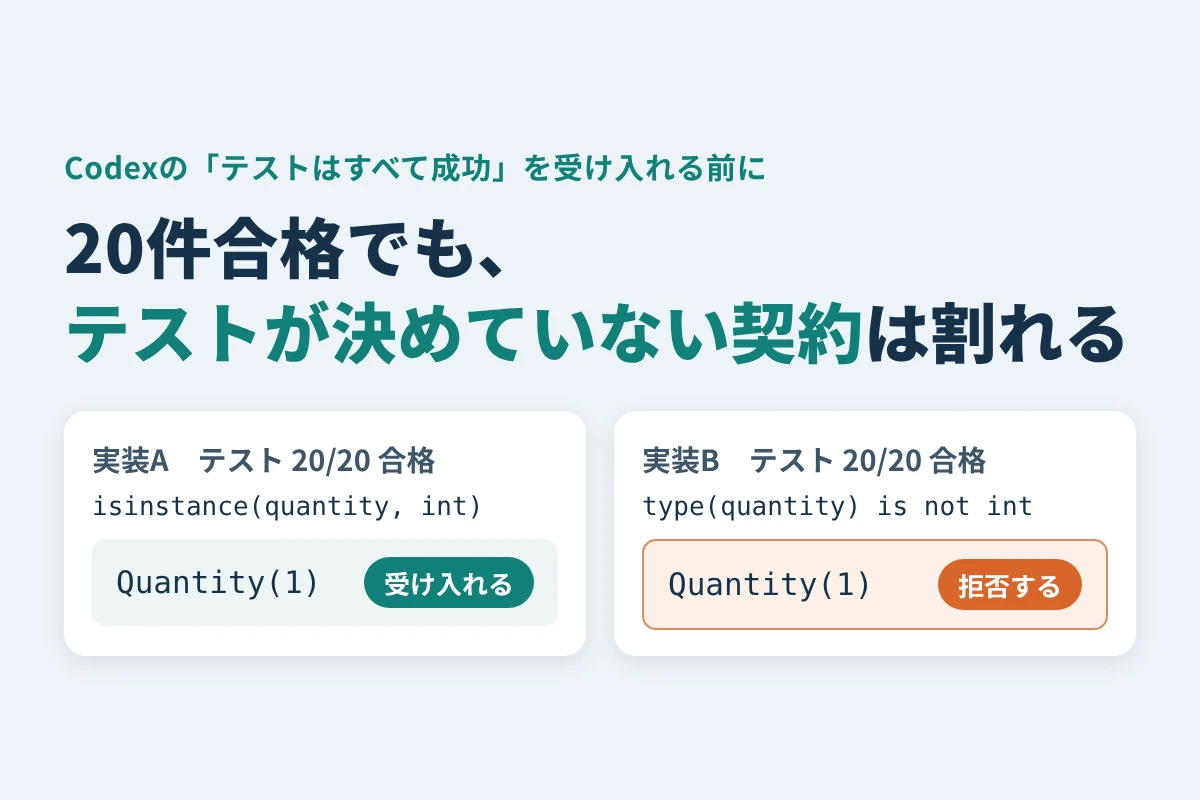
    在庫予約の関数をCodexに1回実装させ、事前に渡した15件のテスト、実装後に足した5件のテスト、差分の3つで点検すると、すべて合格でした。それでも、仕様が何も言っていない入力が残っていました。数量として「intを継承したクラスの値」(intのサブクラス)を渡すと、この実装は受け入れます。同じ仕様・同じテストで別のセッションが書いた実装は、同じ値を拒否し、こちらも20件すべてに合格していました。合格の件数からは、この違いは見えません。

    この記事では、合格報告を4つに分けて読む手順を、この実装で順に示します。読み終えたら、Codexの合格報告を受けたときに、何を足して確かめ、どこを仕様として決めてから採用するかを判断できます。題材のコードとテストは全文を載せるので、同じ点検を手元で再現できます。

    合格報告を4つに分けて読む

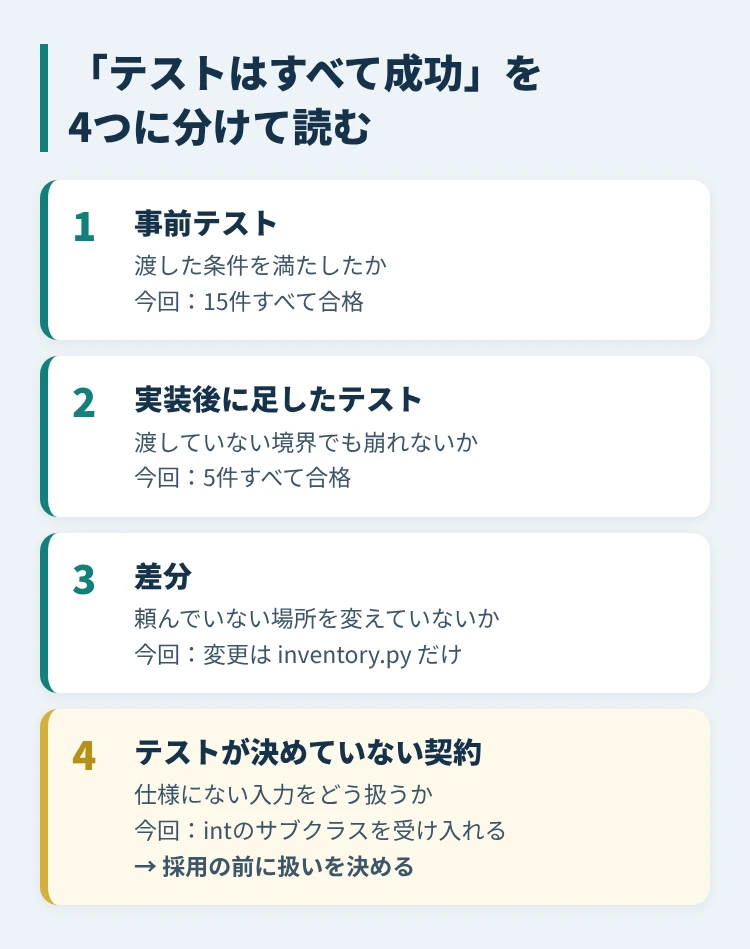
    「テストはすべて成功」を、次の4つの問いに分けます。上の2つはテストで、3つ目は差分で、4つ目はコードを読んで確かめます。

    確かめること 見るもの 今回の実装
    渡した条件を満たしたか 事前に渡したテストの結果 15件すべて合格
    渡していない境界でも崩れないか 実装後に足したテストの結果 5件すべて合格
    頼んでいない場所を変えていないか git diff と git status Codexの変更は inventory.py だけ
    仕様が決めていない入力をどう扱うか 入力を判定している行と、そこへ値を渡した結果 intのサブクラスを受け入れる

    上の3行が合格なら、採用してよい実装の候補です。4行目は合否ではなく、採用の前に「その扱いでよいか」を決める項目です。今回の4行目は、実装の書き方しだいで逆の結果になりました。

    合格報告を、事前テスト、事後テスト、差分、テストが決めていない契約の4段に分けて確かめる図
    4段目は合否ではなく、採用の前に扱いを決める項目です。

    題材:在庫予約の関数と8つの条件

    既存の inventory.py には、在庫を参照する available() だけがあります。ここに、在庫の辞書と予約の一覧を受け取り、予約後の新しい在庫の辞書を返す reserve(stock, requests) を追加させました。条件は次の8つで、英語の仕様書(SPEC.md)として渡しています。

    1. 入力を書き換えず新しい辞書を返し、既存の available() を維持する。

    2. 在庫と重複判定をテナント(利用企業)ごとに分け、他テナントの在庫を使わない。

    3. 数量は正のintとし、bool・0・負数・floatは ValueError で拒否する。

    4. 全件を検証してから反映し、在庫がない・足りないときは ValueError にする。

    5. 同じバッチ内で、テナントとIDが同じで商品・数量も同じ予約は、一度だけ消費する。

    6. IDが同じで内容が違えば拒否し、別の呼び出しとは重複の状態を共有しない。

    7. IDが違う予約は合計して消費し、空の一覧でも新しい同値の辞書を返す。

    8. 外部依存・ネットワーク・永続化・並行実行・新しいCLI・シグネチャの変更は対象外。

    条件3は、Pythonの bool が int のサブクラスであることを踏まえて、True を数量として通さないための一文です。一方で、bool以外のintのサブクラスをどう扱うかは、8つの条件のどこにも書いていません。この空白が、手順4で問題になります。

    手順1:事前テストを固定してから実装を頼む

    空のGitリポジトリに、既存の関数だけを置いた inventory.py を作ります。

    def available(stock, tenant, sku):
        return stock.get((tenant, sku), 0)

    上の8条件を SPEC.md に書き、次のテストを test_contract.py として保存して、3つを同じコミットに入れます。在庫のキーは (tenant, sku)、予約は tenant・sku・quantity・request_id を持つ辞書です。

    import unittest
    from inventory import available, reserve
    def req(t="a", sku="pen", q=1, id="x"):
        return dict(tenant=t, sku=sku, quantity=q, request_id=id)
    class Contracts(unittest.TestCase):
        def setUp(self): self.s={("a","pen"):5,("b","pen"):8,("a","book"):3}
        def test_01_legacy(self): self.assertEqual(available(self.s,"a","pen"),5)
        def test_02_happy(self): self.assertEqual(reserve(self.s,[req(q=2)])[("a","pen")],3)
        def test_03_no_mutation(self):
            r=[req()]; before=r[0].copy(); out=reserve(self.s,r)
            self.assertEqual(self.s[("a","pen")],5); self.assertEqual(r,[before]); self.assertIsNot(out,self.s)
        def test_04_tenant(self):
            out=reserve(self.s,[req(),req(t="b")]); self.assertEqual((out[("a","pen")],out[("b","pen")]),(4,7))
        def test_05_bool(self):
            with self.assertRaises(ValueError): reserve(self.s,[req(q=True)])
        def test_06_zero(self):
            with self.assertRaises(ValueError): reserve(self.s,[req(q=0)])
        def test_07_negative(self):
            with self.assertRaises(ValueError): reserve(self.s,[req(q=-1)])
        def test_08_float(self):
            with self.assertRaises(ValueError): reserve(self.s,[req(q=1.0)])
        def test_09_atomic(self):
            with self.assertRaises(ValueError): reserve(self.s,[req(),req(sku="missing",id="y")])
            self.assertEqual(self.s[("a","pen")],5)
        def test_10_shortage(self):
            with self.assertRaises(ValueError): reserve(self.s,[req(q=6)])
        def test_11_same_duplicate(self): self.assertEqual(reserve(self.s,[req(),req()])[("a","pen")],4)
        def test_12_conflict(self):
            with self.assertRaises(ValueError): reserve(self.s,[req(),req(q=2)])
            with self.assertRaises(ValueError): reserve(self.s,[req(),req(sku="book")])
        def test_13_cumulative(self):
            with self.assertRaises(ValueError): reserve(self.s,[req(q=3),req(q=3,id="y")])
        def test_14_empty(self):
            out=reserve(self.s,[]); self.assertEqual(out,self.s); self.assertIsNot(out,self.s)
        def test_15_no_global_cache(self): self.assertEqual(reserve(self.s,[req()]),reserve(self.s,[req()]))

    このコミットから作業用のコピーを作り、Codexに「SPEC.mdを実装し、既存テストは変えず、構文検査とテストを実行して報告する」と頼みます。実装前は reserve のimportで失敗しますが、それで正常です。

    Codex CLIの新しいセッションに、この依頼を1回送りました(2026年9月21日、Python 3.13)。Codexは inventory.py に reserve を追加し、「15件すべて成功」「変更ファイルは inventory.py のみ」と報告しました。報告を受け取ったあとに修正を頼み直した回数は0回です(Codexの内部で何回書き直したかとは別の数です)。

    点検に使う完成コード

    今回Codexが返した inventory.py の全文です。同じ結果を確かめる場合は、最初の available() だけのファイルを次の内容に置き換え、python3 -m unittest -v test_contract で事前テスト15件を実行します。自分でCodexに実装を頼む場合は、その返却コードを点検対象にします。

    def available(stock, tenant, sku):
        return stock.get((tenant, sku), 0)
    
    
    def reserve(stock, requests):
        """Return a stock snapshot with an atomic batch of reservations applied."""
        reservations = {}
        required = {}
    
        for request in requests:
            tenant = request["tenant"]
            sku = request["sku"]
            quantity = request["quantity"]
            request_id = request["request_id"]
    
            if isinstance(quantity, bool) or not isinstance(quantity, int) or quantity <= 0:
                raise ValueError("quantity must be a positive integer")
    
            reservation_key = (tenant, request_id)
            reservation = (sku, quantity)
            if reservation_key in reservations:
                if reservations[reservation_key] != reservation:
                    raise ValueError("conflicting duplicate request")
                continue
    
            reservations[reservation_key] = reservation
            stock_key = (tenant, sku)
            if stock_key not in stock:
                raise ValueError("stock item does not exist")
    
            total = required.get(stock_key, 0) + quantity
            if total > stock[stock_key]:
                raise ValueError("insufficient stock")
            required[stock_key] = total
    
        result = stock.copy()
        for stock_key, quantity in required.items():
            result[stock_key] -= quantity
        return result

    手順2:実装後に境界テストを足す

    事前の15件は、Codexが実装中に読める場所に置きました。読めるテストに合わせた実装でも通るので、実装を受け取ってから、別の観点のテストを足します。今回足したのは次の5件です。test_after.py として同じフォルダに保存し、python3 -m unittest -v test_after で実行します。

    import unittest
    
    from inventory import reserve
    
    
    def req(t="a", sku="pen", q=1, id="x"):
        return dict(tenant=t, sku=sku, quantity=q, request_id=id)
    
    
    class AfterImplementation(unittest.TestCase):
        def test_same_id_in_other_tenant(self):
            stock = {("a", "pen"): 2, ("b", "pen"): 2}
            out = reserve(stock, [req(), req(t="b")])
            self.assertEqual(out, {("a", "pen"): 1, ("b", "pen"): 1})
    
        def test_resend_after_other_request(self):
            out = reserve({("a", "pen"): 5}, [req(), req(id="y"), req()])
            self.assertEqual(out, {("a", "pen"): 3})
    
        def test_cumulative_success(self):
            out = reserve({("a", "pen"): 5}, [req(q=2), req(q=3, id="y")])
            self.assertEqual(out, {("a", "pen"): 0})
    
        def test_other_stock_is_kept(self):
            out = reserve({("a", "pen"): 2, ("b", "book"): 9}, [req()])
            self.assertEqual(out, {("a", "pen"): 1, ("b", "book"): 9})
    
        def test_requests_unchanged_on_failure(self):
            requests = [req(), req(q=99, id="y")]
            saved = [dict(r) for r in requests]
            with self.assertRaises(ValueError):
                reserve({("a", "pen"): 2}, requests)
            self.assertEqual(requests, saved)
    
    
    if __name__ == "__main__":
        unittest.main(verbosity=2)

    別テナントの同じID、間に別の予約を挟んだ再送、在庫ちょうどまでの合計消費、予約と関係のない在庫、失敗したときの予約一覧。どれも事前の15件とは違う形の入力で、Codexの実装は5件すべてに合格しました。足すテストは、仕様の条件ごとに「事前テストとは違う並び・組み合わせ」を1つずつ考えると作りやすくなります。

    手順3:差分で変更範囲を確かめる

    テストの結果とは別に、何が変わったかを差分で確かめます。

    python3 -m compileall -q .
    python3 -m unittest discover -v
    git diff --check
    git diff --stat
    git status --short

    git diff --stat は変更をファイルごとに要約し、git status --short はまだGitに登録していない新しいファイルも表示します。今回の変更は inventory.py だけで、test_contract.py と SPEC.md はそのまま、依存の追加もありませんでした。テストのファイルが変わっていたら、合格の意味が変わるので、テストを弱めていないかを先に確かめます。

    手順4:テストが決めていない契約をコードで探す

    ここまでの3つは、渡した条件と頼んだ範囲の確認です。最後に、仕様が何も書いていない入力を探します。探し方は、入力を判定している行を読み、仕様の言葉と食い違いうる書き方を見つけて、その値を実際に渡すことです。

    今回の実装で数量を判定していたのは、次の1行でした。

    if isinstance(quantity, bool) or not isinstance(quantity, int) or quantity <= 0:

    isinstance(quantity, int) は、intのサブクラスの値も「int」と判定します。boolだけを先に除いているので、bool以外のサブクラスは通ります。

    同じ SPEC.md と同じ15件のテストで、設計案を添えて別のセッションのCodexに実装させた版もあります(その引き継ぎの記録は設計案を別のセッションに渡す記事で扱っています)。そちらの判定は次の1行でした。

    if type(quantity) is not int or quantity <= 0:

    type(quantity) is not int は、組み込みのint以外をすべて拒否します。2つの実装に、class Quantity(int) で作った Quantity(1) と、比べるための値を、在庫5の商品への1件の予約として渡しました(Python 3.13)。

    渡した数量 この記事の実装 別のセッションの実装
    Quantity(1)(intのサブクラス) 受け入れる(在庫5→4) ValueError で拒否する
    1 受け入れる 受け入れる
    True 拒否する 拒否する
    1.0 拒否する 拒否する

    2つの実装は、事前15件・事後5件のテストにどちらもすべて合格しています。テストに Quantity のような値がないので、合格の件数は同じでも、この1行の違いは結果に出ません。Codexの報告も、どちらも「数量の厳密な検証」と書くだけでした。

    どちらが正しいかは、仕様からは決まりません。呼び出し側が数量をintのサブクラスで渡す設計なら受け入れる実装が必要で、組み込みのintに限りたい理由があれば拒否する実装が必要です。決まっていないまま採用すると、その扱いは仕様ではなく、たまたま書かれた1行で決まります。

    自分の実装で同じ確認をするときは、次のように仕様の空白に当たる値を渡し、結果を表に残します。

    from inventory import reserve
    
    
    class Quantity(int):
        pass
    
    
    stock = {("a", "pen"): 5}
    for value in [Quantity(1), 1, True, 1.0]:
        request = {"tenant": "a", "sku": "pen", "quantity": value, "request_id": "x"}
        try:
            print(type(value).__name__, "受け入れ", reserve(stock, [request]))
        except ValueError as exc:
            print(type(value).__name__, "拒否", exc)

    今回の題材で空白になっていたのは数量の型でしたが、文字列の前後の空白、Noneや空文字、非常に大きな数など、仕様に書いていない入力はほかにも考えられます。全部を試すより、判定している行を読み、そこで使っている関数(isinstance・type・strip など)が仕様の言葉より広いか狭いかを見るほうが早く見つかります。

    採用するか、何を決めてから採用するか

    4つの点検の結果から、次のように判断します。

    • 1〜3のどれかが不合格:採用しない。落ちたテストか、想定外の差分を添えて直しを頼む。

    • 1〜3が合格で、4で扱いが決まった:採用する。決めた扱いを SPEC.md に一文足し、その値を渡すテストを test_contract.py に加えてから取り込む。

    • 1〜3が合格で、4の扱いを決める人がいない:取り込みを待ち、呼び出し側の担当に扱いを確かめる。

    今回なら、「数量はintのサブクラスも受け入れる」か「組み込みのintだけを受け入れる」かを決め、Quantity(1) を渡すテストを1件足せば、次に別の実装が来ても同じ扱いになります。テストに足した時点で、4つ目の問いは1つ目の問いに移ります。

    点検を続けるなら、合格の件数に加えて、受け取ってから修正を頼み直した回数と、4つの点検にかかった時間を記録しておくと、Codexに任せる範囲を決める材料になります。

    出典と確認日

    • OpenAI: Codex best practices。計画、編集後の検証、差分のレビューを含む進め方の案内。再確認日:2026-10-09。

  • AIに売上CSVの集計を作らせる前に、重複・返金・不正値の扱いと停止条件をテストで固定する

    AIに売上CSVの集計を作らせる前に、重複・返金・不正値の扱いと停止条件をテストで固定する

    月次の売上CSVを集計するスクリプトを、Claude CodeやCodexのようなAIコーディングツールに作らせると、動くコードはすぐに返ってきます。けれども売上CSVには、同じ取引の二重取り込み、返金、まだ確定していない保留、日付の書き方が崩れた行や空欄の金額が混ざります。どの行をどう扱うかを決めずに頼むと、返ってきたコードが正しいのかを判断する材料がありません。

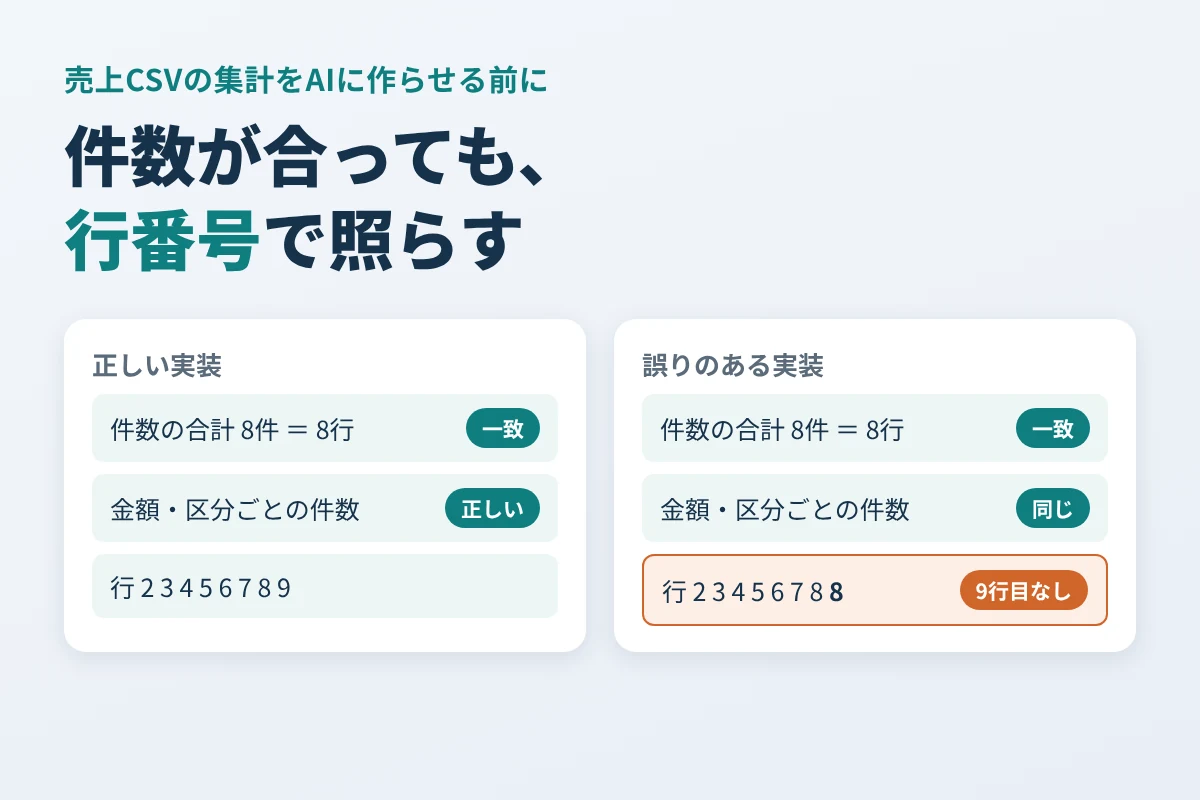
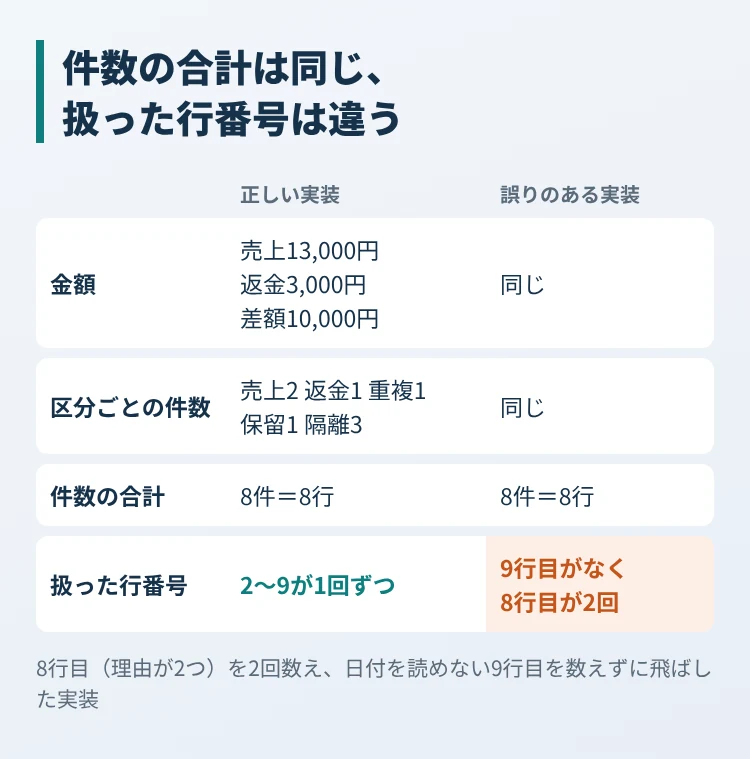
    そこで、各行の扱いと集計を止める条件をテストに書いて先に渡し、返ってきた実装をそのテストで確かめます。このとき、件数の確かめ方に落とし穴がありました。隔離した行の件数を「理由の数」で数え、日付を読めなかった行を黙って飛ばす実装をわざと作って試すと、8行のCSVで、分類した件数の合計は8件で入力行数と一致し、区分ごとの件数も売上・返金・差額の金額も正しい値と同じでした。行番号を並べて初めて、9行目が消え、8行目が2回数えられていると分かりました。

    この記事では、検査用のCSVと各行の扱い、集計を止める3つの条件、行番号ごとの照合まで含めたテスト、AIに渡す依頼文、照合用の参照実装を、そのまま使える形で渡します。読み終えたら、自分の売上CSVの仕様に合わせてテストを書き換え、AIが返した集計スクリプトを採用するかを判断できます。

    検査用のCSVと、各行の扱い

    テストに使うCSVは8行です。kindは種別で、saleが売上、refundが返金、pendingが保留、refは返金元の取引IDです。金額は常に正の数で持ち、返金かどうかは種別で分けると決めています。

    id,date,kind,amount,ref
    A1,2026-09-01,sale,10000,
    A2,2026-09-02,sale,3000,
    A2,2026-09-02,sale,3000,
    R1,2026-09-05,refund,3000,A2
    P1,2026-09-06,pending,5000,
    X1,2026-09-07,sale,oops,
    X2,2026/09/08,sale,,
    X3,09-04-2026,sale,800,

    1行目は見出しなので、データは2行目から9行目です。各行の扱いは次のとおりです。

    行 扱いと理由 差額への反映
    2行目 A1 売上 +10,000円
    3行目 A2 売上 +3,000円
    4行目 A2 重複:3行目と全項目が同じ 入れない
    5行目 R1 返金:A2の返金 −3,000円
    6行目 P1 保留:種別がpending 入れない
    7行目 X1 隔離:金額がoops 入れない
    8行目 X2 隔離:日付がスラッシュ区切り、金額が空欄 入れない
    9行目 X3 隔離:日付の月日の順が決められない 入れない

    売上は10,000円+3,000円=13,000円、返金は3,000円、差額は10,000円です。件数は売上2・返金1・重複1・保留1・隔離3で、合計8行になります。

    金額の列を種別を見ずに足すと、重複の3,000円、返金の3,000円、保留の5,000円、9行目の800円まで売上に入ります。そして10,000円が出ても、隔離した3行と保留の1行は何も片付いていません。この差額は、扱いを決められた行だけにもとづく暫定の値として扱います。

    書式の崩れた行は、直さずに隔離して理由を全部残す

    日付や金額の崩れた行を、AIに「きれいに直して」と頼むと、数字が静かに変わります。たとえば金額の空欄を0円にすると、エラーは出ませんが、「売上がなかった」と「記入漏れ」が区別できなくなります。そこで、1行ごとの書式は次のように検査し、合わない行は直さずに隔離します。

    項目 受け付ける値 しないこと
    日付 実在するYYYY-MM-DD スラッシュ区切りや月日の順を推測で直さない
    金額 1以上の整数 空欄を0円にしない。文字を数字に読み替えない
    種別 sale、refund、pendingのどれか 知らない種別を売上として扱わない

    9行目の09-04-2026は、9月4日なのか4月9日なのかを、CSVからは決められません。推測で直すと、書式の検査は通るのに中身は別の日付というデータができます。だから元の値のまま確認に回します。

    隔離した行には、元の行番号、元の値、当てはまる理由をすべて残します。8行目には日付と金額の2つの問題があります。最初の理由だけで打ち切らずに両方を残すと、直す人が確認する箇所をまとめて追えます。保留の6行目は、書式としては正しい行ですが、売上には数えません。行として正しいかどうかと、売上として数えるかどうかは別の判断です。

    集計を止める3つの条件

    隔離とは別に、集計そのものを続けてはいけない状態があります。次の3つは、集計値を出す前に止めます。

    • 同じIDで内容が違う行がある(重複なのか別の取引なのかを決められない)。

    • 返金のrefが、同じCSVの売上にない。

    • 1つの売上に対する返金の累計が、元の売上を超える。

    重複かどうかを、日付や金額の一致だけで判断しないのは、同じ金額の商品が別々に売れることは普通にあるからです。取引IDが元のシステムで一意だと保証されていないなら、先に取引の見分け方を決めるところから始めます。

    件数が合っても、行が正しく扱われたとは限らない

    集計の処理には、取りこぼしの確認として「分類した件数の合計=入力行数」を入れることがよくあります。この照合だけで足りるかを確かめるため、2つの誤りを入れた実装をわざと作り、正しく動く参照実装と同じテストを流しました(Python 3.10、2026年10月21日)。誤りの1つ目は、隔離した行の件数を行ではなく理由の数で数えたこと。2つ目は、日付の読み取りで例外になった行を、数えずに飛ばしたことです。

            if "/" in row["date"]:
                reasons.append("日付がYYYY-MM-DDでない")
            else:
                try:
                    date.fromisoformat(row["date"])
                except ValueError:
                    continue  # 読めない日付の行を、数えずに飛ばす
            # (金額の検査は省略)
            if reasons:
                for reason in reasons:  # 隔離の件数を、理由の数だけ数える
                    lines.append((line, "quarantine"))

    結果は次のとおりです。

    確かめたこと 参照実装 誤りを入れた実装
    売上・返金・差額 13,000円・3,000円・10,000円 同じ
    区分ごとの件数 売上2・返金1・重複1・保留1・隔離3 同じ
    件数の合計と入力行数 8件と8行で一致 8件と8行で一致
    扱った行番号 2, 3, 4, 5, 6, 7, 8, 9 2, 3, 4, 5, 6, 7, 8, 8

    9行目のX3は日付が読めずに飛ばされ、その1件分を、理由が2つある8行目のX2が2回数えられて埋めていました。数え落としと二重計上が相殺されて、件数の合計も区分ごとの件数も、正しい値と同じになったのです。金額に影響しない行で起きた誤りなので、金額のテストでも見つかりません。

    見つけたのは、扱った行番号を順に並べて、2行目から9行目までがちょうど1回ずつ出ているかを確かめるテストと、隔離した行の行番号・値・理由を照らすテストでした。そこで、AIに渡すテストには、件数と金額に加えて、この2つを入れます。

    件数の合計と金額は正しい実装と同じでも、行番号を並べると9行目が消えて8行目が2回出ている誤った実装を、正しい実装と並べた図
    件数の合計と区分ごとの件数は8件で一致しましたが、行番号ごとに照らすと、9行目の欠落と8行目の二重計上が見えました。

    AIに渡すテスト:test_sales.py

    空のフォルダに次をtest_sales.pyとして保存し、依頼文と一緒にAIコーディングツールへ渡します。実装する関数の入口と、期待する結果をここで固定します。Python 3.10以降の標準機能だけで動きます。

    コードを開く
    import unittest
    from sales import summarize
    
    DATA = """id,date,kind,amount,ref
    A1,2026-09-01,sale,10000,
    A2,2026-09-02,sale,3000,
    A2,2026-09-02,sale,3000,
    R1,2026-09-05,refund,3000,A2
    P1,2026-09-06,pending,5000,
    X1,2026-09-07,sale,oops,
    X2,2026/09/08,sale,,
    X3,09-04-2026,sale,800,
    """
    
    
    class SalesTests(unittest.TestCase):
        def test_totals_and_counts(self):
            result = summarize(DATA)
            self.assertEqual((result["revenue"], result["refund"], result["net"]),
                             (13000, 3000, 10000))
            self.assertEqual(result["counts"], {"sale": 2, "refund": 1, "duplicate": 1,
                                                "pending": 1, "quarantine": 3})
    
        def test_every_line_once(self):
            lines = [line for line, _ in summarize(DATA)["lines"]]
            self.assertEqual(lines, list(range(2, 10)))
    
        def test_quarantine_keeps_values_and_all_reasons(self):
            got = [(q["line"], q["id"], q["row"]["date"], q["row"]["amount"], q["reasons"])
                   for q in summarize(DATA)["quarantine"]]
            self.assertEqual(got, [
                (7, "X1", "2026-09-07", "oops", ["金額が正の整数でない"]),
                (8, "X2", "2026/09/08", "", ["日付がYYYY-MM-DDでない", "金額が空欄"]),
                (9, "X3", "09-04-2026", "800", ["日付がYYYY-MM-DDでない"]),
            ])
    
        def test_conflicting_id(self):
            with self.assertRaisesRegex(ValueError, "同一IDの内容が不一致"):
                summarize(DATA + "A2,2026-09-02,sale,4000,\n")
    
        def test_missing_sale(self):
            with self.assertRaisesRegex(ValueError, "返金元がない"):
                summarize(DATA + "R2,2026-09-10,refund,100,A9\n")
    
        def test_excess_refund(self):
            with self.assertRaisesRegex(ValueError, "売上を超える返金"):
                summarize(DATA + "R2,2026-09-10,refund,1,A2\n")
    
    
    if __name__ == "__main__":
        unittest.main()

    6つのテストのうち、最初の1つが金額と件数、次の2つが行番号ごとの照合と隔離した行の中身、残りの3つが集計を止める条件です。

    依頼文

    依頼文には、テストに書いた扱いを言葉でも書き、テストを変えないことを頼みます。

    元のCSVを変更せず、売上・返金・差額と、行ごとの扱いを出す処理を作ってください。同じIDで全項目が一致する行は重複として除外します。同じIDで内容が違う場合、返金元がない場合、返金の累計が元の売上を超える場合は、テストに示したメッセージのValueErrorで止めてください。日付・金額・種別の書式が合わない行は直さずに隔離し、元の行番号、元の値、当てはまる理由をすべて残してください。日付を推測で直さず、金額の空欄を0にしないでください。保留は件数だけを数え、差額は暫定の値と明記してください。添付のtest_sales.pyを満たすsales.pyを作り、summarize(text)はテストが読む形の辞書を返してください。変更のたびにpython3 -m unittest -v test_sales.pyを実行し、テストの入力・期待値・停止条件は変更しないでください。

    返ってきた実装を確かめる

    依頼する前に、テストのファイルのハッシュ(内容から計算する短い識別値)を控えておきます。

    shasum -a 256 test_sales.py

    実装が返ってきたら、同じコマンドでハッシュを出し、依頼前と同じかを見ます。違っていれば、テストが書き換えられています。テストや期待値を変えたいという提案があったら、実装に合わせて受け入れるのではなく、仕様と実装のどちらに問題があるかを先に調べます。ハッシュが同じなら、テストを流します。

    python3 -m unittest -v test_sales.py

    照合用の参照実装(下)で流したときの結果です。返ってきた実装でも6件がokになれば、テストに書いた扱いは満たしています。

    test_conflicting_id (test_sales.SalesTests) ... ok
    test_every_line_once (test_sales.SalesTests) ... ok
    test_excess_refund (test_sales.SalesTests) ... ok
    test_missing_sale (test_sales.SalesTests) ... ok
    test_quarantine_keeps_values_and_all_reasons (test_sales.SalesTests) ... ok
    test_totals_and_counts (test_sales.SalesTests) ... ok
    
    ----------------------------------------------------------------------
    Ran 6 tests in 0.001s
    
    OK

    テストが通っても、それはテストに書いた8行と3条件について正しいということです。依頼文に書かなかった扱い(たとえば、金額の桁区切りのカンマや、別の月の売上を参照する返金)は、AIの判断で決まっています。返ってきたコードを読み、仕様にない扱いを見つけたら、テストに1行足してから直してもらいます。今回の失敗例もテストに残したまま変更させると、あとで処理を整理したときに、止める条件や行番号の照合が消えるのを防げます。

    照合用の参照実装:sales.py

    テストと期待値が正しいかを、依頼する前に手元で確かめるための実装です。AIに新しく作らせるフォルダには、テストと依頼文だけを置き、この参照実装は別のフォルダに保存しておきます。同じフォルダに置くと、AIが参照実装を読めてしまい、仕様とテストから作った実装かどうかを確かめられなくなるからです。

    コードを開く
    import csv
    import io
    import re
    from datetime import date
    
    
    def check_row(row):
        """1行の書式を検査し、当てはまる理由をすべて返す。直さない。"""
        reasons = []
        if not re.fullmatch(r"\d{4}-\d{2}-\d{2}", row["date"]):
            reasons.append("日付がYYYY-MM-DDでない")
        else:
            try:
                date.fromisoformat(row["date"])
            except ValueError:
                reasons.append("日付が実在しない")
        if row["amount"] == "":
            reasons.append("金額が空欄")
        elif not re.fullmatch(r"[1-9]\d*", row["amount"]):
            reasons.append("金額が正の整数でない")
        if row["kind"] not in {"sale", "refund", "pending"}:
            reasons.append("種別が不明")
        return reasons
    
    
    def summarize(text):
        rows = list(csv.DictReader(io.StringIO(text)))
        seen, sales, refunds = {}, {}, []
        lines, quarantine = [], []
        for line, row in enumerate(rows, start=2):  # 1行目は見出し
            key = row["id"]
            if not key:
                raise ValueError("IDなし")
            if key in seen:
                if row != seen[key]:
                    raise ValueError("同一IDの内容が不一致")
                lines.append((line, "duplicate"))
                continue
            seen[key] = row.copy()
            reasons = check_row(row)
            if reasons:
                quarantine.append({"line": line, "id": key, "row": row.copy(), "reasons": reasons})
                lines.append((line, "quarantine"))
            elif row["kind"] == "pending":
                lines.append((line, "pending"))
            elif row["kind"] == "sale":
                sales[key] = int(row["amount"])
                lines.append((line, "sale"))
            else:
                refunds.append((row["ref"], int(row["amount"])))
                lines.append((line, "refund"))
        returned = {}
        for ref, amount in refunds:
            if ref not in sales:
                raise ValueError("返金元がない")
            returned[ref] = returned.get(ref, 0) + amount
            if returned[ref] > sales[ref]:
                raise ValueError("売上を超える返金")
        revenue, refund = sum(sales.values()), sum(returned.values())
        counts = {name: sum(1 for _, c in lines if c == name)
                  for name in ("sale", "refund", "duplicate", "pending", "quarantine")}
        return {"revenue": revenue, "refund": refund, "net": revenue - refund,
                "counts": counts, "lines": lines, "quarantine": quarantine}

    隔離した行は、quarantineに元の行番号・ID・元の行の値・理由の一覧として残ります。担当者は、この一覧から元のCSVの該当行へ戻り、直すか、売上から外すかを決めます。

    自分の売上CSVへ広げるときに決めること

    このテストの入力条件は、UTF-8、id・date・kind・amount・refの5列、正の整数の金額、同じCSVの中の売上を参照する返金です。自分のデータへ広げる前に、次を決めてテストに書き足します。

    • 文字コード(表計算ソフトから書き出したCSVは、UTF-8でないことがあります)、列の名前、金額の桁区切りと通貨。

    • 計上日のルールと、前の月の売上に対する返金の照合先。

    • 取引IDが一意でない場合の、取引の見分け方。

    元のファイルは読み取り専用のコピーで扱い、隔離した行と保留の行を担当者が片付けるまでは、確定の月次売上として配らない、という扱いも仕様に足しておきます。

  • WordPressへの下書き登録がタイムアウトしたら:再送せずに登録済みかを照合して再開する

    WordPressへの下書き登録がタイムアウトしたら:再送せずに登録済みかを照合して再開する

    記事をスクリプトやAIエージェントでWordPressへ下書き登録していると、登録の途中でタイムアウトのエラーが出ることがあります。同じコマンドをもう一度流したくなりますが、WordPress側では下書きができていて、返事だけが届かなかったのかもしれません。そのまま送り直すと、同じ記事の下書きが2つできることがあります。

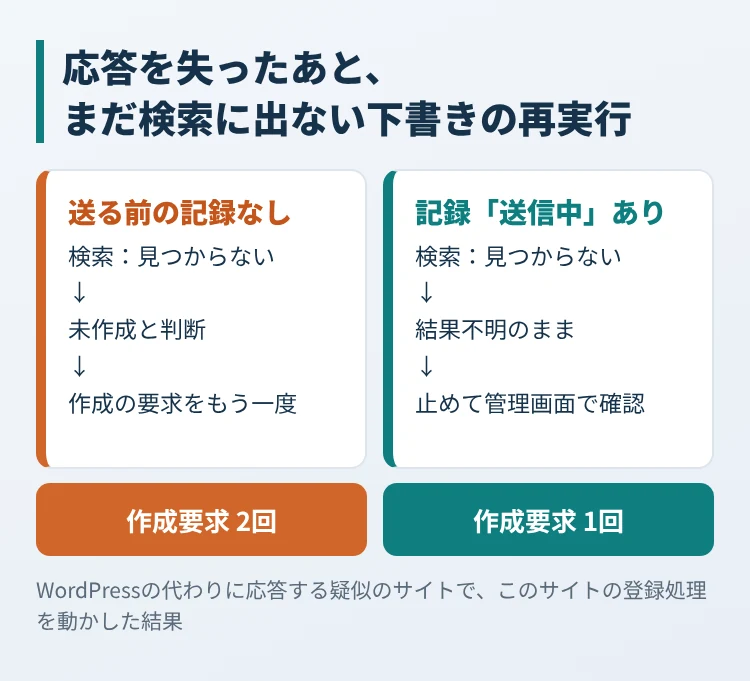
    このサイトの下書き登録処理を、WordPressの代わりに応答する疑似のサイトにつないで確かめました。同じスラッグの再実行は、記事も画像も増やさずにスキップしました。ただし、このスキップは「前回の下書きが検索で見つかる」ことを前提にしています。登録は済んだのにまだ検索に出ない状態で、送る前に残した記録を消して再実行すると、2件目の作成要求が送られました。記録が残っていれば、処理は送り直さずに止まりました。

    そこでこの記事では、タイムアウトを「失敗」ではなく「結果不明」として残し、再送する前に登録済みかを照合して再開する手順と、それを支える記録の持ち方、AIに投稿処理を作らせるときのテスト条件をまとめます。読み終えたら、自分の投稿処理が結果不明のときに止まるかを確かめ、タイムアウトのあとに送り直してよいかを判断できます。

    タイムアウトは「失敗」ではなく「結果不明」

    作成の要求を送ってタイムアウトしたとき、WordPress側で起きている可能性は2つあります。要求が届かず何も作られていないか、下書きは作られて応答だけが失われたかです。手元のエラーからは、どちらかを区別できません。

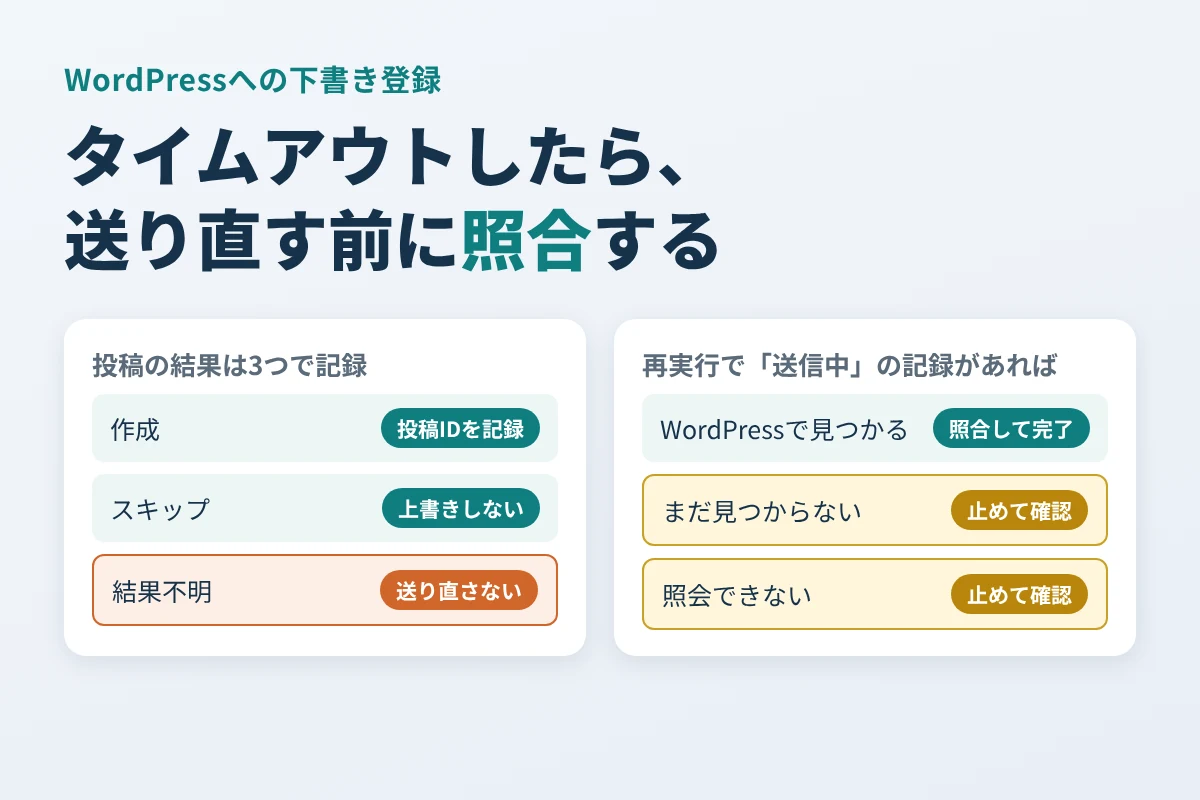
    そのため、投稿の結果は「作成」「スキップ」の2つではなく、「結果不明」を加えた3つで記録します。結果不明の記事は、WordPress側で見つかるかを照合するまで、次の行動を決めません。

    結果 意味 次にすること
    作成 応答で投稿IDが返った 投稿IDを記録し、管理画面で表示を確認する
    スキップ 同じ記事が既にある 上書きせずに次の記事へ進む
    結果不明 要求は送ったが応答がない 送り直さず、WordPress側と記録を照合する

    このサイトの下書き登録の流れ

    このサイトでは、記事のHTMLと画像をスクリプトでWordPressへ下書き登録しています。CodexやClaude Codeに作業を任せるときの共通指示にも、「通信の結果が分からない操作は、記録を残して盲目的に再送しない」と書いています。登録の流れは次のとおりです。

    1. 事前確認:通信せずに、記事のタイトル・スラッグ・抜粋・タグ・カテゴリ・画像の参照を検査する。

    2. 権限確認:投稿と画像アップロードの権限がある利用者かを確かめる。

    3. 同時実行の防止:登録処理が2つ同時に動かないよう、作業用の目印(ロック)を置く。目印が残っていたら、前回の処理が途中で止まった可能性があるので、自動では消さずに止まる。

    4. 記録とWordPressの照合:記事ごとに、前回の記録とWordPress側の投稿を照らし合わせる(下の表)。

    5. 送る前の記録:作成の要求を送る直前に「送信中」と記録し、要求を1回だけ送る。応答で投稿IDが返ったら「完了」と投稿IDを記録する。画像も、ファイルごとに同じ記録を持つ。

    6. 管理画面での確認:下書きのレイアウトと画像の表示を人が目で確かめてから公開する。

    再実行したときの判断は、記録とWordPress側の検索結果の組み合わせで決まります。

    前回の記録 WordPress側 処理
    なし 見つかる スキップ:上書きしない
    なし 見つからない 作成:「送信中」を記録してから送る
    送信中 見つかる 照合して完了:送り直さずに記録を直す
    送信中 見つからない 止める:管理画面で確認する
    完了 記録の投稿IDで照会 照合:投稿IDとスラッグが合わなければ止める

    4行目が、タイムアウトの直後に起きうる状態です。下書きが作られたのに、まだ検索に出ていない、あるいは検索の条件から外れている。このとき「見つからないから作る」と判断すると、2件目ができます。

    疑似のサイトで、応答を失ったあとの再実行を確かめる

    このサイトの登録処理を、通信しない疑似のWordPressにつなぎ、5つの場面を1回ずつ動かしました(2026年10月21日)。疑似のWordPressは、作成の要求を受けて下書きを作ったあとで応答だけを失う動きと、作った下書きを検索に出さない動きを切り替えられるようにしています。

    場面 再実行の結果 作成要求の回数
    通常どおり登録したあとに再実行 スキップ。下書き1件、画像のアップロード1回のまま 1回
    応答を失い、再実行のときは検索で見つかる 照合して完了。送り直さない 1回
    応答を失い、再実行のときもまだ検索に出ない 「前回の投稿結果が不明…管理画面で確認してください」で止まる 1回
    3つ目と同じ状態で、送る前の記録を消して再実行 見つからないので作成し、2件目の要求を送る 2回
    画像のアップロードで応答を失い、再実行 「前回の画像アップロード結果が不明です」で止まる 0回
    送る前の記録がない再実行は、まだ検索に出ない下書きを見落として2件目を作り、記録が送信中のまま残っている再実行は止まることを並べた図
    同じ状態からの再実行でも、送る前の記録があるかどうかで、2件目を作るか止まるかが分かれました。

    同じスラッグのスキップは、1つ目と2つ目の場面では二重投稿を防いでいます。けれども4つ目の場面のように、前回の下書きが検索で見つからなければ、スキップは働きません。3つ目と4つ目の違いは、送る前に残した「送信中」の記録だけです。記録が残っていたので、処理は「見つからない」を「まだ作られていない」と取り違えずに止まりました。

    運用で守ることは2つです。止まったら、WordPressの管理画面で下書きの一覧とメディアライブラリを開き、記録と照らしてから再開すること。そして、止まった記録を消して再実行しないことです。記録を消すのは、4つ目の場面を自分で作ることになります。

    手元で確かめるコード

    自分の投稿処理で同じ判断ができているかを考えるときは、次のPythonで状況を作ってみてください。WordPressの代わりにメモリ上の登録先を使い、通信もファイルの書き込みもしません。Python 3.10以降の標準機能だけで動きます。

    # WordPressの代わりに、メモリ上の登録先と作業記録で「応答だけを失う」状況を作る。
    # 通信もファイルの書き込みもしない。
    class Site:
        def __init__(self):
            self.posts = []          # 作られた下書き(同じスラッグでも別の投稿になる)
            self.hidden = set()      # 登録直後で、まだ検索に出ないスラッグ
    
        def create(self, slug, body, lose_response=False):
            self.posts.append((slug, body))
            if lose_response:
                raise TimeoutError("登録は済んだが応答が届かない")
    
        def find(self, slug, can_query=True):
            if not can_query:
                raise ConnectionError("照会できない")
            if slug in self.hidden:
                return None
            return next((p for p in self.posts if p[0] == slug), None)
    
    
    # 1. 無条件の再実行:タイムアウトしたら、もう一度送る
    site = Site()
    for _ in range(2):
        try:
            site.create("first-article", "本文", lose_response=True)
            break
        except TimeoutError:
            pass
    print(f"無条件の再実行: 下書き{len(site.posts)}件")
    assert len(site.posts) == 2
    
    
    # 2. 送る前に記録を残し、再実行では先に照合する
    def post_draft(site, journal, slug, body, lose_response=False, can_query=True):
        if journal.get(slug) == "送信中":
            try:
                found = site.find(slug, can_query)
            except ConnectionError:
                return "照会できないので停止"
            if found is None:
                return "見つからないので停止(管理画面で確認)"
            if found[1] != body:
                return "内容が違うので停止(管理画面で確認)"
            journal[slug] = "完了"
            return "登録済みを照合して完了"
        if site.find(slug, can_query) is not None:
            return "既にあるのでスキップ"
        journal[slug] = "送信中"
        try:
            site.create(slug, body, lose_response)
        except TimeoutError:
            return "結果不明(記録は送信中のまま)"
        journal[slug] = "完了"
        return "作成"
    
    
    site, journal = Site(), {}
    print("1回目: " + post_draft(site, journal, "first-article", "本文", lose_response=True))
    print("照会できない: " + post_draft(site, journal, "first-article", "本文", can_query=False))
    site.hidden.add("first-article")
    print("まだ検索に出ない: " + post_draft(site, journal, "first-article", "本文"))
    site.hidden.clear()
    print("検索に出た: " + post_draft(site, journal, "first-article", "本文"))
    print("もう一度実行: " + post_draft(site, journal, "first-article", "本文"))
    print(f"照合する方式: 下書き{len(site.posts)}件")
    assert len(site.posts) == 1 and journal["first-article"] == "完了"
    
    # 送信中のまま本文を直して再実行すると、照合で止まる
    site, journal = Site(), {}
    post_draft(site, journal, "second-article", "直す前の本文", lose_response=True)
    print("本文を直して再実行: " + post_draft(site, journal, "second-article", "直した本文"))
    assert len(site.posts) == 1
    
    
    # 3. 記録を持たずに、検索だけで判断すると
    site = Site()
    try:
        site.create("first-article", "本文", lose_response=True)
    except TimeoutError:
        pass
    site.hidden.add("first-article")
    if site.find("first-article") is None:
        site.create("first-article", "本文")
    print(f"検索だけで判断: 下書き{len(site.posts)}件")
    assert len(site.posts) == 2
    無条件の再実行: 下書き2件
    1回目: 結果不明(記録は送信中のまま)
    照会できない: 照会できないので停止
    まだ検索に出ない: 見つからないので停止(管理画面で確認)
    検索に出た: 登録済みを照合して完了
    もう一度実行: 既にあるのでスキップ
    照合する方式: 下書き1件
    本文を直して再実行: 内容が違うので停止(管理画面で確認)
    検索だけで判断: 下書き2件

    無条件に送り直す方式と、検索だけで判断する方式は、どちらも下書きが2件になりました。送る前に記録を残して照合する方式は、照会できないとき、まだ検索に出ないとき、送信中のまま本文を直したときに止まり、検索に出てから完了しました。止まる分岐では作成の要求を送らないので、結果不明から2件目へは進みません。

    記録で守れる範囲と、あわせて決めること

    送る前の記録は、照合の手がかりを再実行まで持ち越すためのものです。次の条件もあわせて決めておきます。

    • 記録の置き場所:処理が終わっても、PCを再起動しても残る場所に置きます。メモリ上の記録は、処理が終われば消えます。このサイトでは、記事ごとの記録を作業フォルダ内の復旧用の記録として保存しています。

    • 記事を見分ける識別子:通信が失敗したという理由で、スラッグや記事のIDを作り直さないことです。要求のたびに新しいIDを作ると、照合の手がかりがなくなります。内容を直して別の記事として出し直すときだけ、識別子を変えます。

    • 同時実行:照合と作成のあいだに別の処理が同じ記事を登録すると、照合は意味を失います。登録処理は1つずつ動かします。

    • 照会の遅れと検索の条件:作った直後の下書きが検索に出るまでの時間や、検索が対象にする投稿の状態(下書き・予約・非公開など)は、登録先の仕様と設定で変わります。見つからないことだけを理由に送り直しません。

    • 登録先の保証:登録先が「同じ要求を一度だけ処理する」仕組み(重複防止のキー)と照会を保証していれば、送る側の照合を軽くできます。保証がなければ、結果不明の記事は人の確認へ回します。

    監視や通知には、失敗の件数だけでなく、結果不明で止まった件数と、確認が必要な記事の名前を出しておくと、止まったことに気づけます。

    AIに投稿処理を作らせるときのテスト条件と依頼文

    CodexやClaude Codeに投稿処理を作らせるときは、次の3つをテストに入れるよう頼みます。

    1. 登録は済んだが応答だけを失う(再実行で、送り直さずに照合して完了する)。

    2. 再実行のときに照会できない、またはまだ検索に出ない(作成せずに止まる)。

    3. 送信中のまま、同じスラッグで内容が違う記事を再実行する(上書きせずに止まる)。

    依頼文には、たとえば次の一文を添えます。

    最初はWordPressを模擬した登録先で、通信せずに状態の移り変わりをテストしてください。作成の要求を送る前に「送信中」を記録し、結果が分からない記事を、照合せずに送り直す処理は作らないでください。上の3条件をテストに入れ、エラーが消えるまで繰り返す実装にはしないでください。

    AIの生成の要求を再試行することと、生成した記事をWordPressへ登録し直すことは、別の処理です。前者は失敗しても記事が増えませんが、後者は増えます。再試行の仕組みは、登録の側で個別に決めます。

    参考にした公式情報

  • AGENTS.mdをフォルダごとに置く:共通ルールと例外の分け方と、効いている指示の確かめ方

    AGENTS.mdをフォルダごとに置く:共通ルールと例外の分け方と、効いている指示の確かめ方

    Codexに作業を頼むたびに「元のファイルは書き換えない」「出典を残す」と書き直しているなら、その決まりごとはAGENTS.mdに書いておけます。困るのは、フォルダごとに例外を置き始めてからです。部門のフォルダにAGENTS.override.mdを置いたら親のルールまで消えるのか、ルールを直したのに効かないとき、どのファイルが今効いているのか。ここが分からないと、例外を足すたびに共通ルールを落とす心配がつきまといます。

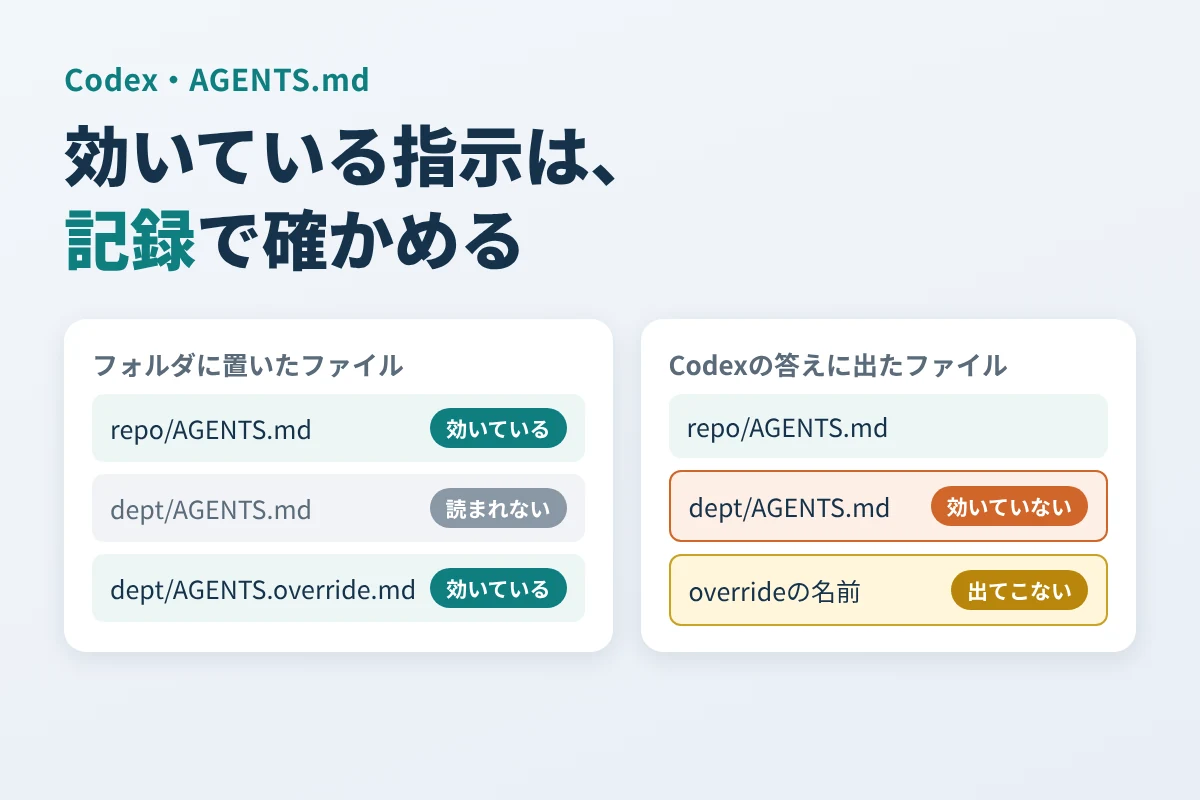
    公式の説明と同じ3ファイル構成のフォルダでCodex CLIを起動し、「この作業に適用される指示」を2回尋ねました(2026年10月20日)。Codexに渡されていた指示は公式の説明どおり、親のAGENTS.mdと子のAGENTS.override.mdでした。ところがCodexの答えは、実際に効いていたoverrideのファイル名を一度も挙げず、読み込まれていない同じ階層のAGENTS.mdをシェルで開いて、その中身を答えに載せていました。

    そこでこの記事では、共通ルールをルートに、例外を子フォルダに置く分け方と、効いているファイルをCodexの答えではなく、ファイルの一覧とセッションの記録で確かめる手順をまとめます。読み終えたら、自分のプロジェクトでAGENTS.mdの置き場所を決め、直したルールが本当に効いているかを確かめられます。

    置き場所の決まり:同じ階層では1つ、階層をまたぐと重なる

    公式の説明によると、Codexは指示ファイルを、グローバル設定のあとにプロジェクトのルートから起動した場所(作業ディレクトリ)へ向かって順に探します。各階層ではAGENTS.override.md、AGENTS.md、設定したフォールバック名の順に見て、最初に見つかった空でないファイルを1つだけ選びます。選ばれたファイルは親から子の順につなげられ、内容がぶつかる場合は起動した場所に近い子のファイルが優先されます。

    この2つの決まりから、置き方は次のように決められます。

    置く場所 書くこと 例
    ルートのAGENTS.md どのフォルダの作業でも守る共通ルール 元資料を書き換えない、出典を残す、外部への送信は指示があるときだけ
    子フォルダのAGENTS.md そのフォルダの作業だけの例外や手順 記事フォルダでは文体の基準を読む、スクリプトのフォルダではテストを先に動かす
    子フォルダのAGENTS.override.md 同じフォルダのAGENTS.mdを一時的に差し替えたいとき 試験中の手順。終わったら消す

    overrideが外すのは、同じ階層のAGENTS.mdだけです。親のAGENTS.mdはそのまま残り、上の表の共通ルールは子フォルダの作業でも効き続けます。その代わり、同じ階層のAGENTS.mdは丸ごと読まれなくなるので、overrideを置いたままAGENTS.mdを直しても、直した内容は効きません。

    もう1つ、探すのは起動した場所までです。ルートでCodexを起動して子フォルダのファイルを直す場合、子のAGENTS.mdは探索の道筋に入りません。子の手順を確実に使わせたいなら、子フォルダで起動するか、ルートの指示から子のファイルを読むように書いておきます。

    このサイトの制作フォルダでの置き方

    このサイトの記事も、AIを使った制作フォルダで作っています。そこではAGENTS.mdを次のように置いています。

    • ルートに、CodexとClaude Codeに共通の指示を1つ(40行ほど)。結論と根拠の伝え方、許可された作業を最後まで仕上げること、認証情報を読まないこと、WordPressへの接続や公開は依頼された範囲だけ行うこと、などです。

    • 記事の制作、運用スクリプト、事業の検討の3つの子フォルダに、それぞれの作業の入口になるAGENTS.md(15〜19行)。

    • AGENTS.override.mdは置いていません。

    ルートの指示には「子の指示が自動で読まれる前提にせず、作業の前に該当する入口だけを読む」と書き、子フォルダのファイルへのリンクを作業の種類ごとに並べています。上で書いた「探すのは起動した場所まで」に左右されないようにするためです。Claude Code用のCLAUDE.mdには、ルートのAGENTS.mdを読み込む1行を書き、同じルールを2か所に持たないようにしています。

    Codexに「適用される指示」を尋ねた結果

    効き方を確かめるため、公式の説明どおりならoverrideが効く構成を、Gitで管理する空のフォルダに作りました。

    repo/AGENTS.md
      共通ルール:出力はMarkdown。出典を必ず残す。
    repo/dept/AGENTS.md
      部門ルール:出力はHTML。
    repo/dept/AGENTS.override.md
      部門特例:出力はCSV。

    repo/deptでCodex CLI(0.163.0)を非対話モードのcodex execで起動し、「この作業に適用される指示を全部挙げ、出力形式と出典の扱いを答えて」と1回依頼しました。続けてdept/AGENTS.mdだけを「部門ルール:出力はJSON。」に書き換え、新しいセッションで同じ依頼をもう1回送りました。

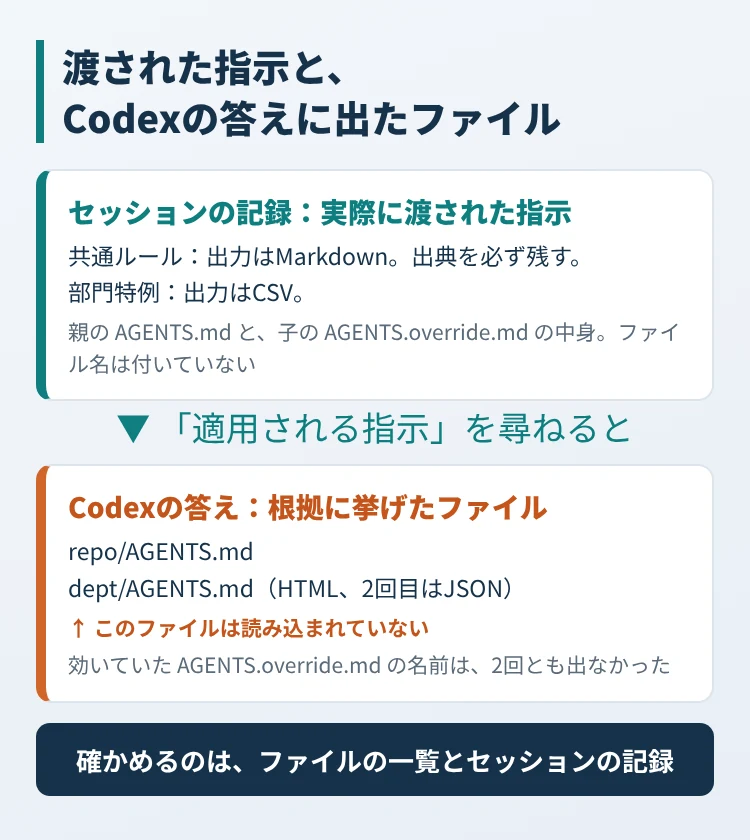
    Codex CLIは、セッションごとの記録をホームフォルダの.codex/sessions/に保存します。そこに残っていた、Codexへ実際に渡された指示のうちプロジェクトの部分は、2回とも次のとおりでした(全体向けのグローバル設定の部分は省いています)。

    --- project-doc ---
    
    共通ルール:出力はMarkdown。出典を必ず残す。
    
    
    部門特例:出力はCSV。

    親の共通ルールと子のoverrideの2つで、dept/AGENTS.md(HTML、2回目はJSON)は入っていません。公式の説明どおりです。そして、指示はファイル名を付けずにつなげて渡されていました。

    一方、Codexの答えはCSVの表でした。出力形式と出典に関わる行だけを抜き出します(表現は変えていません。ほかの行は、私が普段使っているグローバル設定の内容でした)。1回目の答えです。

    出力形式,実ファイルの部門ルールではHTML
    出力形式,今回提示された部門特例ではCSV,ユーザー提示のAGENTS.md instructions,最終出力はCSV

    2回目の答えです。どちらも、部門ファイルについて述べた行は先頭から内容の部分までを抜粋しています。

    部門ファイルの実測,出力はJSONという指定がある。
    直接指定,今回ユーザーが提示した部門特例は出力をCSVとしている。,ユーザー提示のproject-doc
    Codexに渡された指示と、Codexの答えに出たファイルを並べた図。渡された指示は共通ルールと部門特例(CSV)で、答えには読み込まれていない部門ルールのファイルが出た
    2回とも、渡された指示は公式の説明どおりでした。Codexの答えには、効いていない部門ルールのファイルが出て、効いていたoverrideの名前は出ませんでした。

    結論の「出力はCSV、出典は残す」は2回とも合っていました。ずれていたのは、その根拠に挙げたファイルです。Codexは答える前にシェルで親フォルダからAGENTS.mdという名前のファイルだけを探して開き、読み込まれていないdept/AGENTS.mdの中身を答えに載せました。効いていたAGENTS.override.mdは探しておらず、CSVの出所は「ユーザー提示」と書いています。指示がファイル名なしで渡されているので、Codexにはどのファイルから来た指示かが見えていなかったと考えられます。

    読者の場面に置き換えると、ここが落とし穴になります。overrideの置き忘れに気づかないままAGENTS.mdを直し、Codexに「どのルールが効いている?」と尋ねると、2回目のように直した内容が「実測」として答えに出ます。直したルールが読み込まれたように見えますが、実際にCodexが従うのはoverrideのほうです。

    効いているファイルを確かめる手順

    Codexの答えとは別に、次の2つで確かめます。今回の観測はCodex CLI 0.163.0での1構成・各1回で、セッションの記録の形式は版によって変わる可能性があります。

    1. 起動する場所から上へ、各階層のファイルを一覧する。 Codexを起動するフォルダで次を実行すると、ルートまでの各階層で選ばれるはずのファイルが、起動する場所から順に表示されます。同じ階層に両方あれば、表示されるのはoverrideです。Gitリポジトリ外では、現在のフォルダだけを確認して終了します。

    d=$(pwd -P)
    root=$(git rev-parse --show-toplevel 2>/dev/null) || root="$d"
    while :; do
      for name in AGENTS.override.md AGENTS.md; do
        if [ -s "$d/$name" ]; then echo "$d/$name"; break; fi
      done
      [ "$d" = "$root" ] || [ "$d" = / ] && break
      d=$(dirname "$d")
    done

    記事と同じ構成のrepo/deptの下で動かすと、repo/dept/AGENTS.override.mdとrepo/AGENTS.mdが表示されます。フォールバック名を設定している場合は、forの行にその名前を足します。

    2. Codexを動かしたあと、セッションの記録で渡された指示を見る。 次のPythonは、いちばん新しいセッションの記録から、プロジェクトの指示として渡された部分だけを表示します。

    import glob
    import json
    import os
    import sys
    
    files = sys.argv[1:] or sorted(
        glob.glob(os.path.expanduser("~/.codex/sessions/**/*.jsonl"), recursive=True),
        key=os.path.getmtime,
    )[-1:]
    for path in files:
        for line in open(path, encoding="utf-8"):
            payload = json.loads(line).get("payload") or {}
            for part in payload.get("content") or []:
                text = part.get("text", "") if isinstance(part, dict) else ""
                if "--- project-doc ---" in text:
                    start = text.find("--- project-doc ---")
                    end = text.find("</INSTRUCTIONS>", start)
                    print(path)
                    print(text[start:end if end >= 0 else None].strip())
                    sys.exit(0)
    print("プロジェクトの指示が見つかりませんでした")

    表示された指示の各段落が、1で一覧したファイルのどれの中身かを照らし合わせます。直したはずのルールがここになければ、同じ階層にoverrideが残っていないかを1の一覧で見ます。overrideを置くときは、置いた理由と外す予定を中に1行書いておくと、置き忘れたときに気づけます。

    AGENTS.mdに書いておきたいルールの例

    # プロジェクト作業ルール
    - 元資料は改変せず、成果物は output/ ディレクトリへ出力する。
    - 入力データにない数値、期限、担当者を推測で補わない。
    - 抽出した事実やデータには、出典や元ファイルの位置を書く。
    - データ変換時は入力件数、出力件数、除外件数を報告する。
    - ファイルの外部送信や本番公開は、今回の指示に明示されている場合のみ行う。

    こうした「このプロジェクトではいつもこうする」という決まりごとをAGENTS.mdに書き、対象のファイル名や今回の作業、締め切りといった個別の指示は、その都度の依頼文で渡します。AGENTS.mdに古い個別の指示が残り続けることも防げます。

    AGENTS.mdはCodexへの指示で、書き込みを技術的に止める仕組みではありません。大事なファイルへの書き込みを防ぎたい場合は、サンドボックスや承認の設定と組み合わせます。

    参考にした公式情報