WordPressで小さなサイトを運営していると、Search Consoleでクリック数や表示回数が減った記事が目に入ります。ただ、タイトルを変えるべきか、本文を補うべきか、そもそも直すべきかは、画面の合計値だけでは決まりません。AIに分析を頼んでも、その提案が元のデータのどこに基づいているかを確かめられなければ、判断には使えません。
運営しているサイトで、記事1件について2つの期間のクエリ表を書き出して集計すると、比べる以前の問題が出ました。前の期間はページ全体で2クリック・4表示あったのに、書き出したクエリ表は0行でした。期間を「比較」にしたまま書き出すと、片方の期間に行がない検索語は、クリック・表示・掲載順位がすべて0で埋まり、実在しない「0位」まで入っていました。書き出したCSVを並べるだけでは検索語ごとの前後比較は成り立たず、今回のデータでは「保留して取り直す」が正しい結論になりました。
この記事では、ページで絞ったクエリ表を同じ条件の2期間で書き出し、コードで集計し、AIに出させた仮説を元のCSVの行に戻して確かめる手順を示します。読み終えたら、先に確かめる記事1件と最初の小さな作業を書いた改善ブリーフを作るか、データが足りないと判断して期間を延ばして取り直すかを決められます。
完成形:改善ブリーフ1件か、保留と取り直し
手順の最後に手元に残るのは、次のどちらかです。
| 結論 | 手元に残るもの | 次にすること |
|---|---|---|
| 候補を1件選ぶ | 対象URL、根拠にした元CSVの行、確かめる仮説、最初の小さな作業、判断を変える条件を書いた改善ブリーフ | ブリーフの「次の確認」を済ませてから改稿に進む |
| 比較を保留する | 保留したURLと、その理由(行がない、空欄がある、表示が0など) | 期間を延ばすか、データがたまってから同じ条件で書き出し直す |
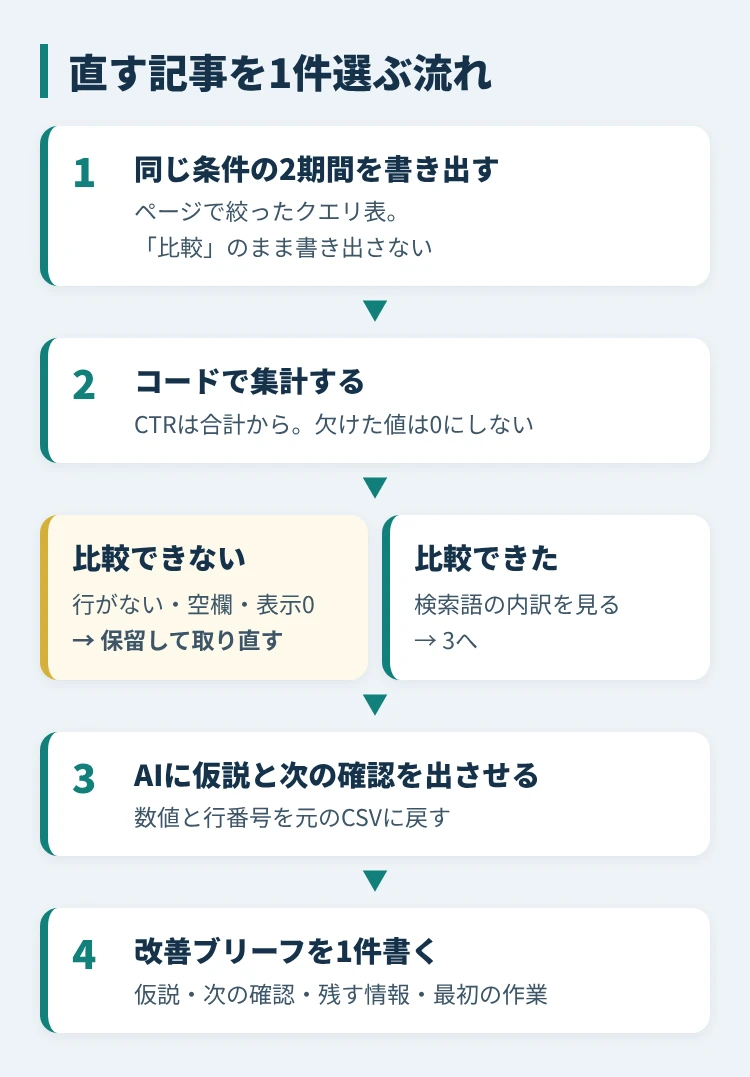
作業は、データの書き出し→コードでの集計→AIによる仮説の整理→人による確認、の順です。AIにCSVだけを渡して「SEOを改善して」と頼むと、欠けた行をゼロとして数えたり、CTR(クリック率)の低下をすぐタイトルのせいにしたりする余地が残ります。数値はコードで固定し、AIには仮説と次に確かめることだけを出させます。
手順1:ページで絞ったクエリ表を、期間ごとに書き出す
「ページ」の一覧と「クエリ」の一覧を別々に書き出しても、どの検索語がどのURLにつながったかは分かりません。確かめたいページを選び、ページで絞った状態のクエリ表を期間ごとに書き出します。以下は、運営しているサイトのSearch Console(日本語画面)でたどった手順です(2026年10月12日)。
-
「検索パフォーマンス」を開き、期間の「詳細」から前の期間の開始日と終了日を入れます。検索タイプ、必要なら国と端末も設定します。
-
「ページ」タブで対象URLの行をクリックします。上部に「ページ: (URL)」の条件が付き、表は自動で「クエリ」タブに切り替わります。
-
右上の「エクスポート」から「CSVをダウンロード」を選びます。届くのはZIPで、中にクエリ・ページ・国・デバイス・検索での見え方の表と、条件を記した「フィルタ.csv」が入っています。
-
ページの条件はそのままで期間を後の期間に変え、もう一度書き出します。ファイル名には書き出した日付しか入らないので、保存したらすぐ「前期間」「後期間」が分かる名前に変えます。
比べる2つの期間は長さをそろえ、対象URL・検索タイプ・国・端末を固定します。検索タイプは、上部の表示が「検索タイプ: ウェブ」でも、開くと「ウェブ」の下の「テキストベース」が選ばれていました。フィルタ.csvには「ウェブ」としか残らないので、画面で選んだ区分は自分で記録します。グラフの最新部分が点線なら暫定のデータなので、確定した期間で比べます。日別のデータは太平洋時間(PT)で集計されるため、日本時間のアクセス解析と日付だけで突き合わせると少しずれます(Google公式:概要と基本設定、データの不一致、確認日:2026年10月17日)。
期間の「比較」のまま書き出さない
期間の「比較」は画面で見比べるには便利ですが、書き出しには使いません。比較したまま書き出したZIPでは、前の期間に行がない検索語が、前期間側のクリック数・表示回数・CTR・掲載順位をすべて0にして出力されていました。掲載順位は1位以上の値なので、0位は実在しない値です。フィルタ.csvにも、比較した側の期間は残りませんでした。
CSVの0が、本当のゼロとは限らない
Googleの説明では、画面で「~」「-」と表示される項目は、ダウンロードしたデータでは0になります(エクスポートの注意)。CSVだけでは、本当のゼロと値がなかった項目を見分けられないことがあります。書き出す前に画面の表示を記録し、どちらか分からない値は、集計の入力では空欄にします。
また、クエリ表には匿名化された検索語が出ず、表に出せる行数にも上限があります。取得したクエリ行を合計しても、ページ全体の合計と一致するとは限りません(表とグラフの差)。ページ側の合計と、取得できたクエリ行を別々に記録しておきます。
運営サイトで書き出した結果:保留
運営しているサイトの記事1件で、9日間ずつの2期間(2026年9月22〜30日と10月1〜9日)を書き出し、集計まで通しました。サイトを公開して間もないため、期間は短くしています。
| 期間 | ページ全体(ページ.csv) | 書き出したクエリ行 |
|---|---|---|
| 前期間 | 2クリック/4表示 | 0行 |
| 後期間 | 1クリック/1表示 | 1行(1クリック/1表示) |
集計の結果は比較の保留で、理由は「観測クエリ集合が不一致」と「before: 行なし」でした。前の期間にもクリックはあったのに、どの検索語だったかは表に出てきません。ページ合計の減少だけでは検索語ごとの原因を判断できないので、私はこの記事を改稿の候補から外し、データがたまってから同じ条件で取り直すことにしました。
保留の理由ごとに、次にすることは次のとおりです。
| 保留の理由 | 次にすること |
|---|---|
| 片方の期間に行がない | 期間を延ばして取り直す。流入が消えた、新しく表示された、とはこれだけで決めない |
| 数値に空欄がある | 画面で該当の行の値を確かめる。分からなければ空欄のまま保留する |
| 表示回数が0 | CTRと掲載順位は計算できない。0%として扱わない |
手順2:コードで集計する
2つのZIPを、記事の最後に載せた gsc_to_input.py で共通の列のCSVに写し、aggregate.py で集計します。どちらもPython 3.10以上の標準ライブラリだけで動きます。手元でPythonを動かすのが難しければ、コードを実行できる環境のClaudeなどに実行させ、出てきた値を下の期待値と照らしてから次へ進みます。
python3 gsc_to_input.py 前期間.zip 後期間.zip > input.csv
python3 aggregate.py input.csv context.json > result.json
context.json には、2つの期間の日付と、検索タイプ・国・端末・確定データかどうかを、画面の記録から書きます(形式は最後の付録にあります)。
集計では、CTRを行ごとの率の平均ではなく、合計クリック数÷合計表示回数で計算し直します。掲載順位も、行ごとの順位を表示回数で重み付けして平均します。
取得クエリ行のCTR(%)= 合計クリック数 ÷ 合計表示回数 × 100
取得クエリ行の掲載順位 ≒ Σ(各行の掲載順位 × 表示回数)÷ 合計表示回数
たとえば「60クリック/1,000表示」と「40クリック/400表示」の2行なら、CTRは100÷1,400×100=7.14%で、6%と10%を平均した8%にはなりません。Search Consoleの平均掲載順位は検索結果に出たときの最上位の位置を平均した値なので、取得した行から計算した順位は、画面のページ単位の順位と一致するとは限らない近似値として扱います。
コードは入力の状態に応じて、次のように止まるか保留します。
| 入力の状態 | 処理 |
|---|---|
| 同じ期間・URL・検索語が重複 | 二重に数えないよう、入力エラーで止まる |
| 期間の長さや、検索タイプ・国・端末が違う/暫定データ | 入力エラーで止まる |
| 片方の期間に行がない/数値が空欄 | そのURLを保留にする。欠けた値をゼロで埋めない |
| 表示回数が0 | CTRと掲載順位をnullにし、0%と区別する |
| 掲載順位が1未満・数値以外 | 入力エラーで止まる |
result.json では、URLごとに comparable(比較できたか)と hold_reasons(保留の理由)を見ます。source_rows から、検索語ごとの値と元CSVの行番号をたどれます。入力エラーで止まったら、空の出力をAIに渡さず、CSVと条件を直します。
手順3:比較できた記事を、検索語の内訳で確かめる
運営サイトでは比較できる記事がなかったので、比較できた場合の読み方を、練習用に用意した18行のCSV(7URL、URLはexample.com)で示します。期間は2026年8月14日〜9月10日と9月11日〜10月8日の28日ずつ、条件は日本・モバイル・ウェブのテキストベースです。比較できたのは7URL中3URLでした。
| 対象URLの末尾 | クリック(表示) | CTR(%) | 掲載順位 |
|---|---|---|---|
| /wordpress-backup/ | 100→50(1,400→1,400) | 7.14→3.57 | 1.94→3.63 |
| /wordpress-speed/ | 100→120(2,500→3,000) | 4.00→4.00 | 4.40→4.40 |
| /seo-basics/ | 30→50(1,100→3,100) | 2.73→1.61 | 7.41→7.79 |
掲載順位は数値が大きいほど下位です。残りの4URLは、片方の期間に行がない、空欄がある、両期間とも表示0、のいずれかで保留になりました。
合計だけを見ると、/seo-basics/ もCTRと順位が悪化しています。ところが、検索語ごとに見るとどちらも変わっていません。
| 検索語 | クリック/表示 | CTR | 掲載順位 |
|---|---|---|---|
| SEO 基本 | 20/100→20/100 | 20%のまま | 1.5位のまま |
| SEO とは | 10/1,000→30/3,000 | 1%のまま | 8.0位のまま |
CTRも順位も低い「SEO とは」の表示が3倍に増えたため、合計の値が引っ張られただけで、クリック数は20件増えています。合計CTRが下がったという理由だけで、タイトルを変える必要はありません。一方、/wordpress-backup/ は2つの検索語でそろってCTRが半分になり、「WordPress バックアップ 復元」の順位は1.8位から4.2位に下がっていました。
手順4:AIに仮説と次の確認を出させ、元の行に戻す
数値はコードで固定し、AIには集計結果、元のCSV、期間と条件、候補ページの本文を渡します。公開できない検索語やURLを含む場合は、利用するAIサービスに渡してよい範囲を先に決めておきます。
目的:Search Consoleの2期間比較から、先に確認する記事を1件選ぶ。
入力:元CSV、条件記録、コードで作った集計JSON、候補ページの本文。

数値は集計JSONを使い、根拠を元CSVの行番号まで戻してください。
URLごとに「観測した事実/改善仮説/代替説明/次に確認すること/
限定作業の予定工数」を出し、候補は最大3件にしてください。

行の欠落や空欄は0として扱わないでください。CTRは合計クリック÷合計表示で扱います。
掲載順位は表示回数で重み付けした値を使い、検索語ごとの順位も見てください。
CTRや順位が下がったことだけで、タイトル・本文・AI Overviewを原因と決めないでください。
同じ語に複数URLがあることだけで競合と判断しないでください。
検索ボリューム、売上、順位上昇幅は、入力にないので作らないでください。
工数は見積もりと明記し、本文で確認できる不足とCTR低下の原因は分けて書いてください。
データが足りないURLは保留にし、理由を残してください。
練習データの集計結果・元CSV・条件と、/wordpress-backup/ の本文の見本を添えて、この依頼をClaudeに1回送りました(2026年10月11日)。Claudeは /wordpress-backup/ を第一候補にし、順位が1.94位から3.63位に下がっているので、CTR低下の一部はそれに伴う可能性があると整理しました。本文の不足として、復元の手順がないことに加えて、タイトルにも「復元」が入っていないことを挙げ、前の期間がお盆と重なることも代替説明に入れていました。
AIの案は、そのまま採用せず、数値を result.json と、根拠の行番号を元CSVと照らします。照らしたうえで、私は次のように判断しました。
| URL | 根拠 | 判断 |
|---|---|---|
| /wordpress-backup/ | CSV2〜5行。クリック−50、CTR−3.57ポイント、順位1.94→3.63。2語ともCTRが半分 | 第一候補にする。原因の特定と全面改稿は、次の確認の後に回す |
| /seo-basics/ | CSV10〜13行。合計は悪化して見えるが、検索語ごとの値は同じ | 改稿を急がず、表示が増えた状態が続くかを見る |
| /wordpress-speed/ | CSV6〜9行。クリックと表示が同じ割合で増え、CTRも順位も同じ | 後回しにする。ほかの語や問い合わせなどの成果は別に見る |
AIが出した作業時間の見積もりは、自分の作業の速さで見積もり直すため、候補表から外しました。
改善ブリーフを書く
第一候補には、次の改善ブリーフを書いて、次の作業に渡します。判断の対象にした本文の見本は次のとおりです。
タイトル:WordPressのバックアップ設定と保存先
データベースとファイルを両方保存し、サーバー外にもコピーを置きます。保存日時と対象を記録してください。復元は現在の内容を上書きする可能性があるため、作業直前の状態も保存し、検証環境で確認します。復元方法はホスティングやプラグインで異なり、この記事にはサービス別の操作手順はありません。
| 項目 | 内容 |
|---|---|
| 対象・読者の問い | /wordpress-backup/。「保存済みのバックアップから、どう安全に戻せるか」 |
| まず確かめる仮説 | 復元を目的とする読者に、方法の選び方が足りない。サービス別の手順が要るか、案内のリンクで足りるかを確かめる |
| 代替説明 | 検索結果の構成や他サイトの変化、表示タイトルの書き換え、季節(前の期間がお盆と重なる)、取得できていない行の変化 |
| 次の確認 | 日別の推移、WordPressのリビジョン履歴(期間中に本文やタイトルを変えていないか)、URL検査、実際の検索結果での見え方 |
| 残す情報 | データベースとファイルの両方、サーバー外の保存、保存日時、上書きの注意、作業前の別保存、検証環境での確認 |
| 最初の小さな作業 | 本文を直す前に、復元方法の選択肢と必要な根拠を整理する |
| 判断を変える条件 | 期間中に本文やタイトルを変えていた、検索結果全体の変動で説明できる、検索の意図が別、のどれかなら本文の追加を優先しない |
ブリーフの「残す情報」は、改稿で消してはいけない情報の一覧です。この先の、AIに既存記事へ書き足させて照合する手順は、既存記事に1節足す前に残す情報を決める記事で扱っています。
直したら、変更した日と箇所を記録し、確定した同じ条件の期間で見直します。一度に何か所も直すと、どれが効いたのかを切り分けにくくなります。
付録:コードと練習データ
長いコードは折りたたんでいます。4つのファイルを同じフォルダにUTF-8で保存すると、練習データで上の結果を再現できます。Python 3.10と3.13で動作を確かめました。
入力の列
| 列 | 意味・扱い |
|---|---|
| period | beforeまたはafter。日付と条件は context.json に書く |
| page | 絞り込んだページの完全なURL。比較の間は表記を変えない |
| query | 検索語。同じ期間・URL・検索語は1行だけ |
| clicks/impressions | 0以上の整数。取得できなかった値は空欄、確かめたゼロは0 |
| position | 1以上の数値。表示回数が0の行や取得できなかった値は空欄 |
元のCSVにあるCTR列は使わず、クリック数と表示回数から計算し直します。
input.csv(練習データ)
period,page,query,clicks,impressions,position
before,https://example.com/wordpress-backup/,WordPress バックアップ,60,1000,2.0
before,https://example.com/wordpress-backup/,WordPress バックアップ 復元,40,400,1.8
after,https://example.com/wordpress-backup/,WordPress バックアップ,30,1000,3.4
after,https://example.com/wordpress-backup/,WordPress バックアップ 復元,20,400,4.2
before,https://example.com/wordpress-speed/,WordPress 高速化,80,2000,4.0
before,https://example.com/wordpress-speed/,WordPress 画像 軽量化,20,500,6.0
after,https://example.com/wordpress-speed/,WordPress 高速化,96,2400,4.0
after,https://example.com/wordpress-speed/,WordPress 画像 軽量化,24,600,6.0
before,https://example.com/seo-basics/,SEO 基本,20,100,1.5
before,https://example.com/seo-basics/,SEO とは,10,1000,8.0
after,https://example.com/seo-basics/,SEO 基本,20,100,1.5
after,https://example.com/seo-basics/,SEO とは,30,3000,8.0
before,https://example.com/not-observed/,検索テスト,5,100,9.0
after,https://example.com/first-observed/,新しいテスト,8,200,12.0
before,https://example.com/zero/,ゼロのテスト,0,0,
after,https://example.com/zero/,ゼロのテスト,0,0,
before,https://example.com/incomplete/,欠測のテスト,4,100,7.0
after,https://example.com/incomplete/,欠測のテスト,,100,7.5
context.json
web-text と query-page はこのコード用の記録名で、前者はウェブのテキストベース、後者はクエリ×ページを表します。finalized は、入力した人が確定データだと確かめた記録です。実データでは、フィルタ.csvと画面の記録に合わせて新しく作り、練習用の日付を残さないでください。
{
  "before": {"start":"2026-08-14","end":"2026-09-10","search_type":"web-text","country":"jpn","device":"MOBILE","grain":"query-page","finalized":true},
  "after": {"start":"2026-09-11","end":"2026-10-08","search_type":"web-text","country":"jpn","device":"MOBILE","grain":"query-page","finalized":true}
}
aggregate.py
コードを開く
import csv
import json
import math
import sys
from collections import defaultdict
from datetime import date

COLUMNS = ["period", "page", "query", "clicks", "impressions", "position"]


def to_count(value, line):
    """空欄は取得できなかった値(None)、確認済みのゼロは0として読む。"""
    if value == "":
        return None
    if value.isascii() and value.isdigit():
        return int(value)
    raise ValueError(f"非負整数または空欄が必要: CSV {line}行")


def to_position(value, line):
    """掲載順位は1以上の数値。空欄は取得できなかった値(None)。"""
    if value == "":
        return None
    try:
        position = float(value)
    except ValueError:
        position = math.nan
    if not math.isfinite(position) or position < 1:
        raise ValueError(f"掲載順位は1以上の数値または空欄: CSV {line}行")
    return position


def aggregate(csv_path, context_path):
    with open(context_path, encoding="utf-8") as f:
        context = json.load(f)
    if set(context) != {"before", "after"}:
        raise ValueError("期間はbeforeとafterの2つが必要")
    spans = []
    for period in ("before", "after"):
        c = context[period]
        start, end = date.fromisoformat(c["start"]), date.fromisoformat(c["end"])
        if end < start or c["finalized"] is not True:
            raise ValueError("期間の順序または確定状態が不正")
        spans.append((start, end))
    if ((spans[0][1] - spans[0][0]).days !=
            (spans[1][1] - spans[1][0]).days or spans[0][1] >= spans[1][0]):
        raise ValueError("期間の長さが不一致、または重複・逆順")
    for key in ("search_type", "country", "device", "grain"):
        if not context["before"][key] or context["before"][key] != context["after"][key]:
            raise ValueError("比較条件が不一致: " + key)
    if context["before"]["grain"] != "query-page":
        raise ValueError("query-page形式が必要")

    grouped = defaultdict(lambda: defaultdict(dict))
    with open(csv_path, encoding="utf-8-sig", newline="") as f:
        reader = csv.DictReader(f)
        if reader.fieldnames != COLUMNS:
            raise ValueError("CSV列が不正")
        for line, row in enumerate(reader, 2):
            if None in row.values():
                raise ValueError(f"列が不足: CSV {line}行")
            p, url, query = row["period"], row["page"], row["query"]
            if p not in context or not url.startswith("https://") or not query:
                raise ValueError(f"入力不正: CSV {line}行")
            if query in grouped[url][p]:
                raise ValueError(f"query-page重複: CSV {line}行")
            clicks = to_count(row["clicks"], line)
            impressions = to_count(row["impressions"], line)
            if clicks is not None and impressions is not None and clicks > impressions:
                raise ValueError(f"クリック数が表示回数を超過: CSV {line}行")
            grouped[url][p][query] = {"clicks": clicks, "impressions": impressions,
                                     "position": to_position(row["position"], line),
                                     "line": line}

    if not grouped:
        raise ValueError("データ行がない")
    output = []
    for url, periods in sorted(grouped.items()):
        reasons, totals = [], {}
        if set(periods.get("before", {})) != set(periods.get("after", {})):
            reasons.append("観測クエリ集合が不一致(欠落はゼロにしない)")
        for p in ("before", "after"):
            rows = list(periods.get(p, {}).values())
            blank = [str(r["line"]) for r in rows
                     if r["clicks"] is None or r["impressions"] is None
                     or (r["impressions"] > 0 and r["position"] is None)]
            if not rows or blank:
                totals[p] = {"clicks": None, "impressions": None,
                             "ctr_pct": None, "position": None}
                reasons.append(p + (": 行なし" if not rows
                                    else ": 空欄あり(CSV " + "・".join(blank) + "行)"))
                continue
            clicks = sum(r["clicks"] for r in rows)
            impressions = sum(r["impressions"] for r in rows)
            if impressions:
                ctr = 100 * clicks / impressions
                # 行ごとの掲載順位を表示回数で重み付けした近似値
                position = sum(r["position"] * r["impressions"]
                               for r in rows if r["impressions"]) / impressions
            else:
                ctr = position = None
                reasons.append(p + ": 表示回数ゼロでCTR・順位を計算できない")
            totals[p] = {"clicks": clicks, "impressions": impressions,
                         "ctr_pct": ctr, "position": position}
        comparable = not reasons
        delta = {}
        if comparable:
            before, after = totals["before"], totals["after"]
            for k in ("clicks", "impressions"):
                delta[k] = after[k] - before[k]
            delta["ctr_pp"] = after["ctr_pct"] - before["ctr_pct"]
            delta["position"] = after["position"] - before["position"]  # 正は下位へ
        output.append({"page": url, "totals": totals, "delta": delta,
                       "comparable": comparable, "hold_reasons": reasons,
                       "source_rows": dict(periods)})
    return output


if __name__ == "__main__":
    try:
        result = aggregate(sys.argv[1], sys.argv[2])
        print(json.dumps(result, ensure_ascii=False, indent=2))
    except (ValueError, KeyError, IndexError) as e:
sys.exit("入力を確認してください: " + str(e))練習データで実行すると、comparable は3URLが true、4URLが false になり、/wordpress-backup/ の delta は次の値になります。
{"clicks": -50, "impressions": 0, "ctr_pp": -3.5714285714285716, "position": 1.6857142857142857}gsc_to_input.py
期間を比較せず、ページ1件で絞り込んで書き出した前後2つのZIPを、aggregate.py の入力に写します。比較のまま書き出したZIPは列の形が違うので、受け付けずに止まります。表示回数が0の行は、順位を空欄にします。
コードを開く
"""Search Consoleの書き出し(ZIP)を、aggregate.pyの入力行に写す。

期間比較なし・ページ1件で絞り込んで「CSVをダウンロード」した前後2つのZIPを使う。
"""
import csv
import io
import sys
import zipfile

QUERY_COLUMNS = ["上位のクエリ", "クリック数", "表示回数", "CTR", "掲載順位"]


def read_csv(z, name):
    with z.open(name) as f:
        return list(csv.reader(io.TextIOWrapper(f, encoding="utf-8-sig", newline="")))


def convert(zip_path, period):
    with zipfile.ZipFile(zip_path) as z:
        filters = dict(read_csv(z, "フィルタ.csv")[1:])
        rows = read_csv(z, "クエリ.csv")
    page = filters.get("ページ", "")
    if not page.startswith("https://"):
        raise ValueError(f"{zip_path}: ページ1件で絞り込んだ書き出しが必要")
    if rows[0] != QUERY_COLUMNS:
        raise ValueError(f"{zip_path}: クエリ.csvの列が想定と違う(期間比較の書き出しは使わない)")
    out = []
    for query, clicks, impressions, _ctr, position in rows[1:]:
        if impressions == "0":
            position = ""  # 表示0の行には順位がない
        out.append([period, page, query, clicks, impressions, position])
    return filters, out


if __name__ == "__main__":
    if len(sys.argv) != 3:
        sys.exit("使い方: python3 gsc_to_input.py 前期間.zip 後期間.zip > input.csv")
    try:
        (fb, before), (fa, after) = convert(sys.argv[1], "before"), convert(sys.argv[2], "after")
        if {k: v for k, v in fb.items() if k != "日付"} != {k: v for k, v in fa.items() if k != "日付"}:
            raise ValueError("前後で日付以外のフィルタが違う")
    except (ValueError, KeyError, OSError, zipfile.BadZipFile) as e:
        sys.exit("書き出しを確認してください: " + str(e))
    for name, f, rows in (("before", fb, before), ("after", fa, after)):
        print(f"{name}: {f.get('日付')} / 検索タイプ {f.get('検索タイプ')} / クエリ {len(rows)}行", file=sys.stderr)
    writer = csv.writer(sys.stdout, lineterminator="\n")
    writer.writerow(["period", "page", "query", "clicks", "impressions", "position"])
    writer.writerows(before + after)
コメントを残す