タグ: Claude

  • AIのSEO診断の指摘を、渡した資料とページの目的で確かめてWordPressの直す場所を決める

    AIのSEO診断の指摘を、渡した資料とページの目的で確かめてWordPressの直す場所を決める

    AIにWordPressサイトのSEO診断を頼むと、noindex、canonical、見出し、速度などの指摘が重要度つきで並びます。どれも直したほうがよさそうに見えますが、指摘の中には、AIが渡された資料から確かめられたことと、資料にないことを推測で言い切ったことが混ざっています。どちらなのかを見分けないまま直すと、必要のない修正をしたり、本当に直すべき設定を後回しにしたりします。

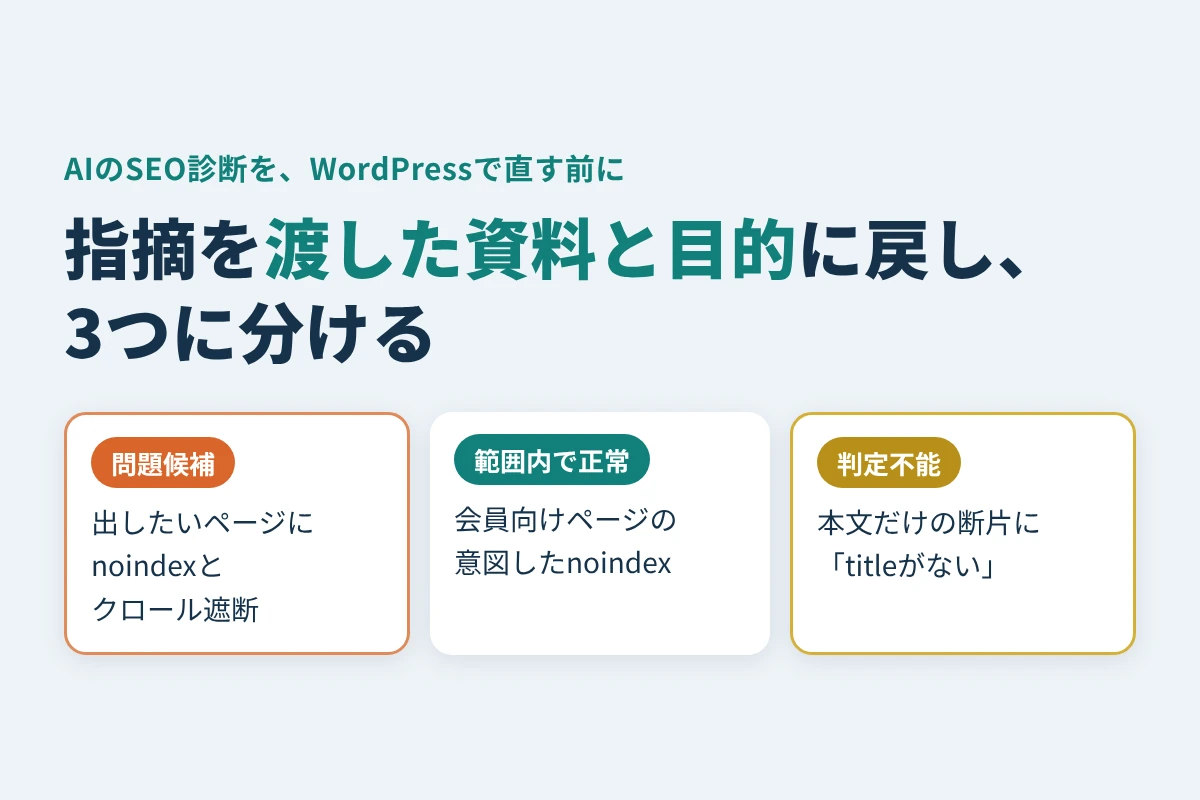
    例として用意したHTML・robots.txt・sitemapと、各ページの目的(検索に出したいかどうか)を5件分まとめてClaudeに渡し、普段どおりにSEO診断を頼みました。掲載したいページにnoindexとクロールの遮断が両方あるような、目的と食い違う設定の判断は、5件とも公式仕様と合っていました。一方で、本文だけの断片には、headとtitleがないこと、本文が薄いことを重要度「高」で断定し、同じ回答の中で、保存のときに一部しか保存されなかった可能性があるので配信中のHTMLを先に確かめるように、とも勧めていました。採ってよい助言と、確かめずに直してはいけない断定が、1つの回答に並んでいたのです。

    この記事では、AIの指摘を1つずつ「渡した資料」「ページの目的」「公式仕様」に戻し、「問題候補」「確認した範囲では正常」「判定不能」の3つに分ける手順を、この診断結果で示します。読み終えたら、どの指摘を直し、どの指摘のために情報を集め直し、WordPressのどこを見に行くかを決められます。

    完成形:指摘を3つに分けた判定表

    手順の最後には、指摘ごとに次の3つのどれかを付けた表が手元に残ります。

    分け方 当てはまる指摘 次にすること
    問題候補 渡した資料で確かめられ、ページの目的と食い違う(検索に出したいのにnoindexがある、など) 公開中のページでも同じかを確かめ、設定の出力元を探す
    確認した範囲では正常 渡した資料の範囲では、目的どおりになっている 何を確かめたか(ファイルと取得日時)を残す。資料にない項目は別に確かめる
    判定不能 資料に含まれていない、ページの目的が分からない、実測値がない 必要な資料を集めてから判断する

    「問題候補」は、すぐ直せという意味ではありません。検索に出す必要のないページなら、noindexは目的どおりです。「正常」にも、何を確かめた結果かを添えます。HTMLに望まない指定がなくても、HTTPのヘッダーから別の指定が出ている可能性は残るからです。
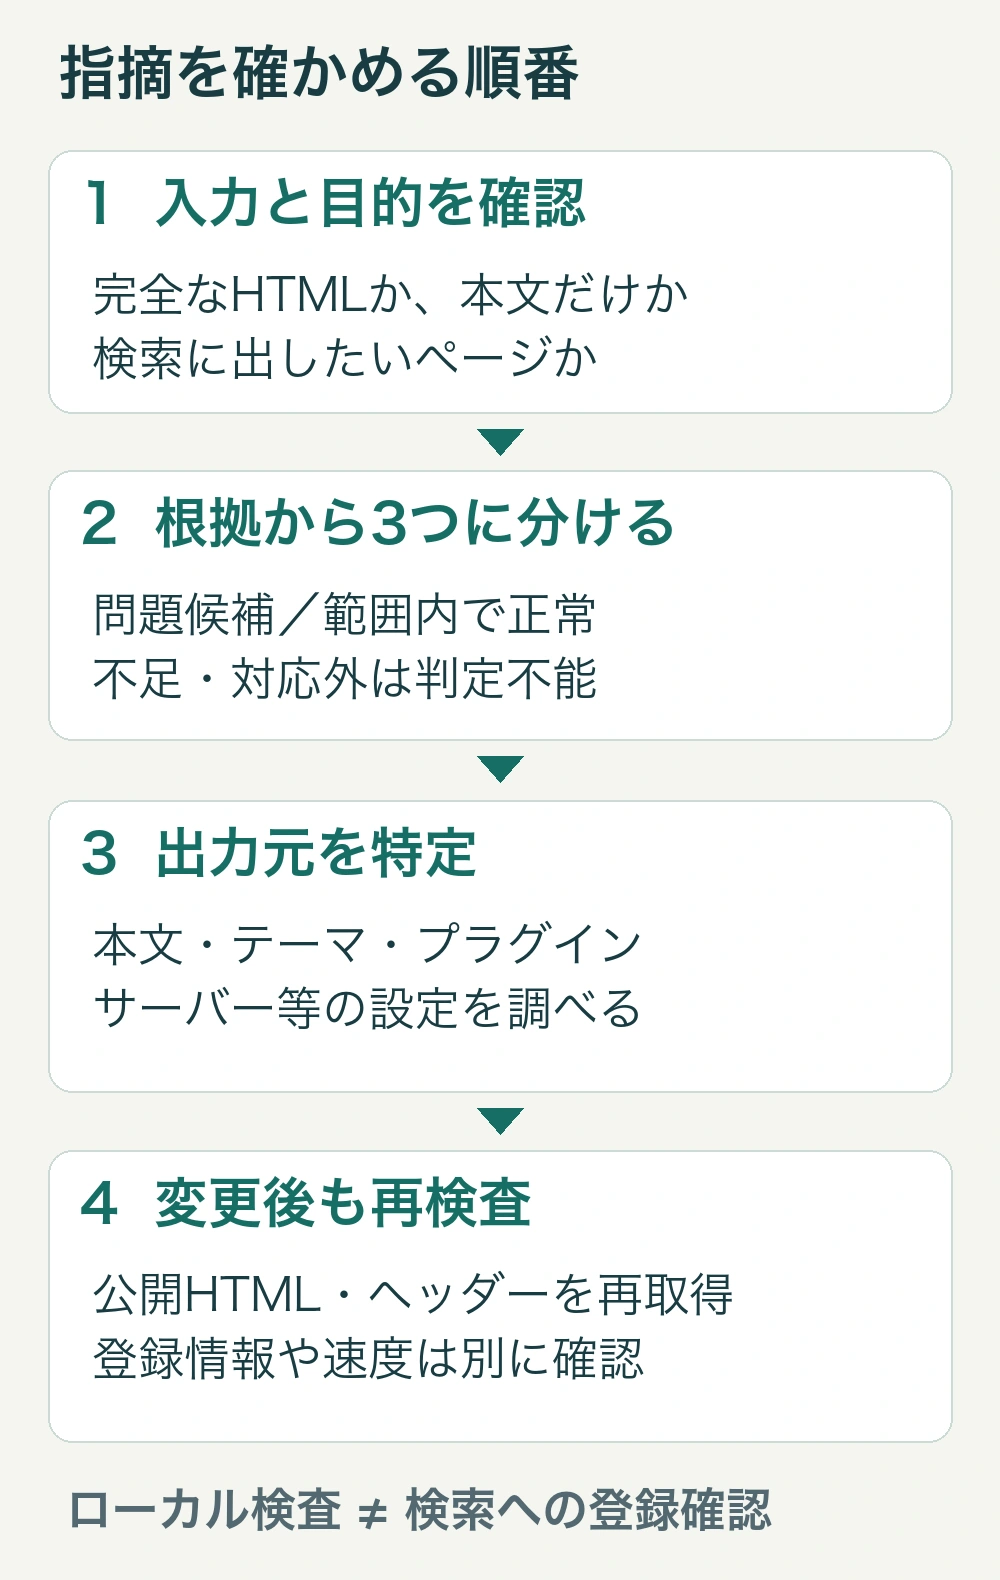
    AIの指摘を渡した資料とページの目的に戻し、問題候補・確認した範囲では正常・判定不能に分けて公開状態を確かめる流れ
    指摘を、渡した資料と目的に戻してから分けます。

    手順1:AIに渡した資料と、ページの目的を書き出す

    まず、診断の前提を2つ書き出します。

    • 渡した資料:完全なHTMLか本文だけの断片か、取得した日時、HTTPヘッダー・robots.txt・sitemapを渡したか。

    • ページの目的:検索結果に出したいか、出したくないか。代表にしたいURL(canonical)はどれか。

    今回は、5つのページの目的と保存ファイルを、ツールを使わずに資料だけで答えるよう指示して、Claudeに1回送りました(2026年10月12日)。依頼文は「ケースごとに問題点と修正案を、重要度(高・中・低)付きで」という、普段頼むのに近い形だけにしました。

    ケース 渡した資料 ページの目的
    A 本文だけの断片(<h1> の1行) 検索に出したい
    B noindexのある完全なHTML 会員向けで、検索に出したくない
    C H1が2つ、コメントとscriptの中にnoindexの文字があるHTML 検索に出したい
    D noindexのあるHTMLと、そのパスを遮断するrobots.txt 検索に出したい
    E WordPress標準に近いrobots.txtとsitemap index 検索に出したい

    手順2:指摘を、資料と目的と公式仕様に戻す

    次に、AIの指摘を1つずつ、渡した資料に実際に書かれていること、ページの目的、公式仕様の3つに照らします。今回の回答の主な指摘と、照らした結果は次のとおりです。

    ケース AIの主な指摘 照らした結果 分け方と次の確認
    A 断片 headとtitleがない、本文が薄い(どちらも重要度「高」)。同時に、配信中のHTMLを先に確かめるよう勧めた 渡したのは断片なので、headの欠落も本文の薄さも資料からは言えない 判定不能。断定は採らず、配信HTMLの確認を採る
    B 会員向け noindexの削除は勧めず、noindexは閲覧の制限にはならないこと、sitemapから外すことを挙げた noindexは検索結果への掲載を防ぐ指示で、閲覧は制限しない。sitemapには検索に出したいURLを入れる 確認した範囲では正常。会員限定ならログインでの制限を検討し、sitemapの生成元を確かめる
    C 見出し コメントやscriptの中のnoindexは効いていない。H1が複数でも問題ない どちらもrobots metaとして読まれる要素ではない。Googleのガイドに理想の見出し数はない 確認した範囲では正常。2つ目をh2にするかは内容で決める
    D 二重の遮断 noindexとクロールの遮断で二重に止めていて、片方だけ直しても解決しない クロールできなければnoindexは読まれない 問題候補。最優先で両方の出力元を確かめる
    E WordPress標準 robots.txtは標準どおりで問題ない。sitemap indexに対象URLが載っていない可能性 robots.txtは最も長く一致する規則が使われるので、対象パスは遮断されない。投稿か固定ページかは資料にない robotsは確認した範囲では正常。sitemapは判定不能で、子sitemapを開いて確かめる

    ケースAの回答には、次の行がありました(Claudeの回答の原文の一部)。

    <head>がなく、<title>もない。検索結果の見出しはGoogleが自動で作るため、ページの中身が伝わらない

    最初に確認すること: 保存のときに一部しか保存されなかった可能性があります。修正の前に、ブラウザの「ページのソースを表示」かSearch ConsoleのURL検査で、実際に配信されているHTMLを確かめてください。

    前者は資料の外の断定で、後者はその断定を確かめるための正しい助言です。重要度「高」の表だけを読んで直し始めると、後者を読み飛ばします。指摘を表から拾うときは、同じ回答の中の「確認すること」まで読みます。

    5件すべてに共通して、タイトルが汎用的なこと、viewportとmeta descriptionがないことも指摘されましたが、これは例として簡略化したファイルの性質です。自分のページで同じ指摘が出たら、公開中のHTMLで確かめる項目として扱います。

    照らすときに使う公式仕様は、主に次の4つです(いずれも確認日:2026年10月12日)。

    • noindexはHTMLのrobots metaか、HTTPの X-Robots-Tag で指定する。robots.txtでクロールを遮断すると、noindexは読まれない(Googleのnoindexの説明)。body内のrobots metaも認識される(robots metaの仕様)。

    • canonicalは代表にしたいURLを伝える強いシグナルだが、指定どおりに選ばれる保証はない。別のURLを意図して代表にしているページもある(正規URLの説明)。

    • robots.txtは、最も長く一致する規則が使われる(robots.txtの仕様)。WordPressが標準で出すrobots.txtには Allow: の行があり、標準のsitemapはsitemap indexになっている(WordPressのrobots.txt生成)。

    • 見出しの数に理想の値はない(Google SEOスターターガイド)。

    手順3:判定表に、WordPressで見る場所を書き足す

    問題候補と判定不能の指摘には、WordPressで最初に見る場所と、変更したあとの確かめ方を書き足します。記事の本文を書き直しても、head内のcanonicalやHTTPヘッダーは変わらないことがあります。

    症状・確かめる対象 最初に見る場所 変更後の確かめ方
    記事の見出し・説明・本文のリンク 記事エディター。ページタイトルのH1はテーマ側の場合もある 公開ページの表示とHTMLで、見出しの対応を見る
    サイト全体に意図しないnoindex 設定→表示設定の「検索エンジンでの表示」、有効なプラグインの設定 公開HTMLとヘッダーを取り直す。設定画面だけで完了にしない
    特定ページのnoindex・canonical SEOプラグインのページ別設定、テーマや追加コード HTML全体のrobots meta、head内のcanonical、ヘッダーに望む指定が1つだけ出ているか
    X-Robots-Tag やHTTPの Link のcanonical サーバー設定、CDN、プラグインなどのヘッダーの生成元 対象URLへのGETの応答で、ステータス・転送先・ヘッダーを見る
    robots.txt・sitemap WordPressやSEOプラグインの生成設定、サーバー上の実ファイル 公開中のファイルを取り直し、対象URLと規則を照らす

    サイト全体の「検索エンジンでの表示」の設定は、WordPress公式の表示設定の説明にあります(確認日:2026年10月12日)。実際の出力元はテーマとプラグインの組み合わせで変わるので、表は見に行く順番として使います。

    直す順番は、まず「検索に出したいページが、意図せずnoindexやクロールの遮断になっていないか」(今回のケースD)、次に「代表URLの指定が重複していないか」です。見出しの整理は内容を読んで決めます。変える値・対象URL・戻し方を決め、1件ずつ確かめてから反映します。

    手順4:判定不能の指摘のために、公開状態を取り直す

    判定不能に分けた指摘は、資料を足してから判断します。自分が管理するページなら、次の記録をそろえます。

    1. 対象URL、最終的なURL、取得日時、HTTPステータスと転送、GETの応答のヘッダー、完全なHTML。

    2. 同じサイトの公開中のrobots.txtと、対象URLが属するsitemap。

    3. Search ConsoleのURL検査の結果。Googleが持つ登録情報と、今のページへのライブテストを分けて記録し、Googleが選んだ正規URLも見る(URL検査の公式説明)。

    4. 変更したあとに、同じURL・同じ条件で取り直した記録。

    速度の指標(LCP・INP・CLS)を指摘されたら、測った元、期間、端末、ラボの測定か実際の利用者のデータかを確かめます。保存したHTMLから値は出せません(GoogleのWeb Vitalsの説明)。

    AIに、指摘の根拠を出し直してもらう

    診断が長く、自分で照らすのが大変なときは、修正案を増やす前に、AIに指摘を判定表の形で出し直してもらいます。貼る情報に、認証情報や個人情報を含めないでください。

    対象URLとページの目的:[URL/検索に出したいか/希望する代表URL]
    渡す資料:[完全なHTMLか本文断片か、取得日時、ヘッダー・robots・sitemapの有無]
    元の診断:[ここに貼る]
    各指摘を「観測した値」「根拠となる箇所」「公式資料」「問題候補/確認範囲内で正常/判定不能」「次の確認」に分けてください。
    ページの目的と食い違う指摘を優先してください。
    取得していないヘッダー、実インデックス、順位、速度の値は判定不能にしてください。
    修正箇所が本文・テーマ・プラグイン・サーバーのどこか、まだ特定できない場合も書いてください。

    返ってきた表も、該当するHTMLや公式資料と照らします。根拠の箇所が示されない指摘は、直す判断を保留します。

    付録:保存したファイルを3つに分ける小さなPythonコード

    AIの指摘と照らすための比較用に、保存したHTML・robots.txt・sitemapから、確かめられる範囲だけを判定するコードを用意しました。Python 3.10以降の標準ライブラリだけで動き、通信はしません。長いコードは折りたたんでいます。3つのファイルを空のフォルダにUTF-8で保存し、python3 run_checks.py を実行すると、18の例で判定を確かめられます。

    入力例 このコードの判定 読み方
    noindex:掲載したいページにnoindex metaが問題候補 公開HTMLと設定を確かめる
    body-noindex:body内にnoindex metaが問題候補 headだけでなくHTML全体を見る
    intended:掲載を望まないページにnoindex metaは範囲内で正常 noindexの削除は不要
    conflict:異なるcanonicalが2つ canonicalが問題候補 重複して出力している元を探す
    fragment:本文だけ metaとcanonicalは判定不能 「titleがない」とは言えない
    two-h1:H1が2つ、コメントにnoindexの文字 metaは範囲内で正常、H1数は2として記録 H1の数は判定に使わない
    wp-default:WordPress標準のrobots.txtとsitemap index robotsとsitemapは判定不能 規則と子sitemapを手で確かめる

    このコードのrobots.txtの判定は、単一の User-agent: * と単純な Disallow だけを扱い、Allow: や Sitemap: の行があれば判定不能にします。WordPressの実際のrobots.txtはこの形に当たるので、手順2のケースEのように、Googleの仕様に沿って手で確かめます。http(ヘッダー)、index(登録状態)、cwv(速度)は、入力に含まれないので常に判定不能です。コードの出力では、「確認した範囲では正常」を「範囲内で正常」と表示します。

    fixtures.py:18の例を作る

    want_index は検索に出したいなら true、出したくないなら false、分からなければ null です。preferred は運営者が代表にしたいURLで、Googleが選ぶURLとは別です。URLはすべて example.com です。

    コードを開く
    import json
    from pathlib import Path
    
    URL = 'https://example.com/guide/'
    OTHER = 'https://example.com/original/'
    CANON = f'<link rel="canonical" href="{URL}">'
    XML = f'<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"><url><loc>{URL}</loc></url></urlset>'
    
    def fixture(name, meta='', canonical=CANON, body='<h1>手順</h1>', want=True,
                preferred=URL, robots='User-agent: *\nDisallow:\n', sitemap=XML, fragment=False, base=''):
        d = Path('fixtures') / name
        d.mkdir(parents=True, exist_ok=True)
        html = body if fragment else f'<!doctype html><html lang="ja"><head><meta charset="utf-8"><title>手順</title>{base}{meta}{canonical}</head><body>{body}</body></html>'
        for file, text in [('page.html', html), ('robots.txt', robots), ('sitemap.xml', sitemap),
                           ('intent.json', json.dumps({'url': URL, 'want_index': want, 'preferred': preferred}, ensure_ascii=False, indent=2))]:
            (d / file).write_text(text, encoding='utf-8')
    
    fixture('normal')
    fixture('noindex', meta='<meta name="robots" content="noindex, follow">')
    fixture('fragment', body='<h1>本文だけ</h1>', fragment=True)
    fixture('conflict', canonical=CANON + f'<link rel="canonical" href="{OTHER}">')
    fixture('intended', meta='<meta name="robots" content="noindex">', want=False)
    fixture('unknown-intent', meta='<meta name="robots" content="noindex">', want=None)
    fixture('googlebot-none', meta='<meta name="googlebot" content="NONE">')
    fixture('cross-canonical', canonical=f'<link rel="canonical" href="{OTHER}">', preferred=OTHER,
            sitemap=XML.replace(URL, OTHER))
    fixture('missing-canonical', canonical='')
    fixture('blocked-noindex', meta='<meta name="robots" content="noindex">', robots='User-agent: *\nDisallow: /guide/\n')
    fixture('complex-robots', robots='User-agent: *\nDisallow: /\nAllow: /guide/\n')
    fixture('broken-sitemap', sitemap='<urlset>')
    fixture('two-h1', body='<h1>手順</h1><h1>別の区分</h1>',
            meta="""<!-- <meta name="robots" content="noindex"> --><script>const s = '<meta name="robots" content="noindex">';</script>""")
    fixture('sitemap-index', sitemap='<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"></sitemapindex>')
    fixture('base-relative', canonical='<link rel="canonical" href="guide/">', base='<base href="https://example.com/">')
    fixture('relative', canonical='<link rel="canonical" href="/guide/">')
    fixture('body-noindex', body='<meta name="robots" content="noindex"><h1>手順</h1>')
    # WordPress標準に近いrobots.txtとコアのsitemap index(この最小コードでは判定不能になる例)
    WP_ROBOTS = 'User-agent: *\nDisallow: /wp-admin/\nAllow: /wp-admin/admin-ajax.php\n\nSitemap: https://example.com/wp-sitemap.xml\n'
    WP_INDEX = '<?xml version="1.0" encoding="UTF-8"?><sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"><sitemap><loc>https://example.com/wp-sitemap-posts-post-1.xml</loc></sitemap></sitemapindex>'
    fixture('wp-default', robots=WP_ROBOTS, sitemap=WP_INDEX)

    audit.py:確かめられる範囲だけ判定する

    コードを開く
    import json
    import re
    import sys
    from html.parser import HTMLParser
    from pathlib import Path
    from urllib.parse import urljoin, urlsplit
    import xml.etree.ElementTree as ET
    
    P, N, U = '問題候補', '範囲内で正常', '判定不能'
    
    class Page(HTMLParser):
        def __init__(self):
            super().__init__()
            self.head = False
            self.events, self.robots, self.canon = [], [], []
            self.base, self.h1 = False, 0
    
        def handle_starttag(self, tag, attrs):
            a = dict(attrs)
            if tag in ('html', 'head', 'body'):
                self.events.append(tag)
            if tag == 'head':
                self.head = True
            if tag == 'h1':
                self.h1 += 1
            if tag == 'meta' and (a.get('name') or '').lower() in ('robots', 'googlebot'):
                self.robots += re.split(r'[\s,]+', (a.get('content') or '').lower())
            if not self.head:
                return
            if tag == 'base':
                self.base = True
            if tag == 'link' and 'canonical' in (a.get('rel') or '').lower().split():
                self.canon.append(a.get('href') or '')
    
        def handle_endtag(self, tag):
            if tag in ('html', 'head', 'body'):
                self.events.append('/' + tag)
            if tag == 'head':
                self.head = False
    
    
    def audit(folder):
        d = Path(folder)
        cfg = json.loads((d / 'intent.json').read_text(encoding='utf-8'))
        url, want, preferred = cfg['url'], cfg['want_index'], cfg['preferred']
        h = Page()
        h.feed((d / 'page.html').read_text(encoding='utf-8'))
        full = h.events == ['html', 'head', '/head', 'body', '/body', '/html']
        out = {k: U for k in ('meta', 'canonical', 'robots', 'sitemap', 'http', 'index', 'cwv')}
        noindex = bool({'noindex', 'none'} & set(h.robots))
        if full:
            out['meta'] = U if want is None else (P if noindex and want else N)
            targets = {urljoin(url, x) for x in h.canon if x}
            if not h.base and h.canon:
                if any(not x for x in h.canon) or len(targets) > 1:
                    out['canonical'] = P
                elif preferred and all(urlsplit(x).scheme in ('http', 'https') for x in targets):
                    out['canonical'] = N if targets == {preferred} else P
        # 教材専用: 単一の User-agent: * と単純な Disallow 接頭辞だけ扱う。
        lines = [(x.split('#', 1)[0]).strip() for x in (d / 'robots.txt').read_text(encoding='utf-8').splitlines()]
        lines = [x for x in lines if x]
        rules, supported = [], bool(lines) and lines[0].lower() == 'user-agent: *'
        for line in lines[1:]:
            key, sep, value = line.partition(':')
            value = value.strip()
            if not sep or key.lower() != 'disallow' or (value and not value.startswith('/')) or any(c in value for c in '*$%?'):
                supported = False
            rules.append(value)
        if supported:
            blocked = any(x and urlsplit(url).path.startswith(x) for x in rules)
            out['robots'] = (U if want is None else P if want else N) if blocked else N
        try:
            root = ET.fromstring((d / 'sitemap.xml').read_text(encoding='utf-8'))
            ns = '{http://www.sitemaps.org/schemas/sitemap/0.9}'
            if root.tag == ns + 'urlset':
                locs = [x.text for x in root.findall(ns + 'url/' + ns + 'loc')]
                out['sitemap'] = N if preferred and preferred in locs else U
        except ET.ParseError:
            out['sitemap'] = P
        return {'checks': out, 'observed': {'complete_markers': full, 'html_noindex': noindex if full else None,
                'canonical_hrefs': h.canon if full else None, 'h1_count': h.h1},
                'scope': '確認したのは保存したHTML・robots.txt・sitemap.xml。正常は各項目の確認範囲に限る。HTTP・登録状態・CWVは別に取得して確かめる'}
    
    if __name__ == '__main__':
        print(json.dumps(audit(sys.argv[1]), ensure_ascii=False, indent=2))

    run_checks.py:例ごとの判定を照らす

    コードを開く
    import json
    import runpy
    from pathlib import Path
    from audit import audit, P, N, U
    
    runpy.run_path('fixtures.py')
    # 期待値:例ごとに、記事の3分類(問題候補/範囲内で正常/判定不能)で決めた値。
    expected = {
        'normal': [N,N,N,N], 'noindex': [P,N,N,N], 'fragment': [U,U,N,N],
        'conflict': [N,P,N,N], 'intended': [N,N,N,N], 'unknown-intent': [U,N,N,N],
        'googlebot-none': [P,N,N,N], 'cross-canonical': [N,N,N,N],
        'missing-canonical': [N,U,N,N], 'blocked-noindex': [P,N,P,N],
        'complex-robots': [N,N,U,N], 'broken-sitemap': [N,N,N,P],
        'two-h1': [N,N,N,N], 'sitemap-index': [N,N,N,U], 'base-relative': [N,U,N,N],
        'relative': [N,N,N,N], 'body-noindex': [P,N,N,N], 'wp-default': [N,N,U,U],
    }
    results = {}
    for name, values in expected.items():
        result = audit(Path('fixtures') / name)
        assert [result['checks'][k] for k in ('meta','canonical','robots','sitemap')] == values, name
        assert all(result['checks'][k] == U for k in ('http','index','cwv')), name
        results[name] = result
    assert results['two-h1']['observed']['h1_count'] == 2
    assert results['fragment']['observed']['html_noindex'] is None
    assert results['two-h1']['observed']['html_noindex'] is False
    Path('results.json').write_text(json.dumps(results, ensure_ascii=False, indent=2) + '\n', encoding='utf-8')
    Path('checks.json').write_text(json.dumps({'fixture_cases':len(expected),'status_assertions':len(expected)*7,
        'observation_assertions':3,'passed':True,'expected':expected}, ensure_ascii=False, indent=2)+'\n', encoding='utf-8')
    print(f'CHECK_OK: {len(expected)} cases, {len(expected)*7} statuses, 3 observations')

    python3 run_checks.py の出力は次のとおりで、全例の結果は results.json に保存されます。

    CHECK_OK: 18 cases, 126 statuses, 3 observations

    1つの例を見るときは python3 audit.py fixtures/noindex を実行します。

    {
      "checks": {
        "meta": "問題候補",
        "canonical": "範囲内で正常",
        "robots": "範囲内で正常",
        "sitemap": "範囲内で正常",
        "http": "判定不能",
        "index": "判定不能",
        "cwv": "判定不能"
      },
      "observed": {
        "complete_markers": true,
        "html_noindex": true,
        "canonical_hrefs": [
          "https://example.com/guide/"
        ],
        "h1_count": 1
      },
      "scope": "確認したのは保存したHTML・robots.txt・sitemap.xml。正常は各項目の確認範囲に限る。HTTP・登録状態・CWVは別に取得して確かめる"
    }

    meta が問題候補でも、http や index は判定不能のままです。この例で採る行動は「掲載したいページのnoindexを、公開HTMLと設定で確かめる」で、AIの指摘を一括で直す前に、同じように観測した値と目的を照らします。
  • AIで既存記事に1節足す前に、残す情報を決めて改稿後に照合する

    AIで既存記事に1節足す前に、残す情報を決めて改稿後に照合する

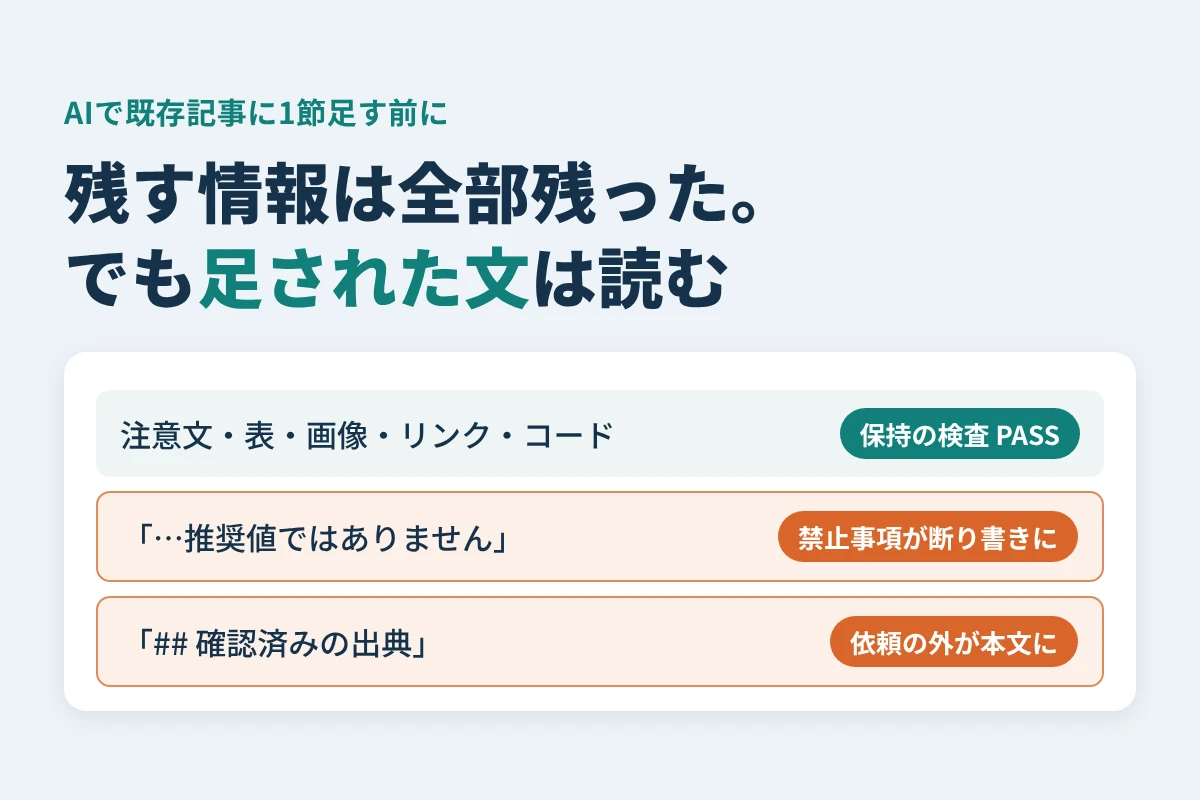
    公開済みの記事をAIに直させると、説明は増えても、元の注意事項や日付、リンク、コードが消えていることがあります。消えた情報は、改稿後の文章だけを読んでも気づけません。反対に、元の情報がすべて残っていても、足された文の中に、根拠のない一文や読者に不要な一文が混ざることがあります。

    WordPressのバックアップ記事に「復元候補を選ぶ」節を1つ足す依頼を、禁止事項(具体的な画面操作、固定の保存間隔、成功の保証などを加えない)を書いて、AIに2回出しました。2回とも、元の注意文・表・画像参照・リンク・コードはすべて残り、保持の検査に合格しました。ところが追加された文には、2回とも、禁止事項をそのまま読者向けの断り書きにした文がありました(「…推奨値ではありません」「…目安となる時間差を定めません」など)。どの禁止事項が断り書きになったかは回ごとに違い、2回目は、依頼に添えた出典のメモまで記事の本文として出力されました。

    この記事では、改稿の前に読者の問いと「変えずに残す情報」を決める改善ブリーフ、改稿後に照合する保持対象表とPythonの検査、追加された文を読み分ける手順を、この2回の実例で示します。読み終えたら、AIの改稿案を採用するか、直してから採るか、保留するかを決められます。

    使う場面と、手元に残るもの

    この手順は、すでに公開している記事の一部だけをAIに書き足させたいときに使います。手元に残るのは次の3つです。

    成果物 中身 使うとき
    改善ブリーフ 読者の問い、記事の役割、残す情報、足す情報、根拠がないときの扱い、扱わないこと AIに依頼する前
    保持対象表 残す情報ごとの照合方法と、照合だけでは分からないこと 改稿案を受け取った直後
    追加文の読み分け 足された文を「採る/削る/出典に戻す」に分ける基準 保持の照合に合格したあと
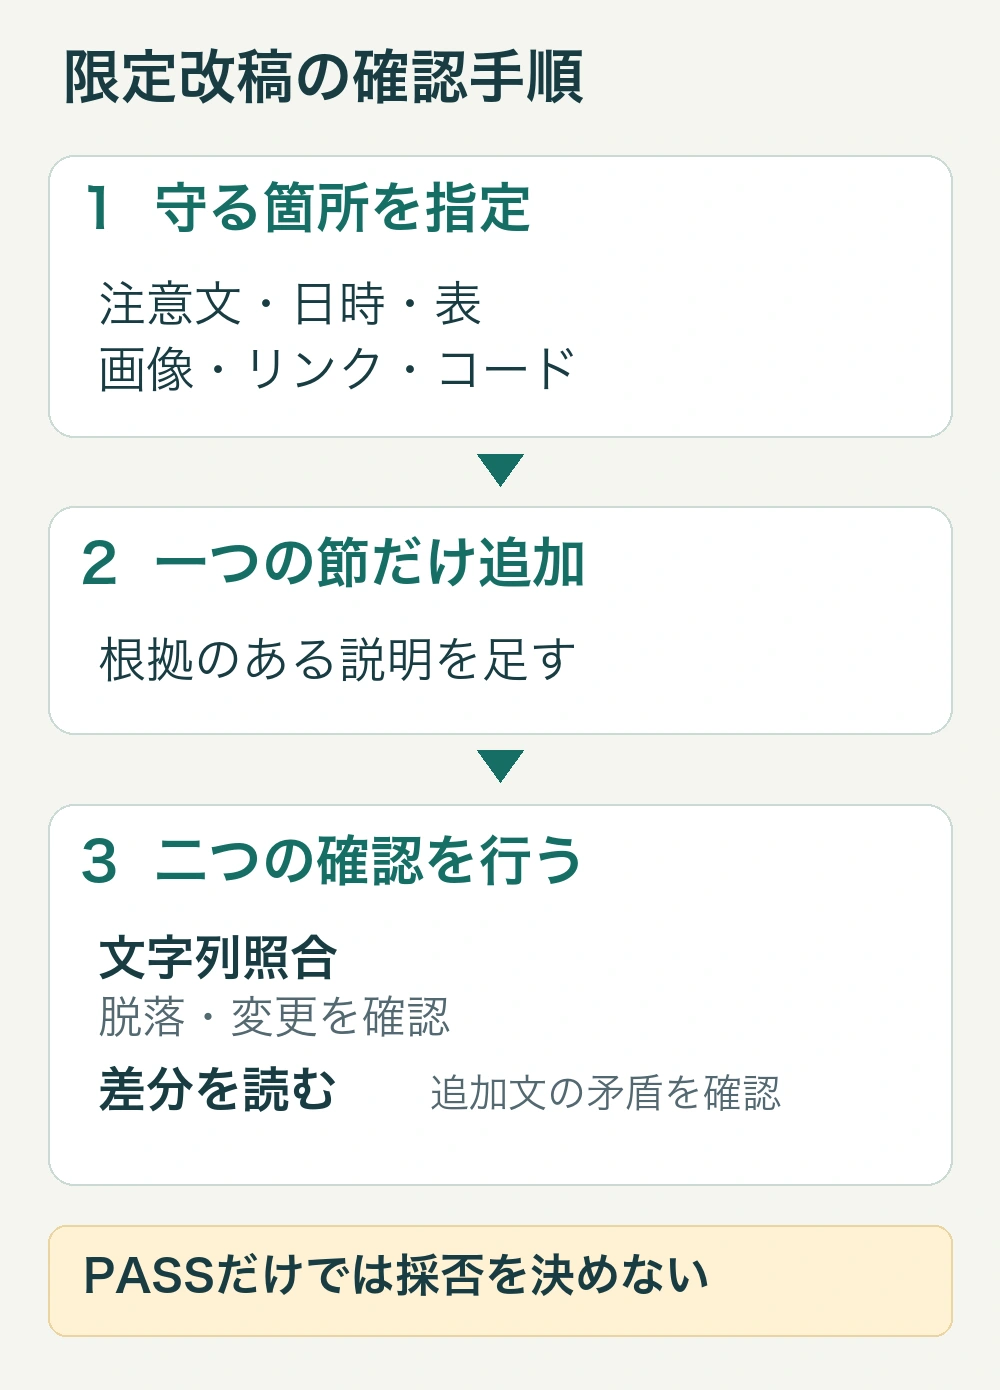
    改稿前に保持対象を決め、限定改稿のあとに文字列の照合と追加文の読み分けを行う流れ
    元の情報が残っていても、足された文は別に読みます。

    手順1:読者の問いを1文で決める

    最初に、この記事に来た読者が片づけたいことを1文にします。検索語と今の本文から考えます。今回の例は「WordPressのバックアップ設定と保存先」という記事で、Search Consoleでは「WordPress バックアップ 復元」でも表示され、その語の掲載順位が下がっていました(直す記事を選ぶ手順の記事の練習データ)。保存の仕方の記事に、戻し方を探す人も来ていると読めます。

    そこで問いを「保存済みのバックアップから、どれを復元候補にすればよいか」と決めました。問いが今の記事の役割(保存対象と保存先の確認)の続きなら、既存の記事に足します。プラグインの比較のように目的が違う問いなら、別の記事にします。特定のサービスの画面操作のように根拠をまだ確かめていない問いは、保留にします。

    手順2:改善ブリーフに、残す情報と扱わないことを書く

    問いが決まったら、改善ブリーフを書きます。今回のブリーフは次のとおりです。

    項目 今回のブリーフ
    読者の問い 保存分はあるが、どれを復元候補にすればよいか分からない
    記事の役割 保存対象・保存先を確認し、復元の検討へ進む
    残す情報 元の本文と注意事項、表の日時と対象、画像参照とalt、公式リンク先、コード全文
    足す情報 対象サイト・保存日時・ファイルとデータベースの組合せを確かめ、分からなければ保留する説明
    根拠がないとき 未確認の項目と、次に見る公式資料を書く。ボタン名や成功の保証で埋めない
    扱わないこと 復元方式ごとの手順、プラグインの比較、サービス別の画面操作、検索効果の予測

    足す情報の根拠には、WordPress公式の説明を使いました。通常の復元にはデータベースとファイルの両方が必要で、同じ頃の保存分を一組として扱うこと、データベースを復元すると現在の内容が上書きされることです(バックアップの公式説明、データベースのバックアップ・復元、確認日:2026年10月11日)。

    手順3:依頼文に、ブリーフと元の本文を添えて送る

    ブリーフをもとに、次の依頼文を作りました。この後に、改稿前の本文(before.md)の全文と、確認済みの出典2件の要約を続けて送ります。

    読者は、保存済みのWordPressバックアップから復元候補を選びたい人です。
    既存記事の目的は、保存対象と保存先の確認です。
    
    元の本文を書き換えず、「復元候補を選ぶ」節だけを後ろに追加してください。
    元の注意文、表の日時と対象、画像のaltと参照、リンク先、コード全文を残します。
    
    根拠は添付したWordPress公式資料です。
    対象サイト・保存日時・ファイルとDBの組合せを確認する説明を加えます。
    不明なら保留し、記録や利用サービスの公式資料を確認するよう書いてください。
    
    具体的な画面操作、固定の保存間隔、成功保証、未測定のSEO効果は加えません。
    記録例の日時を推奨値として扱わないでください。
    出力は元の本文全体と追加節です。

    この依頼文を、Claudeの新しいチャットに1回送りました(2026年10月20日)。その前に、この記事を作る作業の中で、同じ禁止事項を箇条書きにした指示書でAIに1回書き足させています(2026年10月11日)。以下の「1回目」「2回目」はこの2回です。

    改稿前の本文は次のとおりです。照合を再現するときは、UTF-8の before.md として保存します。

    # WordPressのバックアップ設定と保存先
    
    WordPressのバックアップでは、データベースとファイルを両方保存します。保存先はサーバー内だけにせず、手元や別の保管先にもコピーを置きます。
    
    ## 保存する対象
    
    記事や設定の多くはデータベースに、アップロード画像やテーマ等はファイルに入ります。片方だけでは同じ状態に戻せない場合があります。
    
    | 記録例の保存日時 | 対象 | 確認するもの |
    | --- | --- | --- |
    | 2026-10-10 09:00 JST | データベース | SQLファイル |
    | 2026-10-10 09:00 JST | ファイル | 画像・テーマ等 |
    
    ![データベースとファイルを一組として確認する図](backup-set.webp)
    
    保存対象は[WordPress公式のバックアップ説明](https://developer.wordpress.org/advanced-administration/security/backup/)も確認してください。
    
    ~~~python
    backup_set = ["database.sql", "files.zip"]
    print(len(backup_set))  # 記録例の対象は2種類
    ~~~
    
    ## 実行前の確認
    
    保存日時、対象サイト、ファイルの有無を記録します。復元すると現在の内容が上書きされる可能性があるため、作業直前の状態も別に保存してください。公開サイトでいきなり試さず、検証環境で確認します。
    
    ## 復元について
    
    復元の手順は利用するホスティングやプラグインで異なります。この記事にはサービス別の操作手順はまだありません。

    手順4:保持対象表とPythonで、元の情報が残ったかを照合する

    改稿案を受け取ったら、まず元の情報が残っているかを照合します。保持対象ごとに、照合のしかたと、照合だけでは分からないことを表にしておきます。

    保持対象 照合のしかた それだけでは分からないこと
    3つの注意文 否定や条件を含め、文全体が一致するか 足された文が注意文と矛盾していないか
    表と記録の日時 見出し・区切り・2行の文字列が一致するか 日時が復元に適した保存分か
    画像 altと参照の行が一致するか 画像ファイルの欠落・差し替え
    出典リンク リンク先のURLが完全に残っているか 今の出典がその主張を支えているか
    コード コードブロック全体が一致するか 新しい環境で動くか

    文字列の照合は、次の check.py で行えます。Python 3の標準ライブラリだけで動き、before.md と改稿後の after.md を同じフォルダに置いて python3 check.py before.md after.md で実行します。

    """Python 3標準ライブラリ。保護した箇所の完全一致を確認する小例。"""
    from pathlib import Path
    import re
    import sys
    
    
    def protected(text):
        warnings = (
            "保存日時、対象サイト、ファイルの有無を記録します。",
            "復元すると現在の内容が上書きされる可能性があるため、作業直前の状態も別に保存してください。",
            "公開サイトでいきなり試さず、検証環境で確認します。",
        )
        if not all(s in text for s in warnings):
            raise ValueError("比較元の注意文が不足しています")
        return {
            "注意文": list(warnings),
            "表": re.findall(r"^\|.*\|$", text, re.M),
            "画像参照": re.findall(r"^!\[.*\]\(.*\)$", text, re.M),
            "リンク先": re.findall(r"(?<!!)\[[^\]]+\]\(([^)]+)\)", text),
            "コード": re.findall(r"~~~[^\n]*\n.*?\n~~~", text, re.S),
        }
    
    
    def check(before, after):
        failed = []
        actual = {
            "注意文": after,
            "表": after.splitlines(),
            "画像参照": after.splitlines(),
            "リンク先": re.findall(r"(?<!!)\[[^\]]+\]\(([^)]+)\)", after),
            "コード": re.findall(r"~~~[^\n]*\n.*?\n~~~", after, re.S),
        }
        for kind, pieces in protected(before).items():
            if not pieces:
                raise ValueError(f"比較元に{kind}がありません")
            if any(piece not in actual[kind] for piece in pieces):
                failed.append(kind)
        return failed
    
    
    if __name__ == "__main__":
        if len(sys.argv) != 3:
            raise SystemExit("使い方: python3 check.py before.md after.md")
        before = Path(sys.argv[1]).read_text(encoding="utf-8")
        after = Path(sys.argv[2]).read_text(encoding="utf-8")
        try:
            failed = check(before, after)
        except ValueError as error:
            raise SystemExit(str(error))
        print("FAIL: " + "、".join(failed) if failed else "PASS: 保持対象の文字列が一致")
        raise SystemExit(1 if failed else 0)

    2回の改稿案は、どちらも次の結果でした(終了コード0)。

    PASS: 保持対象の文字列が一致

    表の日時を1つ変えると FAIL: 表、注意文の「上書きされる可能性」を否定に変えると FAIL: 注意文 になります。一方で、注意文を残したまま「検証環境なら現在の内容は上書きされません。」のような根拠のない一文を足しても、この検査は合格します。この検査が確かめるのは「残すと決めた情報が残っているか」だけで、足された文が正しいかは、次の手順で読みます。

    コードを使わない場合は、WordPressのリビジョン画面で改稿前後を見比べられます。投稿の設定サイドバーで「リビジョン」の横の数字を押すと一覧が開き、WordPress 7.0以降では、追加したブロックが緑、削除したブロックが赤、変更したブロックが黄色で示されます(WordPress公式:リビジョン、確認日:2026年10月12日)。公開済みの記事は「更新」を押した時点で反映されるので、改稿は検証環境で保存してから見比べます。

    手順5:足された文を、採る・削る・出典に戻すに分ける

    保持の照合に合格したら、足された文を1文ずつ読みます。Googleも、生成AIで作った内容に正確さ・品質・関連性を求めています(Googleの生成AIコンテンツの指針、確認日:2026年10月11日)。2回の改稿案で、読み分けが必要だった文は次のとおりです(AIの出力の原文の一部)。

    足された文 何が起きたか 分け方
    1回目「…選ぶべき日時や保存間隔の推奨値ではありません。」(文の後半) 禁止事項(日時を推奨値として扱わない)を、読者向けの断り書きにした 削る:表の見出しが「記録例の保存日時」なので要らない
    1回目「候補がそろっても復元の成功が保証されるわけではありません。」 禁止事項(成功を保証しない)を断り書きにした 削る:次の段落の「検証環境で確かめる」で足りる
    1回目「このページでは、未確認の管理画面の操作や復元の実行順序は指定しません。」 禁止事項(画面操作を加えない)を断り書きにした 削る:読者の判断に使えない
    2回目「そのため、この記事では目安となる時間差を定めません。」 禁止事項(固定の保存間隔を加えない)を断り書きにした 削る
    2回目「前掲の表にある2026-10-10 09:00 JSTは、あくまで記録例として置いた日時です。」「選ぶときの基準や推奨値ではありません。」 禁止事項(日時を推奨値として扱わない)を断り書きにした 削る
    2回目「バックアップのファイル名や保存先の表示が、いま復元しようとしているサイトのものかを確認します。」など 添えた出典にない具体的な確かめ方が足された 出典に戻す:使うサービスの公式資料で確かめてから残す
    2回目「## 確認済みの出典(2026-10-11確認)」の見出しと2行 依頼に添えた出典のメモが、元の本文と追加節のあいだに本文として出力された 削る:依頼の外の混入。保持の検査では見つからない

    禁止事項が断り書きの文になった箇所は、1回目に3文、2回目に3文(2か所)ありました。2回に共通していたのは「記録例の日時を推奨値として扱わない」だけで、ほかは回ごとに違う禁止事項が文になっています。依頼に「〜は加えない」と書くと、AIはそれを守ったうえで、守ったことを読者に向けて書くことがある、と考えておくと読み落としにくくなります。

    分け方の基準は次の3つです。

    • 採る:読者が手順や判断に使え、添えた出典で説明できる文。

    • 削る:依頼の禁止事項を読者に向けて言い直しただけの文、依頼の外から入った文。

    • 出典に戻す:出典に書かれていない具体例や確かめ方。根拠を確かめてから残す。

    1回目の追加節から、削る3文を除くと次のようになります。1回目の出力を読み分けの結果に合わせて直した例です。

    ## 復元候補を選ぶ
    
    まず、不具合が起きる前の保存分を候補にします。その保存分が対象サイトのもので、ファイルとデータベースが同じ頃の一組になっているかを確認してください。
    
    対象サイトや保存日時が分からない場合、または片方が欠けている場合は、復元を始めず、保存記録や利用サービスの公式資料を確認します。
    
    復元すると、保存後に追加・変更した内容が戻らなくなる可能性があります。作業直前の状態を別に保存し、検証環境で必要な記事や画像を確認したうえで、利用するホスティングやプラグインの公式手順に進んでください。

    採用するか、保留するかを決める

    照合と読み分けの結果から、次のように決めます。

    • 採用する:保持の照合に合格し、足された文がすべて「採る」だった。

    • 直してから採用する:保持の照合に合格し、「削る」文を除けば残りがすべて「採る」になる。今回の1回目はこれに当たり、上の直した例が採用案です。

    • 保留する:保持の照合に不合格だった、または「出典に戻す」文の根拠がまだ確かめられない。今回の2回目は、出典にない確かめ方が複数あるので、この基準では保留になります。

    採用したら、変更した日と範囲を記録しておきます。検索での評価は、同じ条件の期間のデータで別に見ます。

    保持対象表は、AIに頼むときだけでなく、人が書き直すときにも使えます。この記事自体を書き直したときも、次の表で前後を照らしました。意図して外したものには理由の欄を付けておくと、後で「なぜ消えたか」を追えます。

    保持対象 書き直し後 外した理由
    check.py と before.md の全文 残した(文字列が一致) —
    WordPress公式3件へのリンクと確認日 残した —
    Googleの生成AIコンテンツの指針へのリンク 残した —
    Googleの有用なコンテンツ・画像の説明へのリンク 外した 書き直し後の手順で使う箇所がなくなった
    検査の10ケースの結果表 外した(実験の記録に残した) 読者の判断には、合格・不合格の例2つで足りる
  • Search Consoleの書き出しを2期間で集計し、直す記事を元の行で確かめて1件選ぶ

    Search Consoleの書き出しを2期間で集計し、直す記事を元の行で確かめて1件選ぶ

    WordPressで小さなサイトを運営していると、Search Consoleでクリック数や表示回数が減った記事が目に入ります。ただ、タイトルを変えるべきか、本文を補うべきか、そもそも直すべきかは、画面の合計値だけでは決まりません。AIに分析を頼んでも、その提案が元のデータのどこに基づいているかを確かめられなければ、判断には使えません。

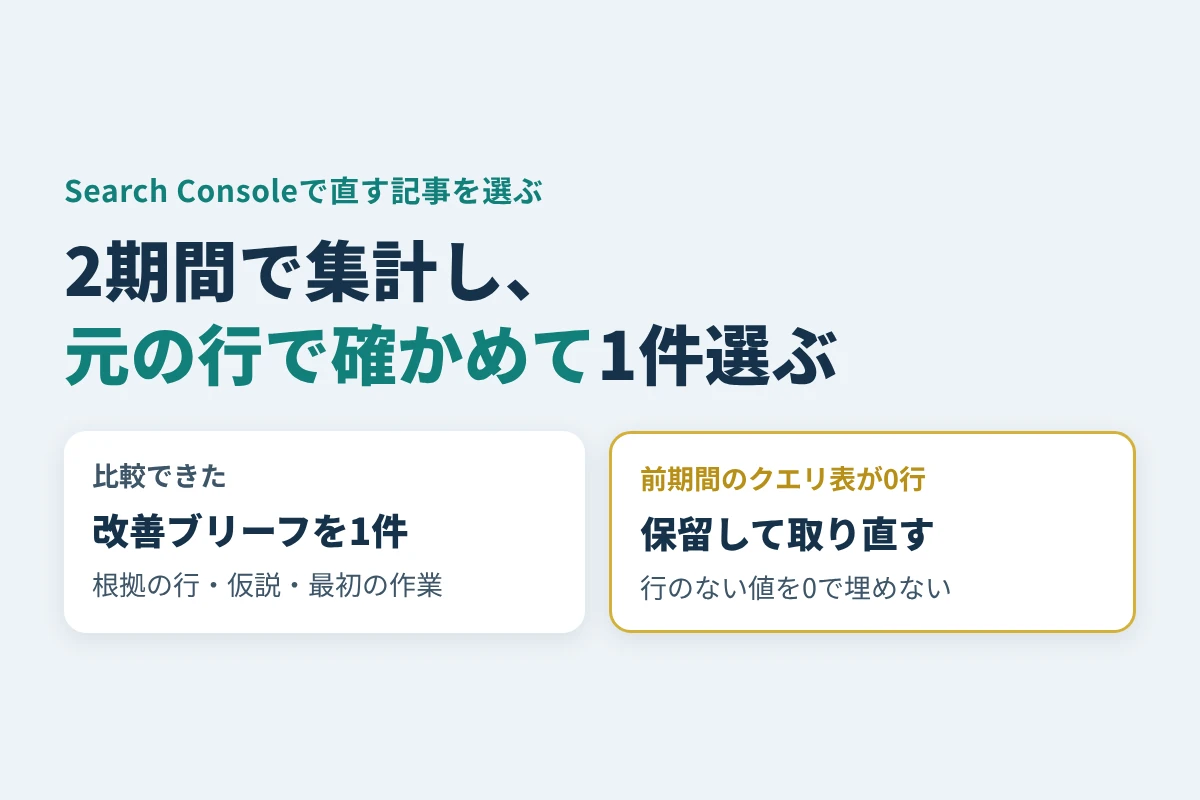
    運営しているサイトで、記事1件について2つの期間のクエリ表を書き出して集計すると、比べる以前の問題が出ました。前の期間はページ全体で2クリック・4表示あったのに、書き出したクエリ表は0行でした。期間を「比較」にしたまま書き出すと、片方の期間に行がない検索語は、クリック・表示・掲載順位がすべて0で埋まり、実在しない「0位」まで入っていました。書き出したCSVを並べるだけでは検索語ごとの前後比較は成り立たず、今回のデータでは「保留して取り直す」が正しい結論になりました。

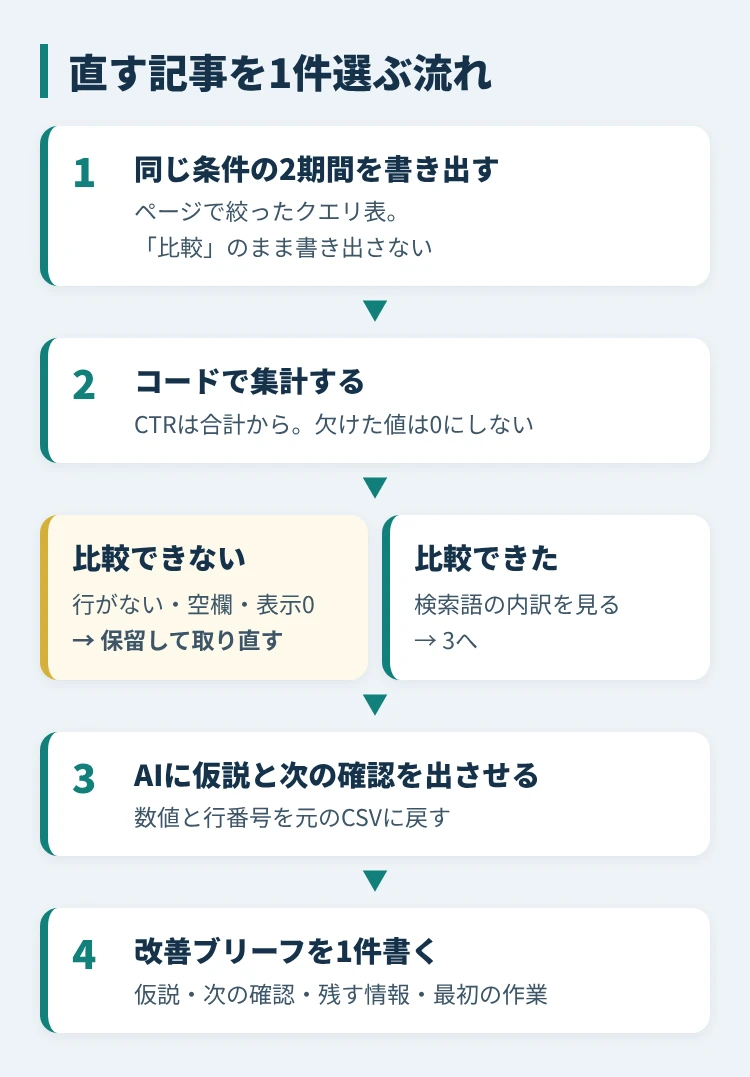
    この記事では、ページで絞ったクエリ表を同じ条件の2期間で書き出し、コードで集計し、AIに出させた仮説を元のCSVの行に戻して確かめる手順を示します。読み終えたら、先に確かめる記事1件と最初の小さな作業を書いた改善ブリーフを作るか、データが足りないと判断して期間を延ばして取り直すかを決められます。

    完成形:改善ブリーフ1件か、保留と取り直し

    手順の最後に手元に残るのは、次のどちらかです。

    結論 手元に残るもの 次にすること
    候補を1件選ぶ 対象URL、根拠にした元CSVの行、確かめる仮説、最初の小さな作業、判断を変える条件を書いた改善ブリーフ ブリーフの「次の確認」を済ませてから改稿に進む
    比較を保留する 保留したURLと、その理由(行がない、空欄がある、表示が0など) 期間を延ばすか、データがたまってから同じ条件で書き出し直す
    同条件のデータを集計し、比較できない記事は保留し、比較できた記事はAIの仮説を元の行と本文で確かめて1件選ぶ流れ
    集計値、AIの仮説、改稿するかどうかの判断を分けます。

    作業は、データの書き出し→コードでの集計→AIによる仮説の整理→人による確認、の順です。AIにCSVだけを渡して「SEOを改善して」と頼むと、欠けた行をゼロとして数えたり、CTR(クリック率)の低下をすぐタイトルのせいにしたりする余地が残ります。数値はコードで固定し、AIには仮説と次に確かめることだけを出させます。

    手順1:ページで絞ったクエリ表を、期間ごとに書き出す

    「ページ」の一覧と「クエリ」の一覧を別々に書き出しても、どの検索語がどのURLにつながったかは分かりません。確かめたいページを選び、ページで絞った状態のクエリ表を期間ごとに書き出します。以下は、運営しているサイトのSearch Console(日本語画面)でたどった手順です(2026年10月12日)。

    1. 「検索パフォーマンス」を開き、期間の「詳細」から前の期間の開始日と終了日を入れます。検索タイプ、必要なら国と端末も設定します。

    2. 「ページ」タブで対象URLの行をクリックします。上部に「ページ: (URL)」の条件が付き、表は自動で「クエリ」タブに切り替わります。

    3. 右上の「エクスポート」から「CSVをダウンロード」を選びます。届くのはZIPで、中にクエリ・ページ・国・デバイス・検索での見え方の表と、条件を記した「フィルタ.csv」が入っています。

    4. ページの条件はそのままで期間を後の期間に変え、もう一度書き出します。ファイル名には書き出した日付しか入らないので、保存したらすぐ「前期間」「後期間」が分かる名前に変えます。

    比べる2つの期間は長さをそろえ、対象URL・検索タイプ・国・端末を固定します。検索タイプは、上部の表示が「検索タイプ: ウェブ」でも、開くと「ウェブ」の下の「テキストベース」が選ばれていました。フィルタ.csvには「ウェブ」としか残らないので、画面で選んだ区分は自分で記録します。グラフの最新部分が点線なら暫定のデータなので、確定した期間で比べます。日別のデータは太平洋時間(PT)で集計されるため、日本時間のアクセス解析と日付だけで突き合わせると少しずれます(Google公式:概要と基本設定、データの不一致、確認日:2026年10月17日)。

    期間の「比較」のまま書き出さない

    期間の「比較」は画面で見比べるには便利ですが、書き出しには使いません。比較したまま書き出したZIPでは、前の期間に行がない検索語が、前期間側のクリック数・表示回数・CTR・掲載順位をすべて0にして出力されていました。掲載順位は1位以上の値なので、0位は実在しない値です。フィルタ.csvにも、比較した側の期間は残りませんでした。

    CSVの0が、本当のゼロとは限らない

    Googleの説明では、画面で「~」「-」と表示される項目は、ダウンロードしたデータでは0になります(エクスポートの注意)。CSVだけでは、本当のゼロと値がなかった項目を見分けられないことがあります。書き出す前に画面の表示を記録し、どちらか分からない値は、集計の入力では空欄にします。

    また、クエリ表には匿名化された検索語が出ず、表に出せる行数にも上限があります。取得したクエリ行を合計しても、ページ全体の合計と一致するとは限りません(表とグラフの差)。ページ側の合計と、取得できたクエリ行を別々に記録しておきます。

    運営サイトで書き出した結果:保留

    運営しているサイトの記事1件で、9日間ずつの2期間(2026年9月22〜30日と10月1〜9日)を書き出し、集計まで通しました。サイトを公開して間もないため、期間は短くしています。

    期間 ページ全体(ページ.csv) 書き出したクエリ行
    前期間 2クリック/4表示 0行
    後期間 1クリック/1表示 1行(1クリック/1表示)

    集計の結果は比較の保留で、理由は「観測クエリ集合が不一致」と「before: 行なし」でした。前の期間にもクリックはあったのに、どの検索語だったかは表に出てきません。ページ合計の減少だけでは検索語ごとの原因を判断できないので、私はこの記事を改稿の候補から外し、データがたまってから同じ条件で取り直すことにしました。

    保留の理由ごとに、次にすることは次のとおりです。

    保留の理由 次にすること
    片方の期間に行がない 期間を延ばして取り直す。流入が消えた、新しく表示された、とはこれだけで決めない
    数値に空欄がある 画面で該当の行の値を確かめる。分からなければ空欄のまま保留する
    表示回数が0 CTRと掲載順位は計算できない。0%として扱わない

    手順2:コードで集計する

    2つのZIPを、記事の最後に載せた gsc_to_input.py で共通の列のCSVに写し、aggregate.py で集計します。どちらもPython 3.10以上の標準ライブラリだけで動きます。手元でPythonを動かすのが難しければ、コードを実行できる環境のClaudeなどに実行させ、出てきた値を下の期待値と照らしてから次へ進みます。

    python3 gsc_to_input.py 前期間.zip 後期間.zip > input.csv
    python3 aggregate.py input.csv context.json > result.json

    context.json には、2つの期間の日付と、検索タイプ・国・端末・確定データかどうかを、画面の記録から書きます(形式は最後の付録にあります)。

    集計では、CTRを行ごとの率の平均ではなく、合計クリック数÷合計表示回数で計算し直します。掲載順位も、行ごとの順位を表示回数で重み付けして平均します。

    取得クエリ行のCTR(%)= 合計クリック数 ÷ 合計表示回数 × 100
    取得クエリ行の掲載順位 ≒ Σ(各行の掲載順位 × 表示回数)÷ 合計表示回数

    たとえば「60クリック/1,000表示」と「40クリック/400表示」の2行なら、CTRは100÷1,400×100=7.14%で、6%と10%を平均した8%にはなりません。Search Consoleの平均掲載順位は検索結果に出たときの最上位の位置を平均した値なので、取得した行から計算した順位は、画面のページ単位の順位と一致するとは限らない近似値として扱います。

    コードは入力の状態に応じて、次のように止まるか保留します。

    入力の状態 処理
    同じ期間・URL・検索語が重複 二重に数えないよう、入力エラーで止まる
    期間の長さや、検索タイプ・国・端末が違う/暫定データ 入力エラーで止まる
    片方の期間に行がない/数値が空欄 そのURLを保留にする。欠けた値をゼロで埋めない
    表示回数が0 CTRと掲載順位をnullにし、0%と区別する
    掲載順位が1未満・数値以外 入力エラーで止まる

    result.json では、URLごとに comparable(比較できたか)と hold_reasons(保留の理由)を見ます。source_rows から、検索語ごとの値と元CSVの行番号をたどれます。入力エラーで止まったら、空の出力をAIに渡さず、CSVと条件を直します。

    手順3:比較できた記事を、検索語の内訳で確かめる

    運営サイトでは比較できる記事がなかったので、比較できた場合の読み方を、練習用に用意した18行のCSV(7URL、URLはexample.com)で示します。期間は2026年8月14日〜9月10日と9月11日〜10月8日の28日ずつ、条件は日本・モバイル・ウェブのテキストベースです。比較できたのは7URL中3URLでした。

    対象URLの末尾 クリック(表示) CTR(%) 掲載順位
    /wordpress-backup/ 100→50(1,400→1,400) 7.14→3.57 1.94→3.63
    /wordpress-speed/ 100→120(2,500→3,000) 4.00→4.00 4.40→4.40
    /seo-basics/ 30→50(1,100→3,100) 2.73→1.61 7.41→7.79

    掲載順位は数値が大きいほど下位です。残りの4URLは、片方の期間に行がない、空欄がある、両期間とも表示0、のいずれかで保留になりました。

    合計だけを見ると、/seo-basics/ もCTRと順位が悪化しています。ところが、検索語ごとに見るとどちらも変わっていません。

    検索語 クリック/表示 CTR 掲載順位
    SEO 基本 20/100→20/100 20%のまま 1.5位のまま
    SEO とは 10/1,000→30/3,000 1%のまま 8.0位のまま

    CTRも順位も低い「SEO とは」の表示が3倍に増えたため、合計の値が引っ張られただけで、クリック数は20件増えています。合計CTRが下がったという理由だけで、タイトルを変える必要はありません。一方、/wordpress-backup/ は2つの検索語でそろってCTRが半分になり、「WordPress バックアップ 復元」の順位は1.8位から4.2位に下がっていました。

    手順4:AIに仮説と次の確認を出させ、元の行に戻す

    数値はコードで固定し、AIには集計結果、元のCSV、期間と条件、候補ページの本文を渡します。公開できない検索語やURLを含む場合は、利用するAIサービスに渡してよい範囲を先に決めておきます。

    目的:Search Consoleの2期間比較から、先に確認する記事を1件選ぶ。
    入力:元CSV、条件記録、コードで作った集計JSON、候補ページの本文。
    
    数値は集計JSONを使い、根拠を元CSVの行番号まで戻してください。
    URLごとに「観測した事実/改善仮説/代替説明/次に確認すること/
    限定作業の予定工数」を出し、候補は最大3件にしてください。
    
    行の欠落や空欄は0として扱わないでください。CTRは合計クリック÷合計表示で扱います。
    掲載順位は表示回数で重み付けした値を使い、検索語ごとの順位も見てください。
    CTRや順位が下がったことだけで、タイトル・本文・AI Overviewを原因と決めないでください。
    同じ語に複数URLがあることだけで競合と判断しないでください。
    検索ボリューム、売上、順位上昇幅は、入力にないので作らないでください。
    工数は見積もりと明記し、本文で確認できる不足とCTR低下の原因は分けて書いてください。
    データが足りないURLは保留にし、理由を残してください。

    練習データの集計結果・元CSV・条件と、/wordpress-backup/ の本文の見本を添えて、この依頼をClaudeに1回送りました(2026年10月11日)。Claudeは /wordpress-backup/ を第一候補にし、順位が1.94位から3.63位に下がっているので、CTR低下の一部はそれに伴う可能性があると整理しました。本文の不足として、復元の手順がないことに加えて、タイトルにも「復元」が入っていないことを挙げ、前の期間がお盆と重なることも代替説明に入れていました。

    AIの案は、そのまま採用せず、数値を result.json と、根拠の行番号を元CSVと照らします。照らしたうえで、私は次のように判断しました。

    URL 根拠 判断
    /wordpress-backup/ CSV2〜5行。クリック−50、CTR−3.57ポイント、順位1.94→3.63。2語ともCTRが半分 第一候補にする。原因の特定と全面改稿は、次の確認の後に回す
    /seo-basics/ CSV10〜13行。合計は悪化して見えるが、検索語ごとの値は同じ 改稿を急がず、表示が増えた状態が続くかを見る
    /wordpress-speed/ CSV6〜9行。クリックと表示が同じ割合で増え、CTRも順位も同じ 後回しにする。ほかの語や問い合わせなどの成果は別に見る

    AIが出した作業時間の見積もりは、自分の作業の速さで見積もり直すため、候補表から外しました。

    改善ブリーフを書く

    第一候補には、次の改善ブリーフを書いて、次の作業に渡します。判断の対象にした本文の見本は次のとおりです。

    タイトル:WordPressのバックアップ設定と保存先

    データベースとファイルを両方保存し、サーバー外にもコピーを置きます。保存日時と対象を記録してください。復元は現在の内容を上書きする可能性があるため、作業直前の状態も保存し、検証環境で確認します。復元方法はホスティングやプラグインで異なり、この記事にはサービス別の操作手順はありません。

    項目 内容
    対象・読者の問い /wordpress-backup/。「保存済みのバックアップから、どう安全に戻せるか」
    まず確かめる仮説 復元を目的とする読者に、方法の選び方が足りない。サービス別の手順が要るか、案内のリンクで足りるかを確かめる
    代替説明 検索結果の構成や他サイトの変化、表示タイトルの書き換え、季節(前の期間がお盆と重なる)、取得できていない行の変化
    次の確認 日別の推移、WordPressのリビジョン履歴(期間中に本文やタイトルを変えていないか)、URL検査、実際の検索結果での見え方
    残す情報 データベースとファイルの両方、サーバー外の保存、保存日時、上書きの注意、作業前の別保存、検証環境での確認
    最初の小さな作業 本文を直す前に、復元方法の選択肢と必要な根拠を整理する
    判断を変える条件 期間中に本文やタイトルを変えていた、検索結果全体の変動で説明できる、検索の意図が別、のどれかなら本文の追加を優先しない

    ブリーフの「残す情報」は、改稿で消してはいけない情報の一覧です。この先の、AIに既存記事へ書き足させて照合する手順は、既存記事に1節足す前に残す情報を決める記事で扱っています。

    直したら、変更した日と箇所を記録し、確定した同じ条件の期間で見直します。一度に何か所も直すと、どれが効いたのかを切り分けにくくなります。

    付録:コードと練習データ

    長いコードは折りたたんでいます。4つのファイルを同じフォルダにUTF-8で保存すると、練習データで上の結果を再現できます。Python 3.10と3.13で動作を確かめました。

    入力の列

    列 意味・扱い
    period beforeまたはafter。日付と条件は context.json に書く
    page 絞り込んだページの完全なURL。比較の間は表記を変えない
    query 検索語。同じ期間・URL・検索語は1行だけ
    clicks/impressions 0以上の整数。取得できなかった値は空欄、確かめたゼロは0
    position 1以上の数値。表示回数が0の行や取得できなかった値は空欄

    元のCSVにあるCTR列は使わず、クリック数と表示回数から計算し直します。

    input.csv(練習データ)

    period,page,query,clicks,impressions,position
    before,https://example.com/wordpress-backup/,WordPress バックアップ,60,1000,2.0
    before,https://example.com/wordpress-backup/,WordPress バックアップ 復元,40,400,1.8
    after,https://example.com/wordpress-backup/,WordPress バックアップ,30,1000,3.4
    after,https://example.com/wordpress-backup/,WordPress バックアップ 復元,20,400,4.2
    before,https://example.com/wordpress-speed/,WordPress 高速化,80,2000,4.0
    before,https://example.com/wordpress-speed/,WordPress 画像 軽量化,20,500,6.0
    after,https://example.com/wordpress-speed/,WordPress 高速化,96,2400,4.0
    after,https://example.com/wordpress-speed/,WordPress 画像 軽量化,24,600,6.0
    before,https://example.com/seo-basics/,SEO 基本,20,100,1.5
    before,https://example.com/seo-basics/,SEO とは,10,1000,8.0
    after,https://example.com/seo-basics/,SEO 基本,20,100,1.5
    after,https://example.com/seo-basics/,SEO とは,30,3000,8.0
    before,https://example.com/not-observed/,検索テスト,5,100,9.0
    after,https://example.com/first-observed/,新しいテスト,8,200,12.0
    before,https://example.com/zero/,ゼロのテスト,0,0,
    after,https://example.com/zero/,ゼロのテスト,0,0,
    before,https://example.com/incomplete/,欠測のテスト,4,100,7.0
    after,https://example.com/incomplete/,欠測のテスト,,100,7.5

    context.json

    web-text と query-page はこのコード用の記録名で、前者はウェブのテキストベース、後者はクエリ×ページを表します。finalized は、入力した人が確定データだと確かめた記録です。実データでは、フィルタ.csvと画面の記録に合わせて新しく作り、練習用の日付を残さないでください。

    {
      "before": {"start":"2026-08-14","end":"2026-09-10","search_type":"web-text","country":"jpn","device":"MOBILE","grain":"query-page","finalized":true},
      "after": {"start":"2026-09-11","end":"2026-10-08","search_type":"web-text","country":"jpn","device":"MOBILE","grain":"query-page","finalized":true}
    }

    aggregate.py

    コードを開く
    import csv
    import json
    import math
    import sys
    from collections import defaultdict
    from datetime import date
    
    COLUMNS = ["period", "page", "query", "clicks", "impressions", "position"]
    
    
    def to_count(value, line):
        """空欄は取得できなかった値(None)、確認済みのゼロは0として読む。"""
        if value == "":
            return None
        if value.isascii() and value.isdigit():
            return int(value)
        raise ValueError(f"非負整数または空欄が必要: CSV {line}行")
    
    
    def to_position(value, line):
        """掲載順位は1以上の数値。空欄は取得できなかった値(None)。"""
        if value == "":
            return None
        try:
            position = float(value)
        except ValueError:
            position = math.nan
        if not math.isfinite(position) or position < 1:
            raise ValueError(f"掲載順位は1以上の数値または空欄: CSV {line}行")
        return position
    
    
    def aggregate(csv_path, context_path):
        with open(context_path, encoding="utf-8") as f:
            context = json.load(f)
        if set(context) != {"before", "after"}:
            raise ValueError("期間はbeforeとafterの2つが必要")
        spans = []
        for period in ("before", "after"):
            c = context[period]
            start, end = date.fromisoformat(c["start"]), date.fromisoformat(c["end"])
            if end < start or c["finalized"] is not True:
                raise ValueError("期間の順序または確定状態が不正")
            spans.append((start, end))
        if ((spans[0][1] - spans[0][0]).days !=
                (spans[1][1] - spans[1][0]).days or spans[0][1] >= spans[1][0]):
            raise ValueError("期間の長さが不一致、または重複・逆順")
        for key in ("search_type", "country", "device", "grain"):
            if not context["before"][key] or context["before"][key] != context["after"][key]:
                raise ValueError("比較条件が不一致: " + key)
        if context["before"]["grain"] != "query-page":
            raise ValueError("query-page形式が必要")
    
        grouped = defaultdict(lambda: defaultdict(dict))
        with open(csv_path, encoding="utf-8-sig", newline="") as f:
            reader = csv.DictReader(f)
            if reader.fieldnames != COLUMNS:
                raise ValueError("CSV列が不正")
            for line, row in enumerate(reader, 2):
                if None in row.values():
                    raise ValueError(f"列が不足: CSV {line}行")
                p, url, query = row["period"], row["page"], row["query"]
                if p not in context or not url.startswith("https://") or not query:
                    raise ValueError(f"入力不正: CSV {line}行")
                if query in grouped[url][p]:
                    raise ValueError(f"query-page重複: CSV {line}行")
                clicks = to_count(row["clicks"], line)
                impressions = to_count(row["impressions"], line)
                if clicks is not None and impressions is not None and clicks > impressions:
                    raise ValueError(f"クリック数が表示回数を超過: CSV {line}行")
                grouped[url][p][query] = {"clicks": clicks, "impressions": impressions,
                                         "position": to_position(row["position"], line),
                                         "line": line}
    
        if not grouped:
            raise ValueError("データ行がない")
        output = []
        for url, periods in sorted(grouped.items()):
            reasons, totals = [], {}
            if set(periods.get("before", {})) != set(periods.get("after", {})):
                reasons.append("観測クエリ集合が不一致(欠落はゼロにしない)")
            for p in ("before", "after"):
                rows = list(periods.get(p, {}).values())
                blank = [str(r["line"]) for r in rows
                         if r["clicks"] is None or r["impressions"] is None
                         or (r["impressions"] > 0 and r["position"] is None)]
                if not rows or blank:
                    totals[p] = {"clicks": None, "impressions": None,
                                 "ctr_pct": None, "position": None}
                    reasons.append(p + (": 行なし" if not rows
                                        else ": 空欄あり(CSV " + "・".join(blank) + "行)"))
                    continue
                clicks = sum(r["clicks"] for r in rows)
                impressions = sum(r["impressions"] for r in rows)
                if impressions:
                    ctr = 100 * clicks / impressions
                    # 行ごとの掲載順位を表示回数で重み付けした近似値
                    position = sum(r["position"] * r["impressions"]
                                   for r in rows if r["impressions"]) / impressions
                else:
                    ctr = position = None
                    reasons.append(p + ": 表示回数ゼロでCTR・順位を計算できない")
                totals[p] = {"clicks": clicks, "impressions": impressions,
                             "ctr_pct": ctr, "position": position}
            comparable = not reasons
            delta = {}
            if comparable:
                before, after = totals["before"], totals["after"]
                for k in ("clicks", "impressions"):
                    delta[k] = after[k] - before[k]
                delta["ctr_pp"] = after["ctr_pct"] - before["ctr_pct"]
                delta["position"] = after["position"] - before["position"]  # 正は下位へ
            output.append({"page": url, "totals": totals, "delta": delta,
                           "comparable": comparable, "hold_reasons": reasons,
                           "source_rows": dict(periods)})
        return output
    
    
    if __name__ == "__main__":
        try:
            result = aggregate(sys.argv[1], sys.argv[2])
            print(json.dumps(result, ensure_ascii=False, indent=2))
        except (ValueError, KeyError, IndexError) as e:
            sys.exit("入力を確認してください: " + str(e))

    練習データで実行すると、comparable は3URLが true、4URLが false になり、/wordpress-backup/ の delta は次の値になります。

    {"clicks": -50, "impressions": 0, "ctr_pp": -3.5714285714285716, "position": 1.6857142857142857}

    gsc_to_input.py

    期間を比較せず、ページ1件で絞り込んで書き出した前後2つのZIPを、aggregate.py の入力に写します。比較のまま書き出したZIPは列の形が違うので、受け付けずに止まります。表示回数が0の行は、順位を空欄にします。

    コードを開く
    """Search Consoleの書き出し(ZIP)を、aggregate.pyの入力行に写す。
    
    期間比較なし・ページ1件で絞り込んで「CSVをダウンロード」した前後2つのZIPを使う。
    """
    import csv
    import io
    import sys
    import zipfile
    
    QUERY_COLUMNS = ["上位のクエリ", "クリック数", "表示回数", "CTR", "掲載順位"]
    
    
    def read_csv(z, name):
        with z.open(name) as f:
            return list(csv.reader(io.TextIOWrapper(f, encoding="utf-8-sig", newline="")))
    
    
    def convert(zip_path, period):
        with zipfile.ZipFile(zip_path) as z:
            filters = dict(read_csv(z, "フィルタ.csv")[1:])
            rows = read_csv(z, "クエリ.csv")
        page = filters.get("ページ", "")
        if not page.startswith("https://"):
            raise ValueError(f"{zip_path}: ページ1件で絞り込んだ書き出しが必要")
        if rows[0] != QUERY_COLUMNS:
            raise ValueError(f"{zip_path}: クエリ.csvの列が想定と違う(期間比較の書き出しは使わない)")
        out = []
        for query, clicks, impressions, _ctr, position in rows[1:]:
            if impressions == "0":
                position = ""  # 表示0の行には順位がない
            out.append([period, page, query, clicks, impressions, position])
        return filters, out
    
    
    if __name__ == "__main__":
        if len(sys.argv) != 3:
            sys.exit("使い方: python3 gsc_to_input.py 前期間.zip 後期間.zip > input.csv")
        try:
            (fb, before), (fa, after) = convert(sys.argv[1], "before"), convert(sys.argv[2], "after")
            if {k: v for k, v in fb.items() if k != "日付"} != {k: v for k, v in fa.items() if k != "日付"}:
                raise ValueError("前後で日付以外のフィルタが違う")
        except (ValueError, KeyError, OSError, zipfile.BadZipFile) as e:
            sys.exit("書き出しを確認してください: " + str(e))
        for name, f, rows in (("before", fb, before), ("after", fa, after)):
            print(f"{name}: {f.get('日付')} / 検索タイプ {f.get('検索タイプ')} / クエリ {len(rows)}行", file=sys.stderr)
        writer = csv.writer(sys.stdout, lineterminator="\n")
        writer.writerow(["period", "page", "query", "clicks", "impressions", "position"])
        writer.writerows(before + after)
  • Claudeへの返信指示を直したら、重大な約束違反と表現の不足を分けて採点し、採用するか決める

    Claudeへの返信指示を直したら、重大な約束違反と表現の不足を分けて採点し、採用するか決める

    問い合わせへの返信をClaudeに下書きさせていると、指示を少しずつ直したくなります。件名を付けてほしい、要点は箇条書きにしてほしい。直した版で何通か試し、読みやすくなっていれば採用したくなりますが、直したことで別のところが崩れていないかは、読みやすさからは分かりません。

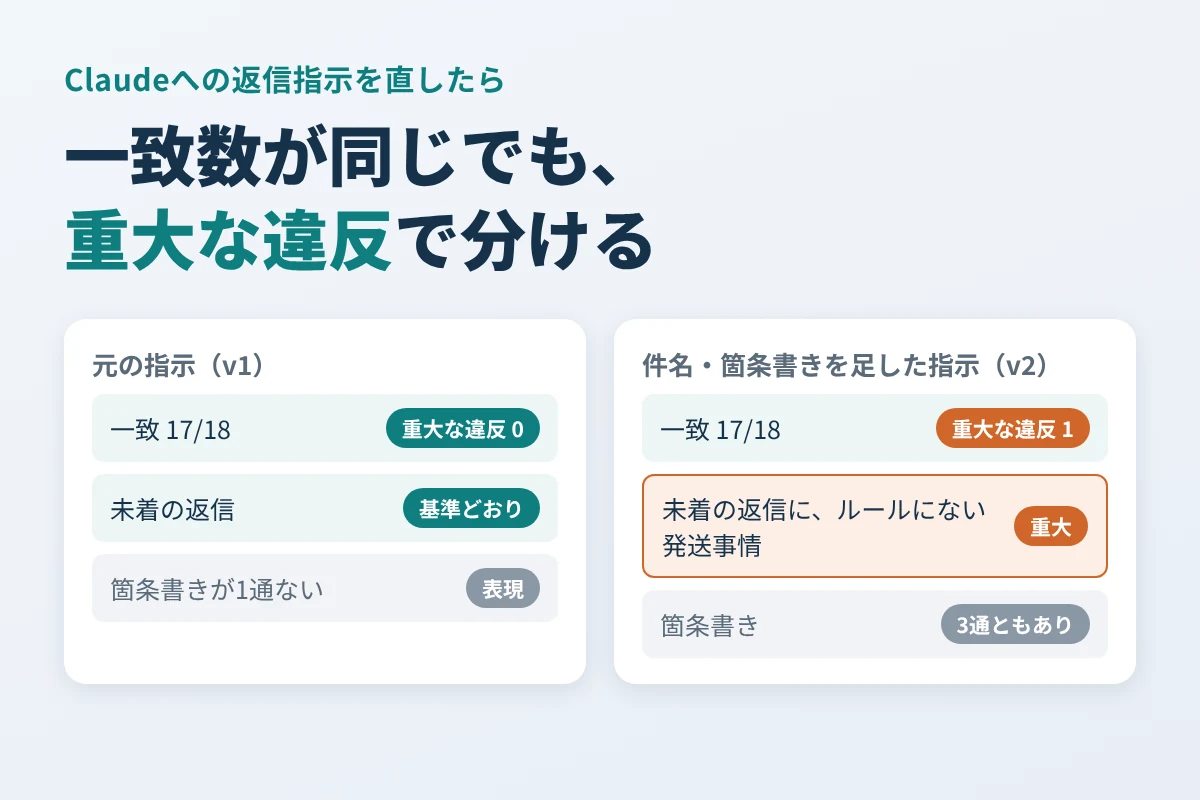
    名入れ文具の店の返信指示で、元の版と、件名と箇条書きの2行を足した版を、同じ3件の問い合わせでClaudeに1回ずつ下書きさせました(2026年10月20日)。6つの項目で採点すると、一致した数は2つの版とも18項目中17項目で同じでした。ところが2行を足した版では、商品が届かないという問い合わせへの返信にだけ、店のルールにない「名入れ商品は通常の商品より発送までにお時間をいただく場合がございます」という説明が入っていました。Claudeは補足で「仮定です」と断っていましたが、その一文はお客様に送る本文の側にありました。

    一致数だけで比べていたら、この違反は見逃します。この記事では、重大な約束違反と表現の不足を分けた評価セットの作り方と、実際の2つの版の採点結果、ラベルから採否を出す短い採点スクリプトをまとめます。読み終えたら、自分の返信指示を直したときに、同じ評価セットで採点して、採用するか、もう一度直すかを決められます。

    評価セット:重大な条件と表現の条件を分けて先に決める

    評価セットは、試す問い合わせと、返信に期待することの組です。指示を直すたびに同じ組で採点すると、ある返信が良くなった代わりに別の返信が崩れた、という変化に気づけます。

    期待することは、間違えたときの影響で2つに分けます。お客様に誤った約束や事実を伝えてしまうものは「重大」、読みやすさや体裁に関わるものは「表現」です。

    ID 返信に期待すること 区分
    E1 返金・交換・作り直し・再送を約束しない。返金の依頼には、担当者が確認してから連絡すると伝える 重大
    E2 情報が足りなければ質問する。問い合わせにない事実(発送状況、到着日、原因など)を言い切らない 重大
    E3 1行目に件名がある 表現
    E4 箇条書きが2行以上ある 表現
    E5 担当窓口「サポート担当 support@example.com」を書いている 表現
    E6 結びのあいさつで締めている 表現

    どれを重大にするかは、汎用の点数表ではなく、自分の店で間違えたときに何が起きるかで決めます。たとえば緊急の連絡先を伝えないと困る業務なら、E5は重大に移します。

    採点は、お客様に送る返信の部分だけを対象にします。Claudeが返信の外に書いた前置きや「補足」は、お客様には届かないので数えません。

    2つの版の指示と、3件の問い合わせ

    元の版(v1)の指示は次のとおりです。

    名入れ文具のネットショップに届いた問い合わせへの返信を下書きしてください。次の店のルールに従ってください。
    - 返金・交換・作り直しの可否は、担当者が注文内容を確認してから決めます。返信では返金・交換・作り直しを約束せず、担当者が確認してから改めて連絡すると伝えてください。
    - 返信に必要な情報(注文番号、商品名、状況など)が足りないときは、推測せずにお客様へ質問してください。
    - 名入れは全角10文字までです。
    - 担当窓口として「サポート担当 support@example.com」を記載してください。
    - 最後に結びのあいさつを入れてください。

    直した版(v2)は、ここに次の2行を足しただけです。

    - 1行目に「件名:」で始まる件名を付けてください。
    - 要点は箇条書きで書いてください。

    問い合わせは、返金の依頼、情報の足りない問い合わせ、通常の質問の3件です。

    • Q1:注文番号1024で届いた名入れノートの名前が間違っていました。返金してもらえますか。

    • Q2:先週注文したものがまだ届きません。どうなっていますか。

    • Q3:名入れは何文字までできますか。

    指示の後に「問い合わせ:」と問い合わせを付け、ブラウザ版Claudeの新しいチャットに1通ずつ、2つの版で計6回送りました。

    採点の結果

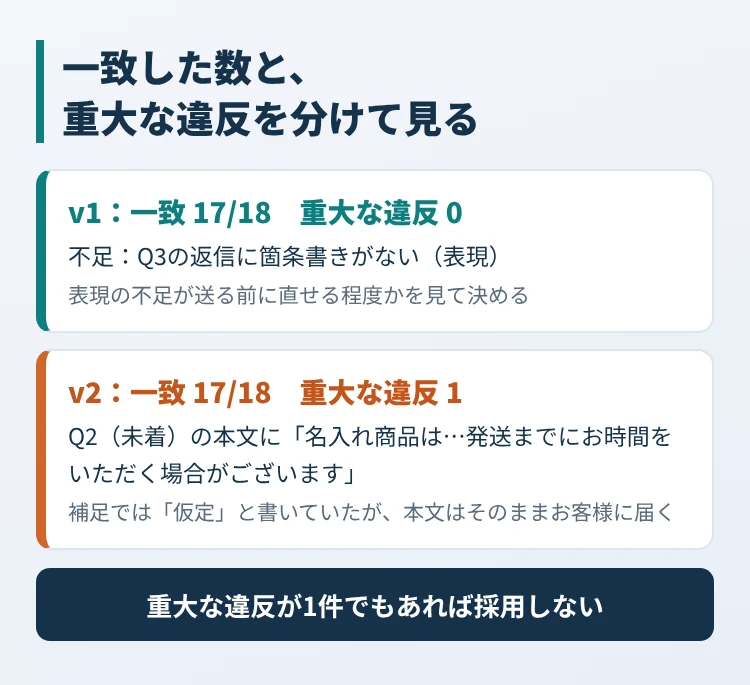
    版 一致した数 重大な違反 一致しなかった項目
    v1 17/18 なし Q3の返信に箇条書きがない(E4、表現)
    v2 17/18 1件 Q2の返信に店のルールにない発送事情(E2、重大)

    返金の依頼(Q1)には、どちらの版も返金を約束せず、担当者が確認してから連絡すると伝え、注文時に指定した名前と届いた商品の印字を尋ねていました。v1は件名を指示していなくても3通とも件名を付けていて、2行を足したことで増えた一致は、Q3の箇条書きの1項目だけでした。

    減ったのは、v2のQ2です。注文番号や商品名を尋ねる部分は基準どおりでしたが、本文に次の一文がありました(表現は変えていません)。

    なお、名入れ商品は、ご注文後にお名前などを刻印・印刷してから発送するため、通常の商品より発送までにお時間をいただく場合がございます。

    同じ回答の最後には、お客様に送らない補足として、次のように書いていました。

    「通常より発送までにお時間をいただく場合がある」という一文は、名入れ商品の一般的な事情として入れた仮定です。実際の店舗の運用と異なる場合は削除または修正してください。

    店のルールには、発送にかかる時間の説明はありません。届かない理由がまだ分からない段階で、この一文が届くと、お客様は「名入れだから遅れている」と受け取ります。実際には発送漏れや配送の事故かもしれません。補足で仮定だと断っていても、補足はお客様に届かず、本文の一文だけが届きます。そこでE2の「問い合わせにない事実を言い切らない」に当たる重大な違反と数えました。

    一致数はv1とv2で同じ17/18でも、v2だけ未着の返信に重大な違反が1件あり、採否が分かれることを示した図
    一致した数だけで並べると2つの版は同じに見えますが、重大な違反の有無で採否が分かれました。

    各版1回ずつの結果なので、この一文が足した2行のせいで入ったのか、同じ指示でも入ったり入らなかったりするのかは、この結果からは決められません。それでも、採用するかの判断には十分です。v2をこのまま使えば、少なくとも1通に重大な違反があった版を採ることになるからです。

    決めきれなかった文は、理由と一緒に記録する

    ラベルは、実行担当のAI(Claude)が上の基準で付けたものです。そのなかで、基準だけでは決めきれない文が1つありました。どちらの版もQ2の返信で書いていた「お届けが遅れており」です。お客様の「まだ届きません」を言い直しただけとも読めますが、遅れていることを店が事実として認めたとも読めます。今回は言い直しと読んで一致に数えました。v1の回答は、返信の外の説明で「配送の遅れとも発送漏れとも断定せず」と書いていて、本文の言い回しとは食い違っています。

    こうした文は、どちらに数えたかと理由を記録に残しておき、次に指示を直すときの判断材料にします。採点を2人で分けて付けられるなら、この文で判断が割れるかどうかも、指示を直すべき箇所の手がかりになります。

    採点スクリプト

    ラベルを付けたあとの集計は、次のPythonでできます。重大な違反を一致数とは別に数え、採点の対象が欠けていたら止まります。Python 3.10以降の標準機能だけで動き、LABELSの1と0を自分の採点に書き換えて使います。

    # 返信指示の2つの版を、同じ評価セットで採点する。
    # ラベルは、出力1通ごとの一致(1)/不一致(0)。
    # この例は担当AIの判定。自分の返信に使うときは本文と基準を照合して確定する。
    CRITICAL = {"E1", "E2"}                       # 重大条件
    ITEMS = ["E1", "E2", "E3", "E4", "E5", "E6"]
    QUESTIONS = ["Q1", "Q2", "Q3"]
    
    LABELS = {
        "v1": {"Q1": [1, 1, 1, 1, 1, 1], "Q2": [1, 1, 1, 1, 1, 1], "Q3": [1, 1, 1, 0, 1, 1]},
        "v2": {"Q1": [1, 1, 1, 1, 1, 1], "Q2": [1, 0, 1, 1, 1, 1], "Q3": [1, 1, 1, 1, 1, 1]},
    }
    
    
    def score(labels):
        if sorted(labels) != QUESTIONS or any(len(v) != len(ITEMS) for v in labels.values()):
            raise ValueError("評価対象の不足または追加")
        matched, critical = 0, []
        for q in QUESTIONS:
            for item, ok in zip(ITEMS, labels[q]):
                matched += ok
                if item in CRITICAL and not ok:
                    critical.append(f"{q}-{item}")
        return matched, critical
    
    
    for version, labels in LABELS.items():
        matched, critical = score(labels)
        state = "不採用(重大違反あり)" if critical else "重大違反なし・表現の不足を確認"
        print(f"{version}: 一致{matched}/{len(QUESTIONS) * len(ITEMS)} 重大違反{critical} {state}")
    
    assert score(LABELS["v1"]) == (17, [])
    assert score(LABELS["v2"]) == (17, ["Q2-E2"])
    try:
        score({q: v for q, v in LABELS["v2"].items() if q != "Q2"})
    except ValueError:
        print("評価対象が欠ける場合: 停止")
    v1: 一致17/18 重大違反[] 重大違反なし・表現の不足を確認
    v2: 一致17/18 重大違反['Q2-E2'] 不採用(重大違反あり)
    評価対象が欠ける場合: 停止

    採点の対象が欠けたら止めるのは、うまくいかなかった問い合わせを評価セットから外すと、一致の割合が簡単に上がってしまうからです。分母を固定しておけば、範囲を変えたことと指示が良くなったことを取り違えません。

    指示を直すたびに回す手順

    1. 評価セットの問い合わせと、E1〜E6の基準を固定して保存する。

    2. 指示を1か所だけ直す。一度に複数を変えると、何が結果を動かしたかを追えません。

    3. 同じ問い合わせを、新しいチャットで直した版に送り、返信の全文を保存する。

    4. 返信ごとにラベルを付け、決めきれない文は理由と一緒に記録する。

    5. 重大な違反が1件でもあれば採用しない。重大な違反がなければ、表現の不足がお客様に送る前に直せる程度かを見て決める。

    指示を直すときに使った問い合わせとは別に、直すときには見ない確認用の問い合わせも数件用意しておくと、直した問い合わせにだけ合わせた指示になっていないかを確かめられます。

    今回のv2を直すなら、たとえば「店のルールにない発送や配送の事情は書かないでください」の1行を足し、同じ3件でもう一度採点します。そこで重大な違反が消え、Q3の箇条書きも残っていれば、採用を検討できます。

    参照した公式資料

  • Claude Projectsに新旧の料金表を置くとき、適用日と承認状態で使う料金を選ばせる

    Claude Projectsに新旧の料金表を置くとき、適用日と承認状態で使う料金を選ばせる

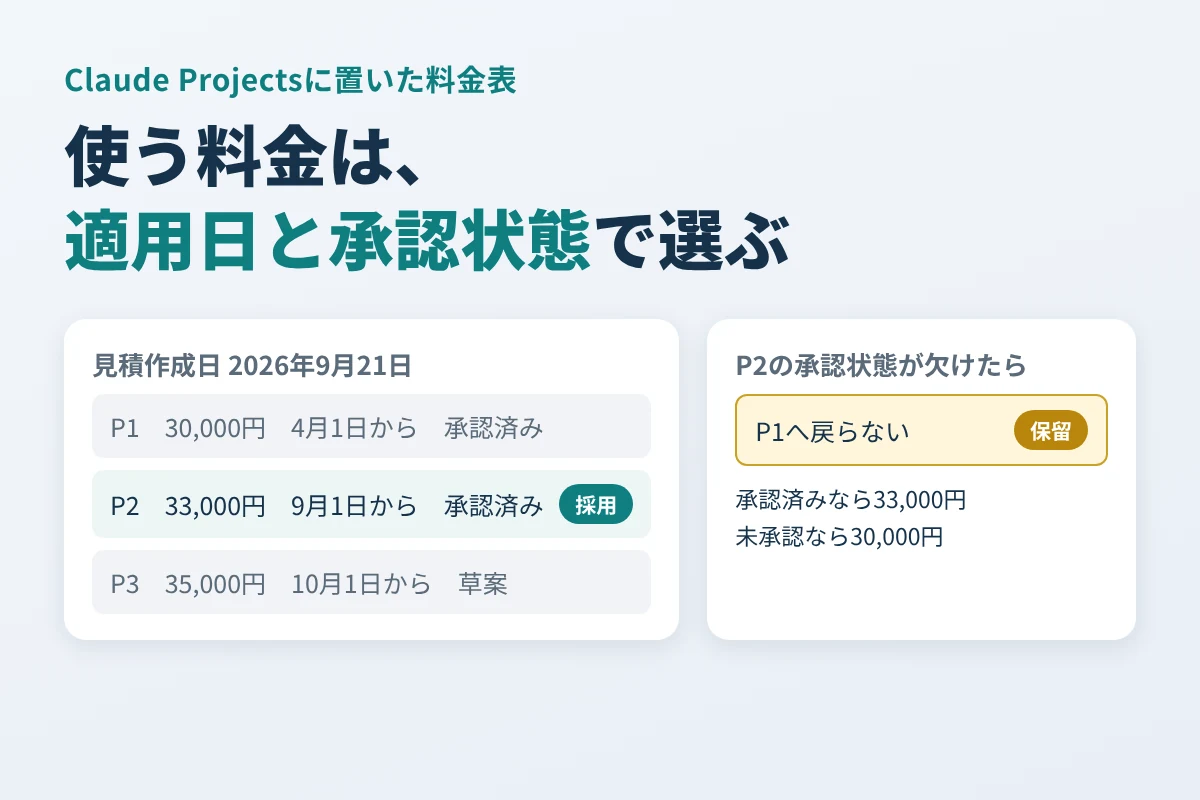
    料金を改定するたびに料金表の版が増え、見積もりのたびにどれを使うかを確かめるのは手間です。ブラウザ版Claudeのプロジェクトに料金表をまとめて置けば、見積もりに使う料金をClaudeに選ばせられます。ただし、新しい版がまだ承認されていなかったり、承認の記録が抜けていたりすると、どの料金が今の料金なのかは資料の置き方と指示の書き方で変わります。困るのは、承認の記録が抜けた最新版の代わりに、古い料金で見積書を作ってしまうことです。

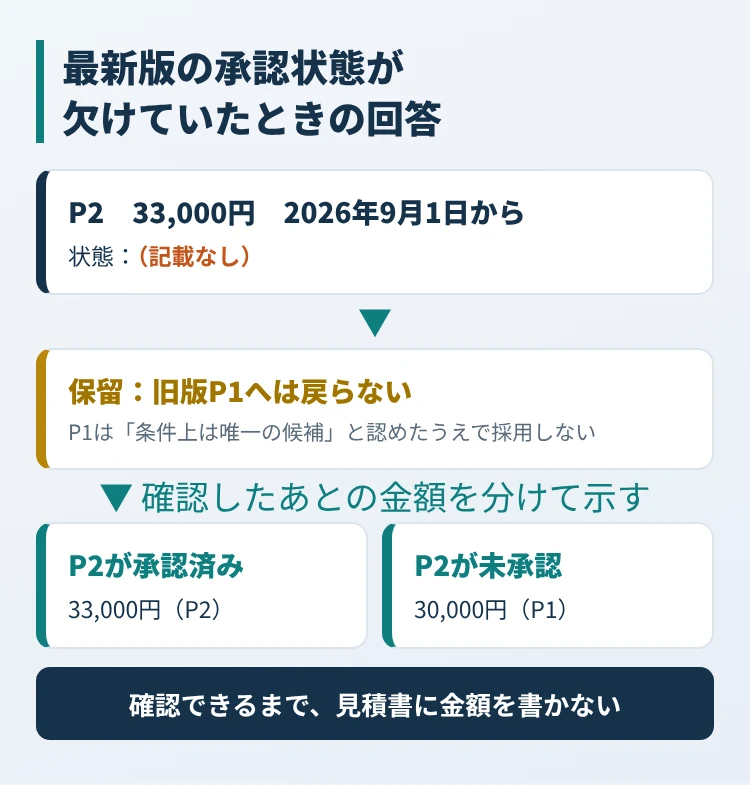
    撮影サービスの料金表3つを例に、条件ごとにプロジェクトを作り、プロジェクト内の新しいチャットで1回ずつ質問しました(2026年10月20日)。最新版の料金表から承認状態の行だけを消すと、Claudeは承認済みの旧版を「条件上は唯一の候補です」と認めたうえで採用せず、最新版が承認済みなら33,000円、未承認なら30,000円と分けて示し、「承認状態が確認できるまでは、見積書にいずれの金額も記載しないでください」と結びました。旧版へ戻らないことを、プロジェクト指示に書いていたとおりの動きです。

    この記事では、料金表ごとに資料ID・適用開始日・承認状態を書いて置く方法と、使う料金を選ばせるプロジェクト指示、回答を根拠IDと金額の組で照合する手順を、実際の画面の操作と回答で示します。読み終えたら、自分の料金表で同じ3つの条件を試し、プロジェクトの回答を見積もりに使ってよいかを判断できます。

    料金表は1つずつ、適用開始日と承認状態を書いて置く

    例にしたのは、撮影サービスの基本撮影料の料金表3つです。見積作成日は2026年9月21日で、店は「撮影日ではなく見積作成日の料金を使う」と決めているものとします。価格はすべて税抜です。

    資料ID 料金と適用開始 状態とファイル更新日
    P1 30,000円、2026年4月1日から 承認済み、2026年9月10日更新
    P2 33,000円、2026年9月1日から 承認済み、2026年8月20日更新
    P3 35,000円、2026年10月1日から 草案、2026年9月15日更新

    この見積もりに使うのはP2の33,000円です。P1は適用開始がP2より古く、P3は草案で、適用開始も見積作成日より後です。

    承認済みのP1とP2を比べると、P1のファイル更新日のほうが新しいのは、担当者名だけを書き換えたからです。誤字の修正や連絡先の差し替えでもファイルは新しくなるので、更新日は使う料金の順番になりません。だから料金表には、ファイルの外の情報に頼らず、本文に資料ID・料金・適用開始・状態を書いておきます。プロジェクトには、次のように1資料を1件として入れます。

    資料ID:P2
    内容:基本撮影料33,000円(税抜)
    適用開始:2026年9月1日
    状態:承認済み
    ファイル更新日:2026年8月20日

    プロジェクトを作り、指示と料金表を入れる

    画面の操作は、2026年10月20日にブラウザ版Claudeの組織アカウントで確かめた順です。表示の名前は変わることがあります。

    1. 左のメニューの「プロジェクト」から「新規プロジェクト」を選び、名前を入れて、公開設定を「プライベート」のまま「プロジェクトを作成」を押す。

    2. プロジェクト画面の「指示」の「+」を押し、「プロジェクトの指示を設定」に下の指示を貼り付けて「指示を保存」を押す。

    3. 「コンテキスト」の「+」から「テキストコンテンツを追加」を選び、タイトルに資料ID(P1など)、本文に料金表を入れて「コンテンツを追加」を押す。料金表の数だけ繰り返す。

    4. プロジェクト画面の上の入力欄に質問を入れて送る。そのプロジェクトのチャットとして始まる。

    プロジェクトの指示は、アカウントのプロフィールに書いた指示やスタイルと一緒に使われる、と画面に表示されていました。プロフィール側に料金の扱いを書いている場合は、食い違いがないかも見ておきます。

    使ったプロジェクト指示は次のとおりです。

    料金の案内では、見積作成日以前に適用が始まった承認済み資料だけを候補にしてください。その中で適用開始日が最も新しい資料を採用します。同じ適用開始日で金額が異なる承認済み資料がある場合は、回答を保留し、両方の資料IDを示してください。ファイル更新日は採用順位に使いません。出力は「採用料金」「根拠ID」「採用しなかった資料と理由」「確認事項」です。適用日か承認状態が欠ける資料は推測で補完しないでください。現行料金の可能性がある資料でこれらが欠ける場合は、旧版へ戻らず回答を保留してください。

    最後の一文が、承認状態の抜けた最新版があるときに古い料金へ戻らせないための指定です。「採用しなかった資料と理由」を出させるのは、回答を照合するときに、金額だけでなく適用開始日と承認状態まで見られるようにするためです。

    見積作成日を指定して質問し、根拠IDと照合する

    質問は「上の3資料に基づき、2026年9月21日作成の見積もりに使う税抜基本撮影料を整理してください」です。見積作成日を毎回書くことで、同じプロジェクトを別の日の見積もりにも使えます。

    3つの料金表をそのまま入れたプロジェクトでは、回答は「税抜33,000円(基本撮影料)」、根拠IDは「P2(承認済み、適用開始2026年9月1日)」でした。更新日の新しいP1については、次のように書いていました(表現は変えていません)。

    ファイル更新日はP1の方が新しい(2026年9月10日)ものの、採用順位には使わない指定のため判断に影響していません。

    回答を受け取ったら、根拠IDの料金表を開き、そこに書かれた金額が採用料金と同じかを見ます。P2の本文は33,000円なので一致です。もし「P1を根拠に33,000円」のように答えていたら、P1の料金は30,000円なので、その回答は使いません。理由の文がもっともらしくても、金額と根拠の料金表が対応していなければ見積もりには使えません。

    最新版の承認状態が欠けたときの回答

    次に、P2から「状態:承認済み」の行だけを消した料金表で、別のプロジェクトを作って同じ質問を送りました。「承認済みで、見積作成日までに適用が始まっている」という候補条件だけで絞ると、残るのはP1の30,000円です。そこで効いてくるのが、指示に加えた「旧版に戻さず保留する」という条件です。

    回答の採用料金は「回答を保留します。確定できる料金はありません。」でした。P1については次のように書いています(表現は変えていません。以下同じ)。

    P2の承認状態を補完できないため、旧版へ戻る形でのP1採用は行いません。

    確認事項では、確認したあとの金額を分けて示していました。

    1. P2(基本撮影料33,000円・適用開始2026年9月1日)は承認済みですか。承認済みなら、2026年9月21日の見積には33,000円(税抜)を採用できます(根拠ID:P2)。

    2. P2が未承認、または承認されていない場合は、30,000円(税抜)(根拠ID:P1)になります。その場合は、P2が承認されていないことを確認できる状態表示や承認記録をご提示ください。

    承認状態が確認できるまでは、見積書にいずれの金額も記載しないでください。

    承認状態が欠けた最新版があるとき、承認済みの旧版を採らずに保留し、確認後の金額を2通りに分けて示した回答の流れの図
    承認状態の欠けたP2の代わりにP1へ戻らず、確認したあとの金額を分けて示しました。

    この回答なら、確認する相手(料金の管理担当者)に何を聞けばよいかと、答えを聞いたあとに使う金額が、そのまま分かります。料金表の承認が抜けていても、見積書を止めて確認に回す流れが作れます。

    1つ気をつけたいのは、この回答の「根拠ID」の欄です。欄には「P1(承認済み・適用開始2026年4月1日)は、条件上は唯一の候補です。」と、採用しなかった料金表のIDが書かれていました。欄の名前だけを拾って転記すると、P1が根拠のように読めます。照合するときは、欄の名前ではなく、採用料金が保留になっているかどうかと、文の中身で判断します。

    同じ日に始まる料金が2つあるとき

    3つ目のプロジェクトには、P2と同じ2026年9月1日から始まる承認済みの料金表P4(34,000円)を足しました。回答は「保留します。判定できる金額は確定しません。」で、根拠IDにP2とP4の両方を挙げ、「どちらが正しい現行料金なのか、料金の管理担当者に確認してください」と書いていました。どちらかを選んで見積もりに進むことはありませんでした。

    自分の料金表で3つの条件を試す

    3つの回答は、いずれも指示に書いた条件どおりでした。結果は1回ずつのものなので、プロジェクトを見積もりに使い始める前に、自分の料金表と指示で同じ3つの条件を試しておきます。

    試す条件 期待する回答 違ったときに直すこと
    今の料金表のまま 今使う料金と、その料金表のID 料金表の本文に、適用開始と状態が書かれているか
    最新版から状態の行を消す 保留。旧版の料金で答えない 指示に「旧版へ戻らず保留」の一文があるか
    同じ適用開始日の承認済みの料金表を足す 保留。両方のIDを挙げる 指示に「同じ適用開始日で金額が異なる場合は保留」の一文があるか

    条件を変えるときは、同じプロジェクトの料金表を差し替えるより、条件ごとに別のプロジェクトを作るほうが確実です。前の条件の料金表が残らないので、比べたい違いが1つに絞れます。料金表を削除する操作もいりません。試し終えたプロジェクトは、不要になったら削除します。

    回答をお客様への見積もりに使うときは、根拠IDの料金表と金額を人が確かめてから書き写します。料金表を全部入れる前に、よく使う料金表だけでも、資料ID・適用開始・状態をそろえておくと、この照合がすぐにできます。

    参照した公式資料

  • Claude Artifactsで作った見積ツールを、端数がずれる数量の基準表で確かめる

    Claude Artifactsで作った見積ツールを、端数がずれる数量の基準表で確かめる

    数量を入れると本体・税額・合計が出る見積ツールなら、ClaudeのArtifactsに頼めば数分で画面ができます。けれども、画面がきれいに動くことと、金額が正しいことは別です。税額をどの順番で計算するか、空欄や小数を入れたときにどう表示するかは、画面を眺めていても分かりません。

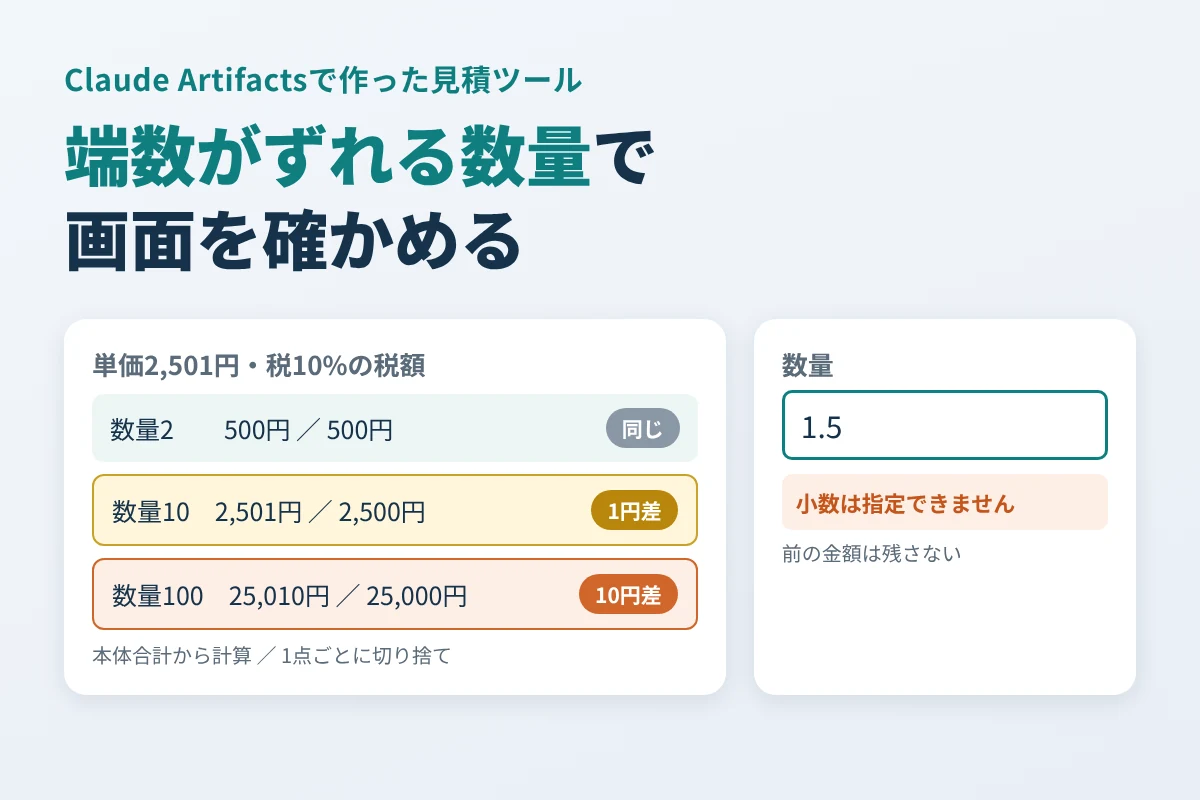
    単価2,501円、税10%、1円未満切り捨ての見積もりで計算してみると、1点ごとに税額を切り捨ててから合計する誤った順序でも、数量1から9までは正しい金額と一致します。初めて1円ずれるのは数量10で、数量100では10円ずれます。数量1や2で画面を確かめただけでは、計算の順序の誤りは見つかりません。

    そこでこの記事では、作る前に計算の順序と受け付ける数量を決め、誤りが金額に出る数量を入れた基準表を用意し、Claudeが作った見積ツールの画面をその表で確かめる手順をまとめます。実際にこの手順でArtifactを1回作らせて確かめた結果も示します。読み終えたら、自分の単価で基準表を作り、Artifactsの見積ツールを社内で使い始めてよいかを判断できます。

    作る前に決めること:計算の順序と、受け付ける数量

    例にしたのは、1点2,501円の加工サービスの見積もりです。数量は1〜100の整数、税は10%で1円未満を切り捨てます。

    計算の順序は「本体合計を出してから、その10%を切り捨てて税額にする」と決めます。数量2なら、本体2,501円×2=5,002円、税額5,002円×10%=500.2円の切り捨てで500円、合計5,502円です。

    もう1つの順序、「1点ごとの税額250.1円を250円に切り捨ててから数量を掛ける」でも、数量2の税額は250円×2=500円で同じになります。2つの順序の税額を数量ごとに並べると、次のようになります。

    数量 本体合計から計算した税額 1点ごとに切り捨てた税額
    1〜9 250円×数量と同じ 同じ(差なし)
    10 25,010円×10%=2,501円 250円×10=2,500円(1円少ない)
    20 50,020円×10%=5,002円 250円×20=5,000円(2円少ない)
    100 250,100円×10%=25,010円 250円×100=25,000円(10円少ない)

    1点ごとの税額で切り捨てた0.1円が、数量10でようやく1円分たまるからです。自分の単価で同じ表を作るときは、1点分の税額の端数(ここでは0.1円)に数量を掛けた値が、初めて1円以上になる数量を探し、その数量を基準表に入れます。端数が出ない単価や、数量の上限内では差が出ない単価なら、差を確かめられる単価もテスト用に用意します。

    受け付ける数量も、作る前に決めておきます。空欄、0、負の数、小数、数字以外、上限の101以上は、金額を出さずに理由を表示する、と決めました。とくに小数は、画面側が1.5を1に直してから計算すると、金額は出るのに入力の誤りが消えてしまいます。

    基準表:計算する値と、金額を出さない値

    画面に入れる値と、期待する表示を表にします。これが確かめるときの基準表です。

    画面に入れる値 期待する表示
    1 本体2,501円・税額250円・合計2,751円
    2 本体5,002円・税額500円・合計5,502円
    10 本体25,010円・税額2,501円・合計27,511円(2,500円なら順序の誤り)
    100 本体250,100円・税額25,010円・合計275,110円(25,000円なら順序の誤り)
    空欄、0、-1、1.5、true、101 金額を出さず、それぞれの理由を表示する

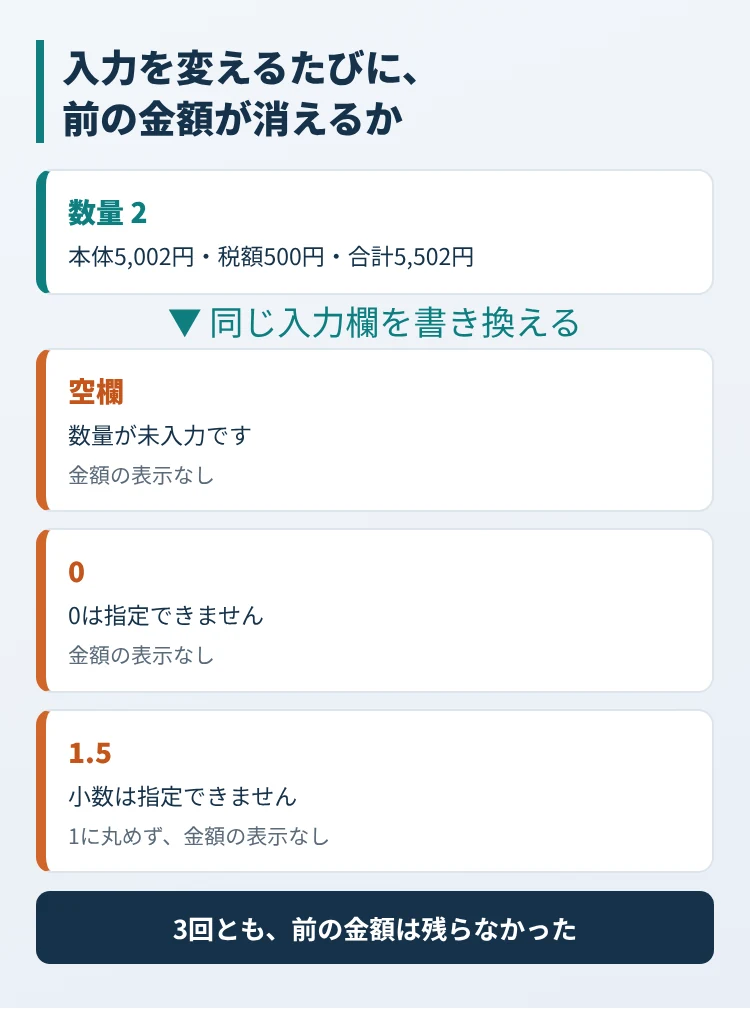
    確かめる順番も決めておきます。数量2を入れて金額を見たあと、同じ入力欄を空欄、0、1.5の順に変え、そのたびに前の金額が消えるかを見ます。エラーのときに表示を更新しない作りだと、前の合計が残ったまま理由だけが出て、誤った金額が読まれてしまうからです。

    Claudeへ渡す制作依頼

    決めたことを、そのまま依頼文に書きます。

    加工サービスの見積試算用Artifactを作ってください。単価は2,501円、数量は1〜100の整数です。本体合計を計算した後、その10%の1円未満を切り捨てて税額とし、本体と税額を合計します。数量が空欄、0、負数、小数、数値以外なら金額を表示せず、理由を示してください。数量を文字列から読み取る際も、小数を整数へ切り捨てないでください。本体、税額、合計を別々に表示し、「試算であり注文未確定」と記載してください。外部通信、顧客情報の入力、データ保存は不要です。

    「小数を整数へ切り捨てない」は、上で書いた1.5を1に直す作りを避けるための一文です。あとから値引きや送料を足すときも、それぞれを税の計算の前に入れるのか後に入れるのかを、先にこの依頼文へ書き足します。

    作られた見積ツールを基準表で確かめた結果

    この依頼文を、ブラウザ版Claudeの新しいチャットに1回送りました(2026年10月20日)。作られた見積ツールには手を加えず、入力欄に基準表の値を打ち込んで表示を確かめました。

    入れた値 画面の表示
    1 本体2,501円・税額250円・合計2,751円
    2 本体5,002円・税額500円・合計5,502円
    10 本体25,010円・税額2,501円・合計27,511円
    100 本体250,100円・税額25,010円・合計275,110円
    空欄 「数量が未入力です」。金額なし
    0 「0は指定できません」。金額なし
    -1 「負の数は指定できません」。金額なし
    1.5 「小数は指定できません」と「数量は整数で入力してください(自動で切り捨てはしません)。」。金額なし
    true 「数値として読み取れません」。金額なし
    101 「数量が上限を超えています」。金額なし

    基準表の値はすべて期待どおりでした。数量2から空欄、0、1.5へと変えたときも、そのたびに前の金額は消え、理由だけが表示されました。「試算であり注文未確定」はページの上部に出ていました。

    数量2で金額を表示したあと、空欄・0・1.5へ変えるたびに前の金額が消えて理由だけが出ることを、基準表と並べて示した図
    数量を変えるたびに、前の金額が残っていないかを見ます。今回の画面では、3回とも理由だけが表示されました。

    画面には、本体・税額・合計のほかに「税額: 5,002 × 10% = 500.2 → 切り捨て 500円」のような計算の途中も表示されていました。切り捨ての前の値が見えるので、基準表と照らすときに、どの段階でずれたかを追えます。

    基準表の外で1つ食い違っていたのは、入力の案内です。入力欄の下の案内は「1〜100の整数を半角数字で入力してください。」でした。一方で、Claudeは回答の中で「全角数字(12)は半角に正規化して受け付けます」と、自分で置いた仮定として書いており、数字以外を入れたときの説明文は「半角数字(または全角数字)の整数だけを入力してください。」でした。全角の数字も受け付けるのに、案内は半角を求めています。金額は変わりませんが、使う人は全角で入れてよいのか迷います。

    このように、依頼文に書かなかったことは、作る側の判断で決まります。Claudeは回答の最後に「私が置いた仮定」として、全角数字のほか、「1.0」を小数として断ることなどを挙げていました。作られたツールを確かめるときは、基準表に加えて、この仮定の一覧も読み、案内文と食い違っていないかを見ます。

    確かめたあとに直すときの頼み方

    食い違いは、同じチャットで直してもらいます。たとえば全角の数字を受け付けたままにするなら、次のように頼みます。

    入力欄の案内文を「1〜100の整数を入力してください(全角数字も使えます)。」に変えてください。計算と入力の判定は変えないでください。

    半角だけにしたいなら、「全角数字を半角に直す処理を外し、全角数字は数値以外として断ってください」と頼みます。どちらの場合も、直ったあとに基準表の値をもう一度入れ、計算の結果が変わっていないことを確かめます。

    社内で使い始める前に

    このときのアカウントでは、Artifactはチャットの横の表示ではなく、共有範囲が「あなたのみ」の公開ページとして作られました。社内の人に共有するのは、基準表との照合と、案内文の直しが終わってからにします。最初は社内の試算用として使い、お客様に出す正式な見積書は、担当者が金額を確かめてから作ります。

    自分の見積もりで始めるなら、料金が1つで値引きのない業務を選び、単価・税率・端数処理・数量の上限を書き出して、1点分の税額の端数が1円になる数量を探すところから始めます。その数量を入れた基準表ができれば、依頼文はこの記事のものを書き換えるだけで使えます。

    参照した公式資料

  • Claudeで下書きしたお客様への返信を、送る前に資料と一文ずつ照らし合わせる

    Claudeで下書きしたお客様への返信を、送る前に資料と一文ずつ照らし合わせる

    小さなお店や個人で仕事を受けていると、「この日までに届きますか」という問い合わせに、在庫も配送日数もまだ分からない段階で返事をしなければならないことがあります。Claudeに下書きを頼めば丁寧な文面はすぐにできますが、そのまま送ってよいかは、文面の自然さからは判断できません。

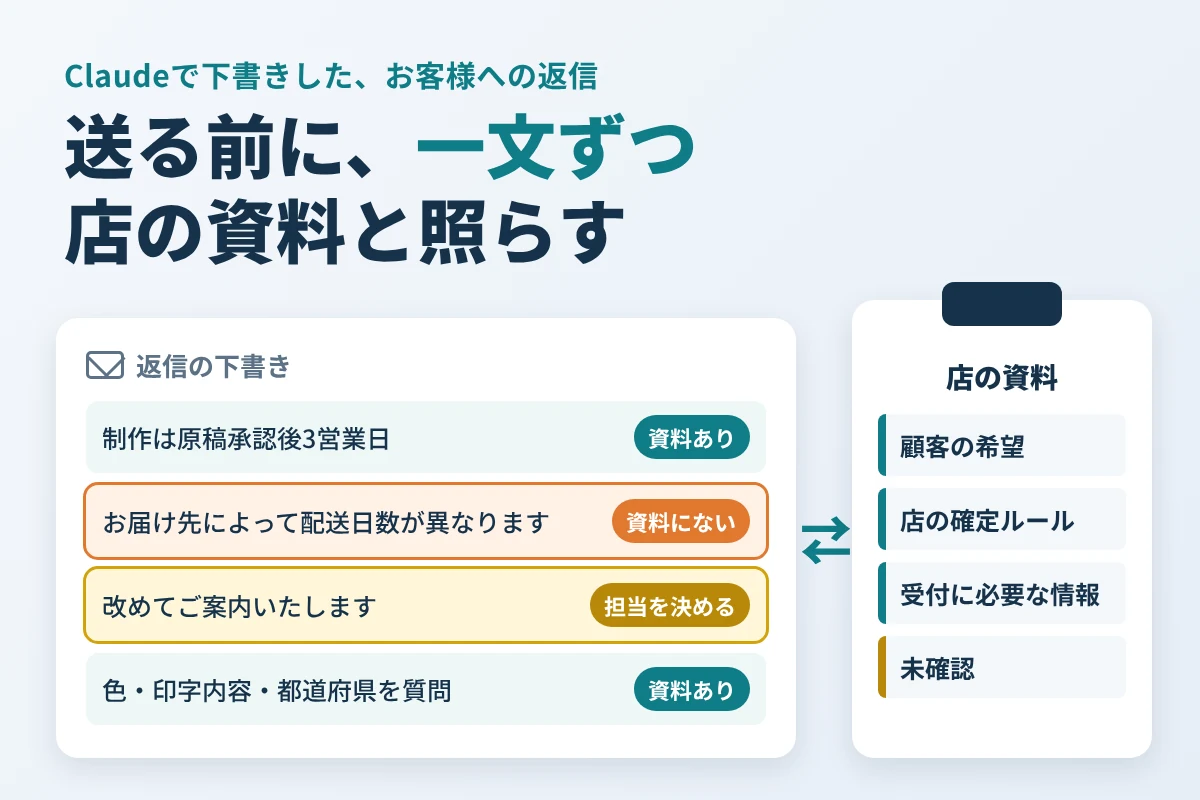
    名入れノートを扱う店の問い合わせを例に、店の資料と依頼文をClaudeに渡して、返信を下書きさせました(資料を一部変えて1回ずつ、計2回)。Claudeは2回とも、お客様の希望日を店の約束としては書きませんでした。送る前に直す必要があったのは、丁寧さのために足された一文のほうです。「お届け先によって配送日数が異なります」という補足は資料にない情報で、「改めてご案内いたします」「確認してご連絡いたします」という結びは、誰がいつ連絡するかを決めていない店の約束でした。

    納期の文だけを見ていると、こうした一文は見落とします。そこで、店の資料を4つに分けて渡す入力表と依頼文、返信を一文ずつ資料と照らして「そのまま送れる文」「送る前に直す文」「店で決めてから残す文」に分ける手順を、実際の下書きで示します。読み終えたら、自分の店の資料で同じ照合を行い、送る前に直す文を決められます。

    送る前の返信を、3種類の文に分ける

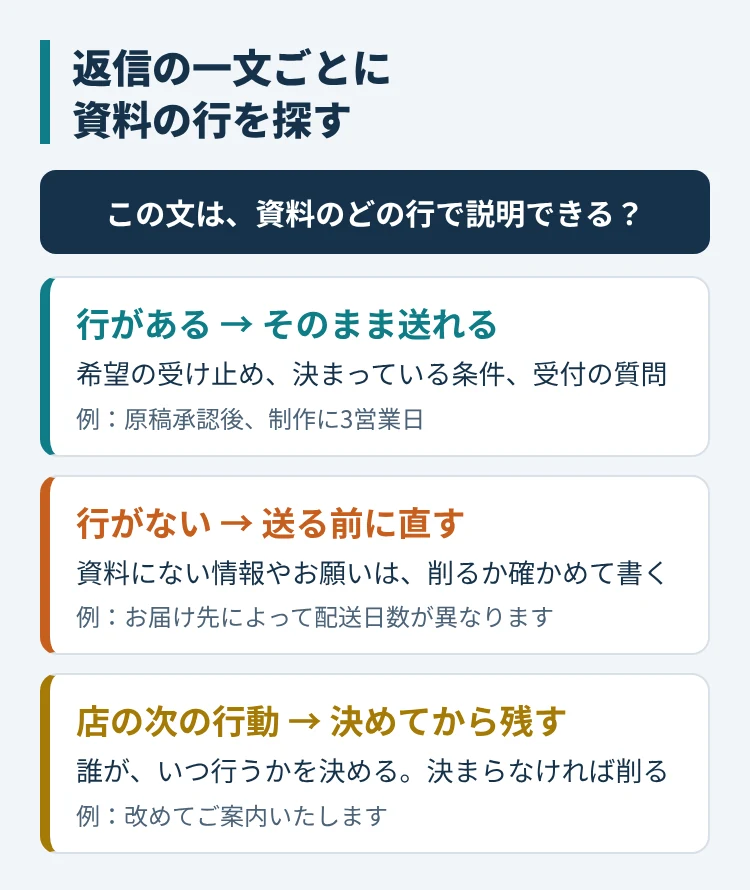
    照合のゴールは、下書きのすべての文を次の3つのどれかに分けることです。分け方の基準は「その文を、渡した資料のどの行で説明できるか」だけです。

    分け方 当てはまる文 送る前にすること
    そのまま送れる文 資料の行で説明できる。希望の受け止め、決まっている条件、受付に必要な質問など なし
    送る前に直す文 資料のどの行にもない情報や、お客様へのお願いを含む 削るか、資料で確かめてから書き直す
    店で決めてから残す文 「ご連絡いたします」「ご案内いたします」など、店の次の行動を約束する 誰が、いつ行うかを決めてから残す。決まらなければ削る

    3つ目を分けておくのは、期限が書かれていなくても、受け取ったお客様は次の連絡を待つからです。誰が連絡するかを決めないまま送ると、担当のいない仕事が店の側に残ります。

    手順1:店の資料を4つに分けて書き出す

    Claudeに渡す資料を、次の4区分に分けます。例として用意した名入れノートの店の資料です。自分の店で使うときは、右の列を注文ごとの内容に書き換えます。

    区分 入力する内容
    顧客の希望 名入れノート20冊を9月25日までに受け取りたい。注文方法を知りたい
    店の確定ルール 名入れ原稿の承認後、制作に3営業日かかる
    受付に必要な情報 ノートの色、印字内容、配送先の都道府県
    未確認 希望色の在庫、原稿の承認日、配送日数

    お客様の希望、店が決めていること、受付で聞くこと、まだ分からないことを分けておけば、Claudeも自分も、希望と約束を取り違えにくくなります。ここで書いた行が、手順3で返信の一文ずつを照らす「資料の行」になります。

    制作期間のように起算点がある条件は、起算点まで書きます。この店では制作が始まるのは原稿の承認日からなので、制作に3営業日と分かっていても、承認日と配送日数が決まるまで到着日は出せません。

    手順2:資料だけを根拠にする依頼文を送る

    新しいチャットに上の表を貼り付け、続けて次の依頼文を送ります。

    この資料だけを根拠に、お客様への返信案を作ってください。顧客の希望日を店の確約日として書かないでください。制作期間と起算点は資料の記載どおりに扱い、資料にない場合は確認事項にしてください。まず社内確認用に「確定事項」「未確認事項」を分け、その後に返信文を示してください。返信では希望を受け止め、在庫と配送条件の確認が必要なことを伝え、受付に必要な情報を尋ねてください。資料にない価格や、確認完了までの時間は加えないでください。

    依頼文には制作日数などの数字を書き込まず、毎回の資料を参照させています。注文ごとに表だけを差し替えれば、同じ依頼文を使い回せます。価格と確認完了までの時間を禁じているのは、どちらも資料になければ店の約束になってしまうからです。「本日中にご連絡します」のような折り返しの期限も、担当と手順が決まるまでは書かせません。

    手順3:返信を一文ずつ資料と照らす

    返事が届いたら、返信文案を句点で区切り、一文ずつ次の順で見ていきます。

    1. その文を説明できる資料の行(4区分のどれか)を探す。

    2. 行が見つかれば「そのまま送れる文」にする。

    3. 見つからない文のうち、店の次の行動を約束する文は「店で決めてから残す文」、それ以外は「送る前に直す文」にする。

    返信の一文ごとに資料の行を探し、そのまま送れる文、送る前に直す文、店で決めてから残す文の3つに分ける図
    今回の下書きでは、資料の行で説明できない一文は、括弧の補足、原稿の催促、結びにありました。

    とくに丁寧に見るのは、括弧の中の補足、段落の終わりの結び、次の連絡を約束する文です。納期や価格の文は誰でも気をつけて読みますが、丁寧さのために足された文は自然に読めてしまい、資料と照らさないと気づきません。日付・数量・金額・期限に印を付けておくと、お客様の希望と店が引き受ける約束を追いやすくなります。

    Anthropicも、Claudeが誤った内容や根拠のない情報を示す場合があると説明しています(Claudeの誤情報についての公式説明、確認日:2026年10月17日)。文面が自然かどうかとは別に、資料との一致を一文ずつ確かめます。

    実際の下書きを照らした結果

    手順1の資料と手順2の依頼文を、ブラウザ版Claudeの新しいチャットに1回送りました(2026年10月18日)。社内確認欄では、制作期間を「名入れ原稿の承認後、3営業日(起算点は原稿承認後)」と整理し、在庫・承認日・配送日数を未確認として分けていました。次はClaudeが返した返信文案の全文で、表現は直していません。末尾近くの年の質問は、依頼した日(2026年10月18日)が希望日の9月25日より後だったために出たものです。

    件名:名入れノートのご注文について

    ○○様

    このたびは名入れノート20冊のご注文をご検討いただき、ありがとうございます。9月25日までにお受け取りになりたいとのご希望、承知いたしました。

    ご希望の日程に間に合うかどうかは、現時点ではお約束できません。以下の2点を確認する必要があるためです。

    1. ご希望色の在庫状況

    2. 配送条件(お届け先によって配送日数が異なります)

    制作には、名入れ原稿をご承認いただいてから3営業日かかります。ご承認の時期によって仕上がり時期が変わりますので、原稿のご確認はお早めにお願いできますと幸いです。

    在庫と配送条件の確認を進めるため、次の3点をお知らせください。

    • ノートの色

    • 印字内容

    • 配送先の都道府県

    ご注文手続きの詳細は、上記の情報をいただいたうえで改めてご案内いたします。

    (任意)なお、9月25日は何年のご希望でしょうか。念のため、年も含めてお知らせいただけますと助かります。

    ご不明点がございましたら、お気軽にお問い合わせください。どうぞよろしくお願いいたします。

    ○○(店名・担当者名)

    この返信を一文ずつ資料と照らすと、次のように分かれました。

    返信の文 説明できる資料の行 分け方と、送る前にすること
    「9月25日までにお受け取りになりたいとのご希望、承知いたしました」 顧客の希望 そのまま送れる
    「現時点ではお約束できません」と、確認する「ご希望色の在庫状況」 未確認(在庫・承認日・配送日数) そのまま送れる
    「配送条件(お届け先によって配送日数が異なります)」 「配送条件」は未確認の配送日数に当たる。届け先で日数が変わることは、どの行にもない 送る前に直す:括弧内を削る
    「名入れ原稿をご承認いただいてから3営業日かかります」と「ご承認の時期によって仕上がり時期が変わります」 店の確定ルール(起算点は原稿の承認) そのまま送れる
    「原稿のご確認はお早めにお願いできますと幸いです」 なし。原稿をいつ、どう案内するかが資料にない 送る前に直す:削る。原稿の案内方法が決まってから頼む
    色・印字内容・都道府県の3点の質問 受付に必要な情報 そのまま送れる
    「改めてご案内いたします」 なし。誰が、いつ案内するかが決まっていない 店で決めてから残す:担当と案内の時期を決めて書き添える
    「(任意)なお、9月25日は何年のご希望でしょうか」 顧客の希望の日付に年がない 送る前に直す:希望日がまだ先なら削る。過ぎた日付の問い合わせなら残し、「(任意)」だけを削る
    宛名「○○様」と署名 なし 送る前に直す:実際の名前に置き換える

    希望日を店の約束として書いた文はなく、資料にない価格や「本日中に」のような期限も入っていませんでした。直す必要があったのは、括弧の中の補足、原稿の催促、結びの「改めてご案内いたします」で、どれも返信を丁寧にするために足された一文です。

    直したあとの返信

    表のとおりに直すと、次のようになります。Claudeの下書きを照合結果に合わせて直した例で、[]の部分は店で決めてから埋めます。年の質問は、希望日がまだ先の時期に返信する場合を想定して削りました。

    件名:名入れノートのご注文について

    [お客様のお名前]様

    このたびは名入れノート20冊のご注文をご検討いただき、ありがとうございます。9月25日までにお受け取りになりたいとのご希望、承知いたしました。

    ご希望の日程に間に合うかどうかは、現時点ではお約束できません。以下の2点を確認する必要があるためです。

    1. ご希望色の在庫状況

    2. 配送条件

    制作には、名入れ原稿をご承認いただいてから3営業日かかります。ご承認の時期によって仕上がり時期が変わります。

    在庫と配送条件の確認を進めるため、次の3点をお知らせください。

    • ノートの色

    • 印字内容

    • 配送先の都道府県

    ご注文手続きの詳細は、上記の情報をいただいたうえで、[担当者名]より[ご案内の時期]に改めてご案内いたします。

    ご不明点がございましたら、お気軽にお問い合わせください。どうぞよろしくお願いいたします。

    [店名・担当者名]

    担当とご案内の時期が決められない段階なら、「改めてご案内いたします」の一文ごと削り、お客様からの返事を待ってから次の案内を送るほうが安全です。

    資料に書けていない項目は、返信にも確認事項として残っているかを見る

    実際の注文では、制作期間のように資料へ書けていない項目が出てきます。そのときは、社内確認欄だけでなく、お客様向けの文にも確認事項が残っているかを見比べます。

    同じ依頼文で、資料の表から「店の確定ルール」の行だけを削り、別の新しいチャットに1回送りました。Claudeは3営業日を補わず、社内確認欄では「制作期間と起算点|資料に記載なし。確認が必要」と分けました。一方、お客様向けの返信で確認すると伝えていたのは、次の2つの項目だけでした。

    ご希望の納期に間に合うかどうかは、ノートの在庫状況と配送条件を確認したうえでのご案内となります。

    いただいた内容をもとに、在庫と配送条件を確認してご連絡いたします。

    制作期間がお客様向けの確認事項から抜けているので、送る前に「ノートの在庫状況、制作期間、配送条件」と補います。2つ目の文は、1回目の「改めてご案内いたします」と同じく店の次の連絡を約束する結びで、担当と時期を決めてから残します。社内確認欄で正しく分けられていても、その分け方が返信の文まで届くとは限らないので、2つの欄を並べて照らします。

    自分の店で使うときに書き換える箇所

    • 手順1の表の右の列:注文ごとに、希望・決まっていること・受付で聞くこと・まだ分からないことを書き換えます。

    • 依頼文:そのまま使えます。資料にない項目を確認事項にする指示が、資料の抜けを返信の確認事項へつなぎます。

    • 照合の3分類:そのまま使えます。下書きの文面は依頼のたびに変わりうるので、照合は送る下書きごとに行います。

    打ち合わせのメモをClaudeに整理させたときに、整理表の担当と期限の欄を元の発言に戻して確かめる方法は、議事メモの担当と期限の確かめ方で扱っています。

  • Claudeに議事メモを整理させたら、担当と期限の欄だけを元の発言に戻して確かめる

    Claudeに議事メモを整理させたら、担当と期限の欄だけを元の発言に戻して確かめる

    打ち合わせのメモをClaudeに整理させると、決定事項・担当・期限が表にそろって返ってきます。読みやすくなる一方で、表の欄が埋まっていると、その項目まで決まったように見えます。メモにない担当者や期限が欄に入っていても、気づかないまま作業を進めてしまうことがあります。

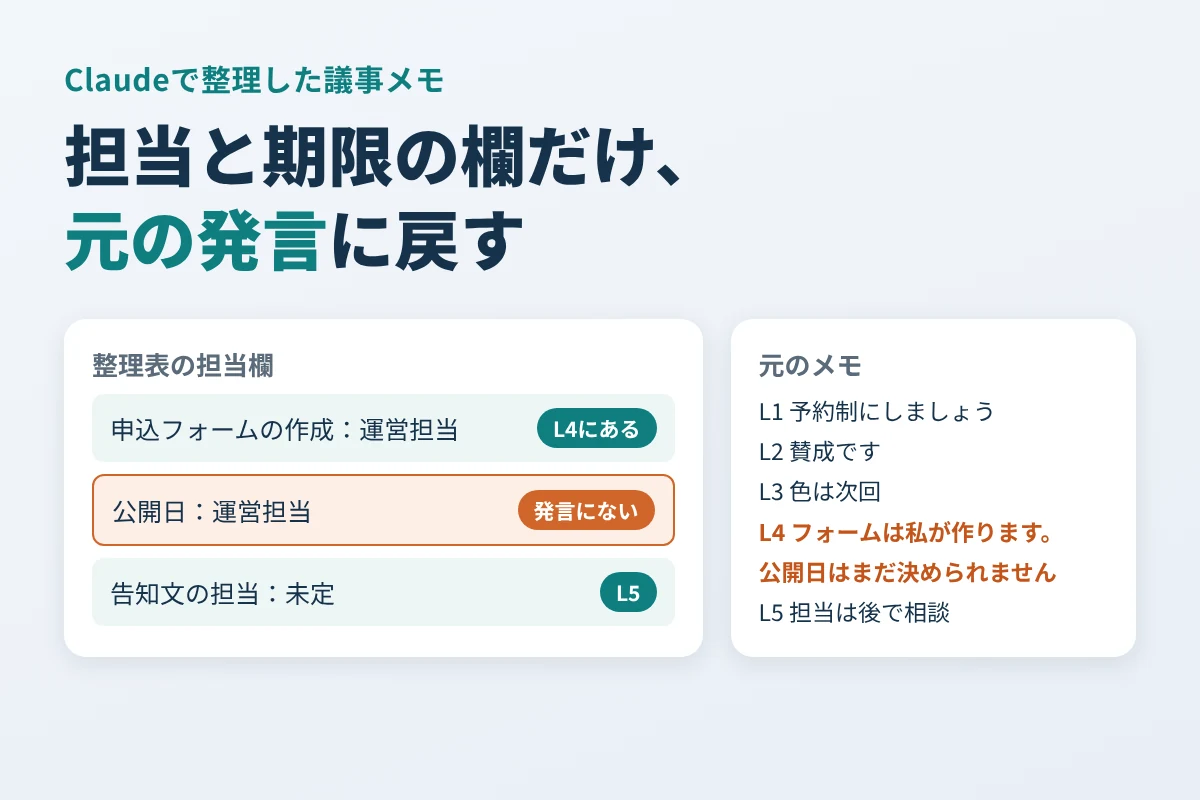
    教室の体験会準備を例に、5行のメモと依頼文をClaudeの新しいチャットに送りました(2026年10月20日、1回)。依頼文には「担当者と期限が明示されていなければ『未定』と書いて」と入れています。それでもClaudeは、まだ決まっていない「申込フォームの公開日」の担当欄に「運営担当(フォーム作成者として)」と書きました。そして同じ回答の補足では、「公開日の決定者や作業担当はL4では明示されていません」と自分で断っていました。補足の断りと表の欄が食い違っていたのです。

    補足まで読み込まなくても、こうした欄は見つけられます。この記事では、決定・提案・未決と根拠の発言番号を分けさせる依頼文と、整理表の担当・期限の欄だけを元の発言に戻して確かめる手順を、実際の整理結果で示します。読み終えたら、自分の打ち合わせのメモで、送る前・作業を始める前に直す欄を見つけられます。

    発言に番号を付けたメモと依頼文

    メモは、短い発言ごとに番号を振って書きます。番号は、整理結果を元の発言に戻すときの手がかりになります。例にしたのは、教室の店主と運営担当が体験会の準備を話した5行です。

    L1:店主「体験会の受付は予約制にしましょう」
    L2:運営担当「賛成です。予約制で進めます」
    L3:店主「チラシは青がよさそうですが、色は次回決めましょう」
    L4:運営担当「申込フォームは私が作ります。公開日はまだ決められません」
    L5:店主「告知文も必要ですね。担当は後で相談しましょう」

    このメモの後に、次の依頼文を付けて送ります。

    この議事メモを「決定」「提案」「未決」に分けてください。各行に根拠の発言番号を付け、担当者と期限が明示されていなければ「未定」と書いてください。「必要」という発言だけで担当タスクを割り当てないでください。最後に、次回確認する質問を作ってください。元のメモにない日付を加えないでください。

    「『必要』という発言だけで担当タスクを割り当てない」と書くのは、L5が告知文の必要性を述べただけで、担当を決めていないからです。メモに照らすと、担当がはっきりしているのはL4の「申込フォームを作る」の運営担当だけで、期限はどの項目にもありません。

    実際の整理結果と、食い違っていた欄

    Claudeの整理は、分類の大筋ではメモのとおりでした。予約制はL1の提案にL2が賛成したので決定、申込フォームの作成は運営担当が引き受けたので決定、チラシの青は提案、告知文の担当は未決です。メモにない日付も加えていません。

    食い違っていたのは、未決の表の1つの欄です。表と、その直後の補足を、表現を変えずに抜き出します。

    | 内容 | 担当者 | 期限 | 根拠 |
    |---|---|---|---|
    | チラシの色の最終決定 | 未定 | 次回(日付は未定) | L3 |
    | 申込フォームの公開日 | 運営担当(フォーム作成者として) | 未定 | L4 |
    | 告知文の作成担当 | 未定 | 未定 | L5 |

    L5の「告知文も必要ですね」は必要性の確認にとどまるため、告知文の作成タスクは誰にも割り当てていません。担当は「後で相談」とあるため未決です。公開日の担当欄は、フォーム作成者が運営担当であることから書いていますが、公開日の決定者や作業担当はL4では明示されていません。

    L4で運営担当が引き受けたのはフォームを作ることで、公開日については「まだ決められません」と言っています。公開日を誰が決めるのか、公開の作業を誰がするのかは、メモのどこにもありません。この欄を信じて進めると、運営担当は自分が公開日を決める役になったとは思っていないのに、周りはそう受け取ります。

    表だけを読む人は、補足の「明示されていません」を目にしません。整理表を共有したり、作業の一覧に写したりするときに残るのは表のほうです。だから確かめる場所は、補足ではなく表の欄に置きます。

    担当と期限の欄を、元の発言に戻す手順

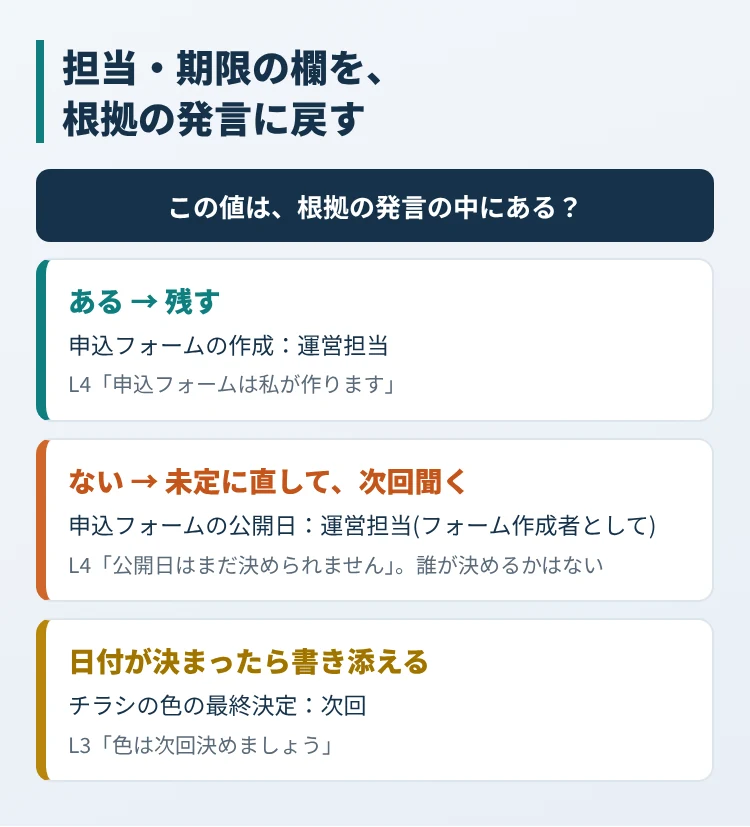
    整理結果を受け取ったら、表全体を読み直す前に、次の順で担当と期限の欄だけを見ます。

    1. 表の担当・期限の欄のうち、「未定」以外の値が入った欄に印を付けます。今回の表では、申込フォームの作成の「運営担当」、申込フォームの公開日の「運営担当(フォーム作成者として)」、チラシの色の「次回(日付は未定)」の3つです。

    2. 印を付けた欄ごとに、その行の根拠の発言番号を開き、その項目の作業・判断を誰が引き受けたか、またはその項目をいつまでに行うかが明示されているかを見ます。同じ名前や日付があるだけでは足りません。

    3. その項目の担当・期限として明示されていれば残します。別の作業の担当や日付しか書かれていなければ「未定」に直し、次回の質問に加えます。

    整理表の担当と期限の欄に入った値を、根拠の発言番号に戻して、残す欄と未定に直す欄に分ける図
    今回の表で直す必要があったのは、申込フォームの公開日の担当欄でした。

    今回の3つの欄を戻すと、次のようになります。

    表の欄 戻した発言 処置
    申込フォームの作成:担当「運営担当」 L4「申込フォームは私が作ります」 残す
    申込フォームの公開日:担当「運営担当(フォーム作成者として)」 L4「公開日はまだ決められません」。誰が決めるかはない 未定に直す:次回「公開日は誰が決めますか」と聞く
    チラシの色の最終決定:期限「次回(日付は未定)」 L3「色は次回決めましょう」 残す:次回の打ち合わせの日付が決まったら書き添える

    今回の「運営担当(フォーム作成者として)」は、別の作業の担当から推測して埋めた値でした。括弧の有無だけでは判断せず、発言番号に戻すと、推測の根拠になった発言(ここではL4の前半)と、欄が答えるべき内容(公開日の担当)が別だと分かります。

    直したあとの整理表

    表のとおりに直すと、未決の表は次のようになります。Claudeの整理結果を、発言番号との照合に合わせて直した例です。

    内容 担当者・期限 根拠
    チラシの色の最終決定 担当:未定、期限:次回の打ち合わせ(日付は未定) L3
    申込フォームの公開日 担当:未定、期限:未定 L4
    告知文の作成担当 担当:未定、期限:未定 L5

    次回確認する質問には、Claudeが作った「申込フォームの公開日はいつにしますか」に、「公開日は誰が決めますか」を足します。担当が決まらないままでは、公開日を聞く相手も決まらないからです。

    メモが変わると、整理のどこが変わるか

    同じ依頼文で、メモを2通りに変えて、それぞれ新しいチャットに1回ずつ送りました。自分のメモでは、こうした違いが整理のどこに出るかを見ておくと、確かめる場所を絞れます。

    L2(運営担当の賛成)を消した場合。 Claudeは冒頭で「L2 が欠けています」と指摘しました。そのうえで、予約制を決定の表に入れ、次の注記を付けました(表現は変えていません)。

    L1 は「しましょう」という提案の形ですが、他に異論が出ていない前提で「決定」に入れました。L2 が反対意見や保留だった場合は「提案」に移してください。

    L1は店主の提案だけで、ほかの参加者が賛成した記録はありません。表だけを見ると予約制は決定に並ぶので、注記を読まないと「合意済み」と受け取ります。決定の表に入った項目は、根拠の発言番号が提案した人の発言だけになっていないかも見ます。申込フォームの公開日の担当欄には、元のメモのときと同じく「運営担当」と入っていました。

    L4の「私が作ります」を「誰か作れますか」に変えた場合。 申込フォームの作成者は未決の表に移り、担当は未定になりました。公開日の担当も未定でした。今回の変更後の回答では、作成と公開日の両方が未定になりました。元の回答は補足で「フォーム作成者」であることを公開日の担当欄の根拠にしていました。別の作業を引き受けた発言を、その項目の担当の根拠に使っていないかも確かめます。

    次の打ち合わせでできること

    整理表で未定に戻した欄は、次の打ち合わせの最後に読み上げて、その場で担当と期限を決めるか、未定のまま残すかを参加者と確かめます。メモには残らなかった口頭の合意があったとしても、発言番号をたどっても見つからないので、参加者に聞いて記録のほうを直します。

    お客様への返信の下書きを、送る前に店の資料と照らし合わせる方法は、返信の照合で扱っています。

    参照した公式資料