AIにWordPressサイトのSEO診断を頼むと、noindex、canonical、見出し、速度などの指摘が重要度つきで並びます。どれも直したほうがよさそうに見えますが、指摘の中には、AIが渡された資料から確かめられたことと、資料にないことを推測で言い切ったことが混ざっています。どちらなのかを見分けないまま直すと、必要のない修正をしたり、本当に直すべき設定を後回しにしたりします。
例として用意したHTML・robots.txt・sitemapと、各ページの目的(検索に出したいかどうか)を5件分まとめてClaudeに渡し、普段どおりにSEO診断を頼みました。掲載したいページにnoindexとクロールの遮断が両方あるような、目的と食い違う設定の判断は、5件とも公式仕様と合っていました。一方で、本文だけの断片には、headとtitleがないこと、本文が薄いことを重要度「高」で断定し、同じ回答の中で、保存のときに一部しか保存されなかった可能性があるので配信中のHTMLを先に確かめるように、とも勧めていました。採ってよい助言と、確かめずに直してはいけない断定が、1つの回答に並んでいたのです。
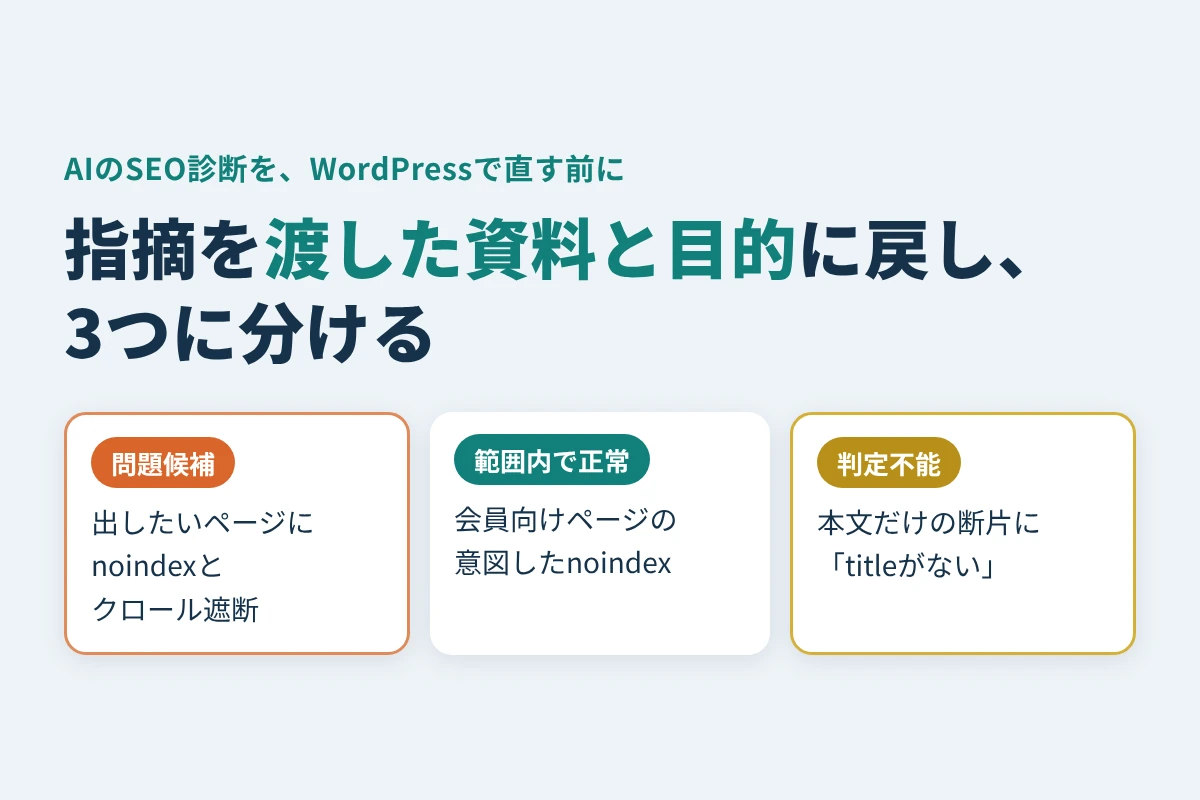
この記事では、AIの指摘を1つずつ「渡した資料」「ページの目的」「公式仕様」に戻し、「問題候補」「確認した範囲では正常」「判定不能」の3つに分ける手順を、この診断結果で示します。読み終えたら、どの指摘を直し、どの指摘のために情報を集め直し、WordPressのどこを見に行くかを決められます。
完成形:指摘を3つに分けた判定表
手順の最後には、指摘ごとに次の3つのどれかを付けた表が手元に残ります。
| 分け方 | 当てはまる指摘 | 次にすること |
|---|---|---|
| 問題候補 | 渡した資料で確かめられ、ページの目的と食い違う(検索に出したいのにnoindexがある、など) | 公開中のページでも同じかを確かめ、設定の出力元を探す |
| 確認した範囲では正常 | 渡した資料の範囲では、目的どおりになっている | 何を確かめたか(ファイルと取得日時)を残す。資料にない項目は別に確かめる |
| 判定不能 | 資料に含まれていない、ページの目的が分からない、実測値がない | 必要な資料を集めてから判断する |
「問題候補」は、すぐ直せという意味ではありません。検索に出す必要のないページなら、noindexは目的どおりです。「正常」にも、何を確かめた結果かを添えます。HTMLに望まない指定がなくても、HTTPのヘッダーから別の指定が出ている可能性は残るからです。
手順1:AIに渡した資料と、ページの目的を書き出す
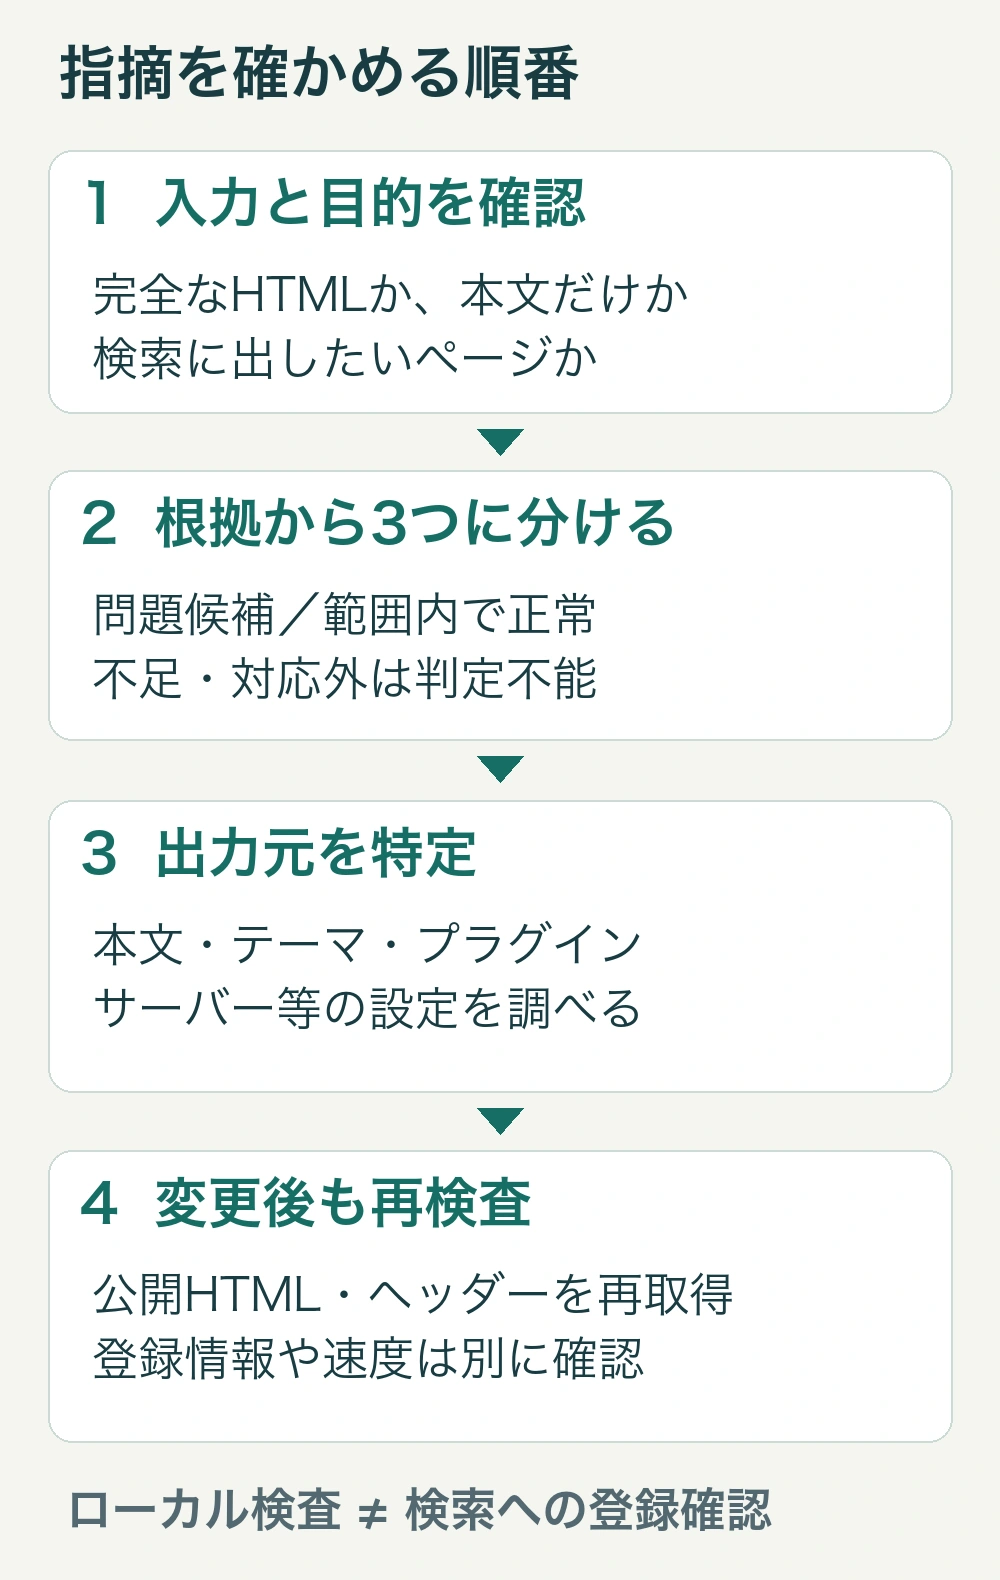
まず、診断の前提を2つ書き出します。
-
渡した資料:完全なHTMLか本文だけの断片か、取得した日時、HTTPヘッダー・robots.txt・sitemapを渡したか。
-
ページの目的:検索結果に出したいか、出したくないか。代表にしたいURL(canonical)はどれか。
今回は、5つのページの目的と保存ファイルを、ツールを使わずに資料だけで答えるよう指示して、Claudeに1回送りました(2026年10月12日)。依頼文は「ケースごとに問題点と修正案を、重要度(高・中・低)付きで」という、普段頼むのに近い形だけにしました。
| ケース | 渡した資料 | ページの目的 |
|---|---|---|
| A | 本文だけの断片(<h1> の1行) |
検索に出したい |
| B | noindexのある完全なHTML | 会員向けで、検索に出したくない |
| C | H1が2つ、コメントとscriptの中にnoindexの文字があるHTML | 検索に出したい |
| D | noindexのあるHTMLと、そのパスを遮断するrobots.txt | 検索に出したい |
| E | WordPress標準に近いrobots.txtとsitemap index | 検索に出したい |
手順2:指摘を、資料と目的と公式仕様に戻す
次に、AIの指摘を1つずつ、渡した資料に実際に書かれていること、ページの目的、公式仕様の3つに照らします。今回の回答の主な指摘と、照らした結果は次のとおりです。
| ケース | AIの主な指摘 | 照らした結果 | 分け方と次の確認 |
|---|---|---|---|
| A 断片 | headとtitleがない、本文が薄い(どちらも重要度「高」)。同時に、配信中のHTMLを先に確かめるよう勧めた | 渡したのは断片なので、headの欠落も本文の薄さも資料からは言えない | 判定不能。断定は採らず、配信HTMLの確認を採る |
| B 会員向け | noindexの削除は勧めず、noindexは閲覧の制限にはならないこと、sitemapから外すことを挙げた | noindexは検索結果への掲載を防ぐ指示で、閲覧は制限しない。sitemapには検索に出したいURLを入れる | 確認した範囲では正常。会員限定ならログインでの制限を検討し、sitemapの生成元を確かめる |
| C 見出し | コメントやscriptの中のnoindexは効いていない。H1が複数でも問題ない | どちらもrobots metaとして読まれる要素ではない。Googleのガイドに理想の見出し数はない | 確認した範囲では正常。2つ目をh2にするかは内容で決める |
| D 二重の遮断 | noindexとクロールの遮断で二重に止めていて、片方だけ直しても解決しない | クロールできなければnoindexは読まれない | 問題候補。最優先で両方の出力元を確かめる |
| E WordPress標準 | robots.txtは標準どおりで問題ない。sitemap indexに対象URLが載っていない可能性 | robots.txtは最も長く一致する規則が使われるので、対象パスは遮断されない。投稿か固定ページかは資料にない | robotsは確認した範囲では正常。sitemapは判定不能で、子sitemapを開いて確かめる |
ケースAの回答には、次の行がありました(Claudeの回答の原文の一部)。
<head>がなく、<title>もない。検索結果の見出しはGoogleが自動で作るため、ページの中身が伝わらない最初に確認すること: 保存のときに一部しか保存されなかった可能性があります。修正の前に、ブラウザの「ページのソースを表示」かSearch ConsoleのURL検査で、実際に配信されているHTMLを確かめてください。
前者は資料の外の断定で、後者はその断定を確かめるための正しい助言です。重要度「高」の表だけを読んで直し始めると、後者を読み飛ばします。指摘を表から拾うときは、同じ回答の中の「確認すること」まで読みます。
5件すべてに共通して、タイトルが汎用的なこと、viewportとmeta descriptionがないことも指摘されましたが、これは例として簡略化したファイルの性質です。自分のページで同じ指摘が出たら、公開中のHTMLで確かめる項目として扱います。
照らすときに使う公式仕様は、主に次の4つです(いずれも確認日:2026年10月12日)。
-
noindexはHTMLのrobots metaか、HTTPの
X-Robots-Tagで指定する。robots.txtでクロールを遮断すると、noindexは読まれない(Googleのnoindexの説明)。body内のrobots metaも認識される(robots metaの仕様)。 -
canonicalは代表にしたいURLを伝える強いシグナルだが、指定どおりに選ばれる保証はない。別のURLを意図して代表にしているページもある(正規URLの説明)。
-
robots.txtは、最も長く一致する規則が使われる(robots.txtの仕様)。WordPressが標準で出すrobots.txtには
Allow:の行があり、標準のsitemapはsitemap indexになっている(WordPressのrobots.txt生成)。 -
見出しの数に理想の値はない(Google SEOスターターガイド)。
手順3:判定表に、WordPressで見る場所を書き足す
問題候補と判定不能の指摘には、WordPressで最初に見る場所と、変更したあとの確かめ方を書き足します。記事の本文を書き直しても、head内のcanonicalやHTTPヘッダーは変わらないことがあります。
| 症状・確かめる対象 | 最初に見る場所 | 変更後の確かめ方 |
|---|---|---|
| 記事の見出し・説明・本文のリンク | 記事エディター。ページタイトルのH1はテーマ側の場合もある | 公開ページの表示とHTMLで、見出しの対応を見る |
| サイト全体に意図しないnoindex | 設定→表示設定の「検索エンジンでの表示」、有効なプラグインの設定 | 公開HTMLとヘッダーを取り直す。設定画面だけで完了にしない |
| 特定ページのnoindex・canonical | SEOプラグインのページ別設定、テーマや追加コード | HTML全体のrobots meta、head内のcanonical、ヘッダーに望む指定が1つだけ出ているか |
X-Robots-Tag やHTTPの Link のcanonical |
サーバー設定、CDN、プラグインなどのヘッダーの生成元 | 対象URLへのGETの応答で、ステータス・転送先・ヘッダーを見る |
| robots.txt・sitemap | WordPressやSEOプラグインの生成設定、サーバー上の実ファイル | 公開中のファイルを取り直し、対象URLと規則を照らす |
サイト全体の「検索エンジンでの表示」の設定は、WordPress公式の表示設定の説明にあります(確認日:2026年10月12日)。実際の出力元はテーマとプラグインの組み合わせで変わるので、表は見に行く順番として使います。
直す順番は、まず「検索に出したいページが、意図せずnoindexやクロールの遮断になっていないか」(今回のケースD)、次に「代表URLの指定が重複していないか」です。見出しの整理は内容を読んで決めます。変える値・対象URL・戻し方を決め、1件ずつ確かめてから反映します。
手順4:判定不能の指摘のために、公開状態を取り直す
判定不能に分けた指摘は、資料を足してから判断します。自分が管理するページなら、次の記録をそろえます。
-
対象URL、最終的なURL、取得日時、HTTPステータスと転送、GETの応答のヘッダー、完全なHTML。
-
同じサイトの公開中のrobots.txtと、対象URLが属するsitemap。
-
Search ConsoleのURL検査の結果。Googleが持つ登録情報と、今のページへのライブテストを分けて記録し、Googleが選んだ正規URLも見る(URL検査の公式説明)。
-
変更したあとに、同じURL・同じ条件で取り直した記録。
速度の指標(LCP・INP・CLS)を指摘されたら、測った元、期間、端末、ラボの測定か実際の利用者のデータかを確かめます。保存したHTMLから値は出せません(GoogleのWeb Vitalsの説明)。
AIに、指摘の根拠を出し直してもらう
診断が長く、自分で照らすのが大変なときは、修正案を増やす前に、AIに指摘を判定表の形で出し直してもらいます。貼る情報に、認証情報や個人情報を含めないでください。
対象URLとページの目的:[URL/検索に出したいか/希望する代表URL]
渡す資料:[完全なHTMLか本文断片か、取得日時、ヘッダー・robots・sitemapの有無]
元の診断:[ここに貼る]
各指摘を「観測した値」「根拠となる箇所」「公式資料」「問題候補/確認範囲内で正常/判定不能」「次の確認」に分けてください。
ページの目的と食い違う指摘を優先してください。
取得していないヘッダー、実インデックス、順位、速度の値は判定不能にしてください。
修正箇所が本文・テーマ・プラグイン・サーバーのどこか、まだ特定できない場合も書いてください。
返ってきた表も、該当するHTMLや公式資料と照らします。根拠の箇所が示されない指摘は、直す判断を保留します。
付録:保存したファイルを3つに分ける小さなPythonコード
AIの指摘と照らすための比較用に、保存したHTML・robots.txt・sitemapから、確かめられる範囲だけを判定するコードを用意しました。Python 3.10以降の標準ライブラリだけで動き、通信はしません。長いコードは折りたたんでいます。3つのファイルを空のフォルダにUTF-8で保存し、python3 run_checks.py を実行すると、18の例で判定を確かめられます。
| 入力例 | このコードの判定 | 読み方 |
|---|---|---|
noindex:掲載したいページにnoindex |
metaが問題候補 | 公開HTMLと設定を確かめる |
body-noindex:body内にnoindex |
metaが問題候補 | headだけでなくHTML全体を見る |
intended:掲載を望まないページにnoindex |
metaは範囲内で正常 | noindexの削除は不要 |
conflict:異なるcanonicalが2つ |
canonicalが問題候補 | 重複して出力している元を探す |
fragment:本文だけ |
metaとcanonicalは判定不能 | 「titleがない」とは言えない |
two-h1:H1が2つ、コメントにnoindexの文字 |
metaは範囲内で正常、H1数は2として記録 | H1の数は判定に使わない |
wp-default:WordPress標準のrobots.txtとsitemap index |
robotsとsitemapは判定不能 | 規則と子sitemapを手で確かめる |
このコードのrobots.txtの判定は、単一の User-agent: * と単純な Disallow だけを扱い、Allow: や Sitemap: の行があれば判定不能にします。WordPressの実際のrobots.txtはこの形に当たるので、手順2のケースEのように、Googleの仕様に沿って手で確かめます。http(ヘッダー)、index(登録状態)、cwv(速度)は、入力に含まれないので常に判定不能です。コードの出力では、「確認した範囲では正常」を「範囲内で正常」と表示します。
fixtures.py:18の例を作る
want_index は検索に出したいなら true、出したくないなら false、分からなければ null です。preferred は運営者が代表にしたいURLで、Googleが選ぶURLとは別です。URLはすべて example.com です。
コードを開く
import json
from pathlib import Path

URL = 'https://example.com/guide/'
OTHER = 'https://example.com/original/'
CANON = f'<link rel="canonical" href="{URL}">'
XML = f'<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"><url><loc>{URL}</loc></url></urlset>'

def fixture(name, meta='', canonical=CANON, body='<h1>手順</h1>', want=True,
            preferred=URL, robots='User-agent: *\nDisallow:\n', sitemap=XML, fragment=False, base=''):
    d = Path('fixtures') / name
    d.mkdir(parents=True, exist_ok=True)
    html = body if fragment else f'<!doctype html><html lang="ja"><head><meta charset="utf-8"><title>手順</title>{base}{meta}{canonical}</head><body>{body}</body></html>'
    for file, text in [('page.html', html), ('robots.txt', robots), ('sitemap.xml', sitemap),
                       ('intent.json', json.dumps({'url': URL, 'want_index': want, 'preferred': preferred}, ensure_ascii=False, indent=2))]:
        (d / file).write_text(text, encoding='utf-8')

fixture('normal')
fixture('noindex', meta='<meta name="robots" content="noindex, follow">')
fixture('fragment', body='<h1>本文だけ</h1>', fragment=True)
fixture('conflict', canonical=CANON + f'<link rel="canonical" href="{OTHER}">')
fixture('intended', meta='<meta name="robots" content="noindex">', want=False)
fixture('unknown-intent', meta='<meta name="robots" content="noindex">', want=None)
fixture('googlebot-none', meta='<meta name="googlebot" content="NONE">')
fixture('cross-canonical', canonical=f'<link rel="canonical" href="{OTHER}">', preferred=OTHER,
        sitemap=XML.replace(URL, OTHER))
fixture('missing-canonical', canonical='')
fixture('blocked-noindex', meta='<meta name="robots" content="noindex">', robots='User-agent: *\nDisallow: /guide/\n')
fixture('complex-robots', robots='User-agent: *\nDisallow: /\nAllow: /guide/\n')
fixture('broken-sitemap', sitemap='<urlset>')
fixture('two-h1', body='<h1>手順</h1><h1>別の区分</h1>',
        meta="""<!-- <meta name="robots" content="noindex"> --><script>const s = '<meta name="robots" content="noindex">';</script>""")
fixture('sitemap-index', sitemap='<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"></sitemapindex>')
fixture('base-relative', canonical='<link rel="canonical" href="guide/">', base='<base href="https://example.com/">')
fixture('relative', canonical='<link rel="canonical" href="/guide/">')
fixture('body-noindex', body='<meta name="robots" content="noindex"><h1>手順</h1>')
# WordPress標準に近いrobots.txtとコアのsitemap index(この最小コードでは判定不能になる例)
WP_ROBOTS = 'User-agent: *\nDisallow: /wp-admin/\nAllow: /wp-admin/admin-ajax.php\n\nSitemap: https://example.com/wp-sitemap.xml\n'
WP_INDEX = '<?xml version="1.0" encoding="UTF-8"?><sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"><sitemap><loc>https://example.com/wp-sitemap-posts-post-1.xml</loc></sitemap></sitemapindex>'
fixture('wp-default', robots=WP_ROBOTS, sitemap=WP_INDEX)
audit.py:確かめられる範囲だけ判定する
コードを開く
import json
import re
import sys
from html.parser import HTMLParser
from pathlib import Path
from urllib.parse import urljoin, urlsplit
import xml.etree.ElementTree as ET

P, N, U = '問題候補', '範囲内で正常', '判定不能'

class Page(HTMLParser):
    def __init__(self):
        super().__init__()
        self.head = False
        self.events, self.robots, self.canon = [], [], []
        self.base, self.h1 = False, 0

    def handle_starttag(self, tag, attrs):
        a = dict(attrs)
        if tag in ('html', 'head', 'body'):
            self.events.append(tag)
        if tag == 'head':
            self.head = True
        if tag == 'h1':
            self.h1 += 1
        if tag == 'meta' and (a.get('name') or '').lower() in ('robots', 'googlebot'):
            self.robots += re.split(r'[\s,]+', (a.get('content') or '').lower())
        if not self.head:
            return
        if tag == 'base':
            self.base = True
        if tag == 'link' and 'canonical' in (a.get('rel') or '').lower().split():
            self.canon.append(a.get('href') or '')

    def handle_endtag(self, tag):
        if tag in ('html', 'head', 'body'):
            self.events.append('/' + tag)
        if tag == 'head':
            self.head = False


def audit(folder):
    d = Path(folder)
    cfg = json.loads((d / 'intent.json').read_text(encoding='utf-8'))
    url, want, preferred = cfg['url'], cfg['want_index'], cfg['preferred']
    h = Page()
    h.feed((d / 'page.html').read_text(encoding='utf-8'))
    full = h.events == ['html', 'head', '/head', 'body', '/body', '/html']
    out = {k: U for k in ('meta', 'canonical', 'robots', 'sitemap', 'http', 'index', 'cwv')}
    noindex = bool({'noindex', 'none'} & set(h.robots))
    if full:
        out['meta'] = U if want is None else (P if noindex and want else N)
        targets = {urljoin(url, x) for x in h.canon if x}
        if not h.base and h.canon:
            if any(not x for x in h.canon) or len(targets) > 1:
                out['canonical'] = P
            elif preferred and all(urlsplit(x).scheme in ('http', 'https') for x in targets):
                out['canonical'] = N if targets == {preferred} else P
    # 教材専用: 単一の User-agent: * と単純な Disallow 接頭辞だけ扱う。
    lines = [(x.split('#', 1)[0]).strip() for x in (d / 'robots.txt').read_text(encoding='utf-8').splitlines()]
    lines = [x for x in lines if x]
    rules, supported = [], bool(lines) and lines[0].lower() == 'user-agent: *'
    for line in lines[1:]:
        key, sep, value = line.partition(':')
        value = value.strip()
        if not sep or key.lower() != 'disallow' or (value and not value.startswith('/')) or any(c in value for c in '*$%?'):
            supported = False
        rules.append(value)
    if supported:
        blocked = any(x and urlsplit(url).path.startswith(x) for x in rules)
        out['robots'] = (U if want is None else P if want else N) if blocked else N
    try:
        root = ET.fromstring((d / 'sitemap.xml').read_text(encoding='utf-8'))
        ns = '{http://www.sitemaps.org/schemas/sitemap/0.9}'
        if root.tag == ns + 'urlset':
            locs = [x.text for x in root.findall(ns + 'url/' + ns + 'loc')]
            out['sitemap'] = N if preferred and preferred in locs else U
    except ET.ParseError:
        out['sitemap'] = P
    return {'checks': out, 'observed': {'complete_markers': full, 'html_noindex': noindex if full else None,
            'canonical_hrefs': h.canon if full else None, 'h1_count': h.h1},
            'scope': '確認したのは保存したHTML・robots.txt・sitemap.xml。正常は各項目の確認範囲に限る。HTTP・登録状態・CWVは別に取得して確かめる'}

if __name__ == '__main__':
    print(json.dumps(audit(sys.argv[1]), ensure_ascii=False, indent=2))
run_checks.py:例ごとの判定を照らす
コードを開く
import json
import runpy
from pathlib import Path
from audit import audit, P, N, U

runpy.run_path('fixtures.py')
# 期待値:例ごとに、記事の3分類(問題候補/範囲内で正常/判定不能)で決めた値。
expected = {
    'normal': [N,N,N,N], 'noindex': [P,N,N,N], 'fragment': [U,U,N,N],
    'conflict': [N,P,N,N], 'intended': [N,N,N,N], 'unknown-intent': [U,N,N,N],
    'googlebot-none': [P,N,N,N], 'cross-canonical': [N,N,N,N],
    'missing-canonical': [N,U,N,N], 'blocked-noindex': [P,N,P,N],
    'complex-robots': [N,N,U,N], 'broken-sitemap': [N,N,N,P],
    'two-h1': [N,N,N,N], 'sitemap-index': [N,N,N,U], 'base-relative': [N,U,N,N],
    'relative': [N,N,N,N], 'body-noindex': [P,N,N,N], 'wp-default': [N,N,U,U],
}
results = {}
for name, values in expected.items():
    result = audit(Path('fixtures') / name)
    assert [result['checks'][k] for k in ('meta','canonical','robots','sitemap')] == values, name
    assert all(result['checks'][k] == U for k in ('http','index','cwv')), name
    results[name] = result
assert results['two-h1']['observed']['h1_count'] == 2
assert results['fragment']['observed']['html_noindex'] is None
assert results['two-h1']['observed']['html_noindex'] is False
Path('results.json').write_text(json.dumps(results, ensure_ascii=False, indent=2) + '\n', encoding='utf-8')
Path('checks.json').write_text(json.dumps({'fixture_cases':len(expected),'status_assertions':len(expected)*7,
    'observation_assertions':3,'passed':True,'expected':expected}, ensure_ascii=False, indent=2)+'\n', encoding='utf-8')
print(f'CHECK_OK: {len(expected)} cases, {len(expected)*7} statuses, 3 observations')
python3 run_checks.py の出力は次のとおりで、全例の結果は results.json に保存されます。
CHECK_OK: 18 cases, 126 statuses, 3 observations1つの例を見るときは python3 audit.py fixtures/noindex を実行します。
{
  "checks": {
    "meta": "問題候補",
    "canonical": "範囲内で正常",
    "robots": "範囲内で正常",
    "sitemap": "範囲内で正常",
    "http": "判定不能",
    "index": "判定不能",
    "cwv": "判定不能"
  },
  "observed": {
    "complete_markers": true,
    "html_noindex": true,
    "canonical_hrefs": [
      "https://example.com/guide/"
    ],
    "h1_count": 1
  },
  "scope": "確認したのは保存したHTML・robots.txt・sitemap.xml。正常は各項目の確認範囲に限る。HTTP・登録状態・CWVは別に取得して確かめる"
}
meta が問題候補でも、http や index は判定不能のままです。この例で採る行動は「掲載したいページのnoindexを、公開HTMLと設定で確かめる」で、AIの指摘を一括で直す前に、同じように観測した値と目的を照らします。