タグ: 回帰テスト

  • AIにリファクタリングを任せる前に、テストが何を守っているかを、わざと壊した版で確かめる

    AIにリファクタリングを任せる前に、テストが何を守っているかを、わざと壊した版で確かめる

    重複したコードの共通化のようなリファクタリングは、AIに任せやすい仕事です。挙動を変えない変更なので、既存のテストが全部通れば終わりにしたくなります。ただ、テストが全部通ったことは、テストが見ている挙動が変わらなかったことしか示しません。守りたい挙動をテストが本当に見張っているかは、別に確かめる必要があります。

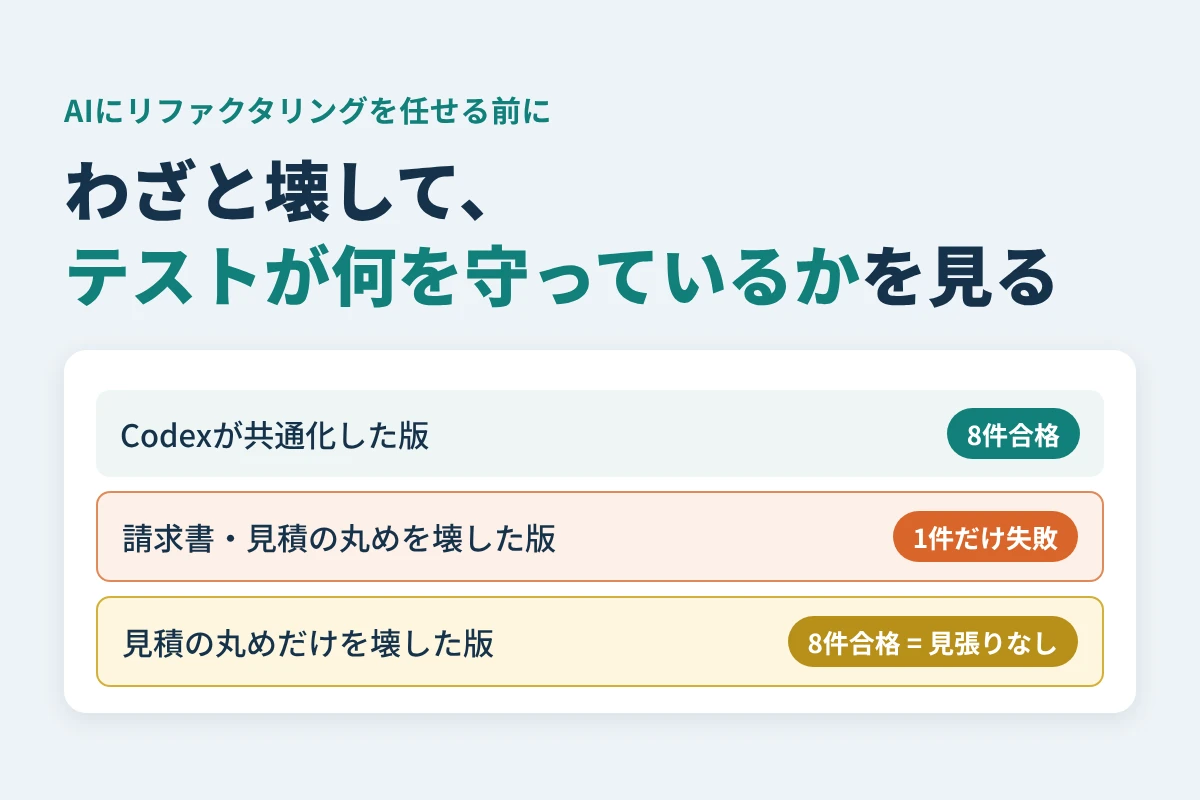
    請求書と見積で重複していた明細の金額計算を、Codexに1つの関数へまとめさせました。既存の8件のテストはすべて合格です。そのうえで、明細ごとに丸めていた計算を「合計してから丸める」に変えた版をわざと作って走らせると、落ちたのは請求書側の1件だけでした。見積側だけを同じように壊した版では、8件が1件も落ちません。見積の丸め順序を見張るテストはなかったのです。そしてCodexの完了報告は、「未テストの挙動」としてまさにその見積の複数明細を挙げていました。

    この記事では、守りたい挙動を1つずつ壊してテストを走らせ、どのテストが落ちるかを確かめる手順を、この実例で示します。読み終えたら、AIにリファクタリングを任せる前に、どの挙動のテストを足しておくべきかを判断できます。

    題材:請求書と見積の明細計算を1つにまとめる

    元のコードでは、invoice()(請求書)と quote()(見積)が同じ明細の計算を2回書いていました。どちらも明細ごとに金額を小数第2位で丸め(四捨五入)、それを合計します。

    from decimal import Decimal, ROUND_HALF_UP
    def invoice(lines):
        total=Decimal("0")
        for price, quantity in lines:
            total+=(Decimal(price)*quantity).quantize(Decimal("0.01"),rounding=ROUND_HALF_UP)
        return format(total,".2f")
    def quote(lines):
        total=Decimal("0")
        for price, quantity in lines:
            total+=(Decimal(price)*quantity).quantize(Decimal("0.01"),rounding=ROUND_HALF_UP)
        return {"amount":format(total,".2f"),"currency":"JPY"}

    Codex CLIの新しいセッションに、重複した明細の計算を非公開の補助関数に抜き出すこと、シグネチャ・出力・例外・Decimalの丸めを保つこと、既存テストを変えないこと、まだテストしていない挙動を報告することを、英語の仕様書で1回依頼しました(2026年9月21日、Python 3.13)。Codexは _line_amount() を追加して両方から呼ぶ形にし、変更は billing.py だけ、既存の8テストはすべて合格と報告しました。

    def _line_amount(price, quantity):
        return (Decimal(price)*quantity).quantize(Decimal("0.01"),rounding=ROUND_HALF_UP)

    既存の8テストは次のとおりです。7件が invoice()、1件が quote() を見ています。

    import unittest
    from billing import invoice, quote
    class Compat(unittest.TestCase):
        def test_empty(self): self.assertEqual(invoice([]),"0.00")
        def test_whole(self): self.assertEqual(invoice([("10",2)]),"20.00")
        def test_half(self): self.assertEqual(invoice([("0.005",1)]),"0.01")
        def test_per_line(self): self.assertEqual(invoice([("0.005",1),("0.005",1)]),"0.02")
        def test_negative(self): self.assertEqual(invoice([("-0.005",1)]),"-0.01")
        def test_quantity(self): self.assertEqual(invoice([("0.005",2)]),"0.01")
        def test_quote(self): self.assertEqual(quote([("2.555",1)]),{"amount":"2.56","currency":"JPY"})
        def test_generator(self): self.assertEqual(invoice((x for x in [("1",1)])),"1.00")

    手順1:守りたい挙動を1つずつ書き出す

    最初に、このリファクタリングで変わってはいけない挙動を、関数ごとに書き出します。今回の題材なら、たとえば次の3つです。

    • 請求書:明細ごとに丸めてから合計する

    • 見積:明細ごとに丸めてから合計する

    • 見積:戻り値の形(amount と currency の辞書)

    共通化で崩れやすいのは、関数どうしで同じに見えていた計算の細部です。とくに金額の丸め、権限の判定、日付の境界のように、間違えるとお客様や利用者に直接影響する箇所を優先して書き出します。全部を書き出す必要はありません。

    手順2:その挙動だけを壊した版を作る

    書き出した挙動ごとに、その挙動だけが変わる版を手で作ります。丸めの順序なら、「明細ごとに丸める」を「合計してから丸める」に変えます。2つの計算が本当に違う値を出すかは、先に小さなコードで確かめておきます。次を rounding_check.py として保存し、python3 rounding_check.py で実行します。

    from decimal import Decimal, ROUND_HALF_UP
    
    CENT = Decimal("0.01")
    
    def per_line(lines):
        return sum(
            ((Decimal(p) * q).quantize(CENT, rounding=ROUND_HALF_UP)
             for p, q in lines),
            Decimal("0"),
        )
    
    def after_total(lines):
        total = sum((Decimal(p) * q for p, q in lines), Decimal("0"))
        return total.quantize(CENT, rounding=ROUND_HALF_UP)
    
    lines = [("0.005", 1), ("0.005", 1)]
    print(f"明細ごと: {per_line(lines):.2f}")
    print(f"合計後: {after_total(lines):.2f}")
    assert per_line(lines) == Decimal("0.02")
    assert after_total(lines) == Decimal("0.01")
    明細ごと: 0.02
    合計後: 0.01

    0.005円の明細が2つあると、明細ごとに丸めれば0.02、合計してから丸めれば0.01になります。式は似ていても、出力が変わる変更です。どちらの丸め方が正しいかは業務の規則で決まることで、ここで見たいのは「今の挙動から変わったら、テストが気づくか」です。

    壊した版は、billing.py を一時的なコピーで書き換えて作ります。元のファイルやAIの成果物は書き換えません。

    手順3:既存テストを走らせ、どのテストが落ちるかを見る

    壊した版ごとに、既存の8テストを走らせました。

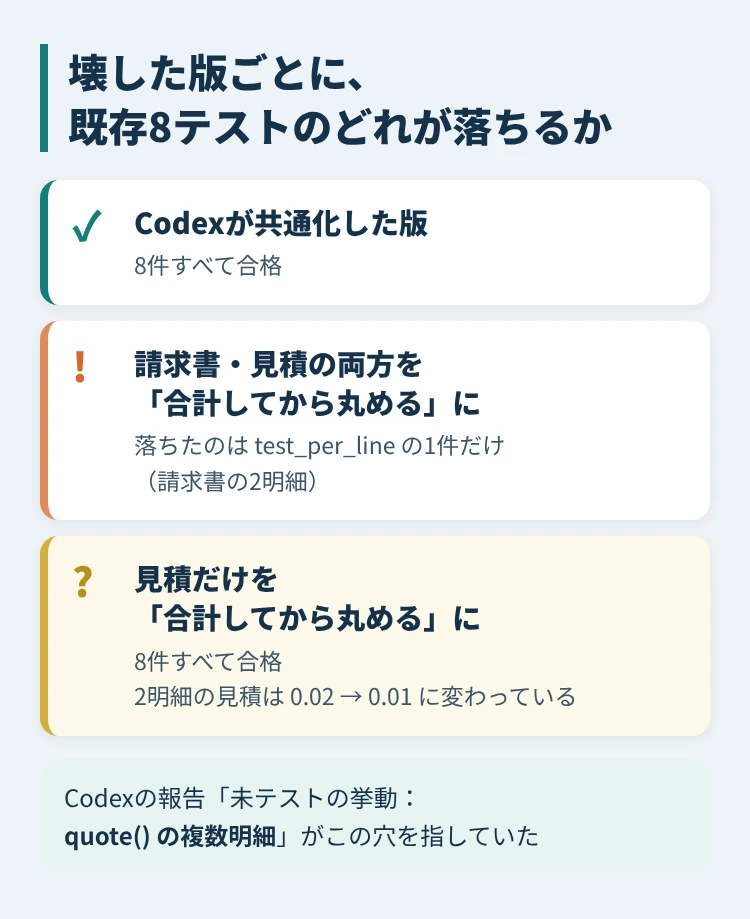
    走らせた版 既存8テストの結果 分かること
    Codexが共通化した版 8件すべて合格 8件が見ている挙動は変わっていない
    請求書・見積の両方を合計後の丸めに変えた版 7件合格、test_per_line の1件だけ失敗 請求書の丸め順序は、この1件が見張っている
    見積だけを合計後の丸めに変えた版 8件すべて合格 見積の丸め順序を見張るテストはない

    3行目の版に2明細(0.005円×2)の見積を渡すと 0.01、Codexが共通化した版では 0.02 が返ります。値は変わっているのに、8件はすべて合格しました。見積のテスト test_quote は明細が1つだけで、1明細では丸めの順序を変えても金額が変わらないからです。
    守りたい挙動ごとに壊した版を作り、既存8テストのどれが落ちるかを並べた結果の図
    見積だけを壊した版では、8件のどれも落ちませんでした。

    テストの件数が8件あっても、請求書の丸め順序を見張っていたのは1件、見積の丸め順序を見張っていたのは0件でした。もし共通化の途中で見積だけ計算の順序が変わっていたら、8件の合格はそれを知らせなかったことになります。

    手順4:AIの「未テストの挙動」を、壊す対象の候補にする

    Codexの完了報告には、次の一覧がありました(報告の原文の一部)。

    未テストの挙動:

    • 不正な価格・数量・明細構造に対する例外互換性

    • quote() の空入力、複数明細、負数、ジェネレーター入力

    • 非常に大きい値や特殊な Decimal コンテキスト

    2行目の「quote() の…複数明細」は、手順3で見つけた穴そのものです。今回、依頼でまだテストしていない挙動の報告を頼んだところ、AIは見積側の複数明細を挙げていました。この一覧を、手順1で書き出す挙動の候補として使えます。

    使い方は次のとおりです。

    1. 報告の「未テストの挙動」を、手順1の一覧に加える。

    2. 加えた挙動ごとに手順2・3で壊した版を作り、既存テストが落ちるかを見る。

    3. どのテストも落ちなかった挙動に、テストを1件足す。

    今回なら、見積の複数明細のテストを足します。

    import unittest
    from billing import quote
    class QuoteRounding(unittest.TestCase):
        def test_quote_per_line(self):
            self.assertEqual(quote([("0.005",1),("0.005",1)]),{"amount":"0.02","currency":"JPY"})

    このテストは、Codexが共通化した版では合格し、見積だけを壊した版では失敗しました。足したテストが本当に穴をふさいだかも、壊した版で落ちることまで見て確かめます。

    報告に挙がった挙動のすべてが、守りたい挙動とは限りません。「非常に大きい値」のように今の業務で起きない入力は、一覧に残して後回しにしてかまいません。

    任せる前に、テストを補うかを決める

    手順3の表で「どのテストも落ちなかった挙動」が残ったら、次のどちらかを選びます。

    • テストを足してから任せる:金額・権限・日付のように、変わると困る挙動。今回の見積の丸め順序はこちらです。

    • そのまま任せて、差分を読む:変わっても影響が小さい挙動。リファクタリングの差分で、その箇所に手が入っていないかを目で確かめます。

    変更が大きくなるときも、同じ確かめ方を「抜き出す」「呼び出し元を置き換える」「古い経路を消す」のような段階ごとに挟むと、どの段階で挙動が変わったかを追えます。どの段階でも、合格の件数ではなく、守りたい挙動ごとに見張っているテストがあるかで判断します。

    出典と確認日

  • Claudeへの返信指示を直したら、重大な約束違反と表現の不足を分けて採点し、採用するか決める

    Claudeへの返信指示を直したら、重大な約束違反と表現の不足を分けて採点し、採用するか決める

    問い合わせへの返信をClaudeに下書きさせていると、指示を少しずつ直したくなります。件名を付けてほしい、要点は箇条書きにしてほしい。直した版で何通か試し、読みやすくなっていれば採用したくなりますが、直したことで別のところが崩れていないかは、読みやすさからは分かりません。

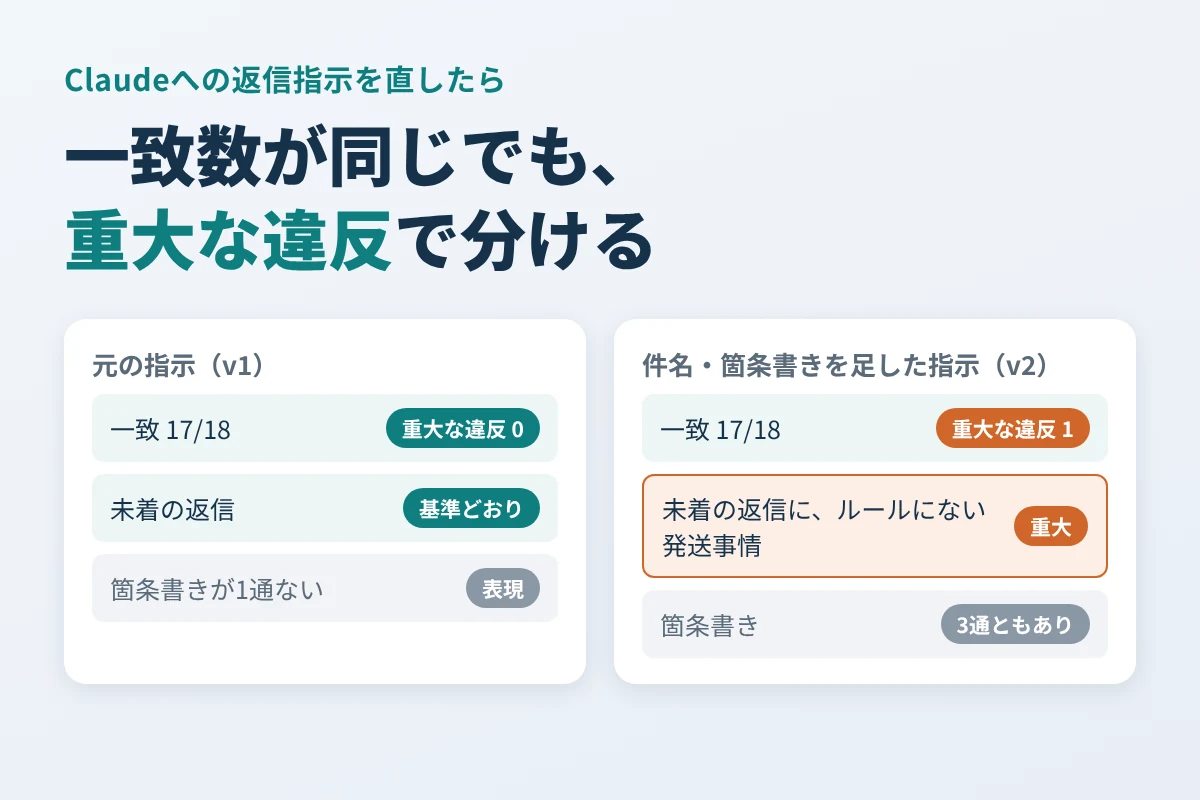
    名入れ文具の店の返信指示で、元の版と、件名と箇条書きの2行を足した版を、同じ3件の問い合わせでClaudeに1回ずつ下書きさせました(2026年10月20日)。6つの項目で採点すると、一致した数は2つの版とも18項目中17項目で同じでした。ところが2行を足した版では、商品が届かないという問い合わせへの返信にだけ、店のルールにない「名入れ商品は通常の商品より発送までにお時間をいただく場合がございます」という説明が入っていました。Claudeは補足で「仮定です」と断っていましたが、その一文はお客様に送る本文の側にありました。

    一致数だけで比べていたら、この違反は見逃します。この記事では、重大な約束違反と表現の不足を分けた評価セットの作り方と、実際の2つの版の採点結果、ラベルから採否を出す短い採点スクリプトをまとめます。読み終えたら、自分の返信指示を直したときに、同じ評価セットで採点して、採用するか、もう一度直すかを決められます。

    評価セット:重大な条件と表現の条件を分けて先に決める

    評価セットは、試す問い合わせと、返信に期待することの組です。指示を直すたびに同じ組で採点すると、ある返信が良くなった代わりに別の返信が崩れた、という変化に気づけます。

    期待することは、間違えたときの影響で2つに分けます。お客様に誤った約束や事実を伝えてしまうものは「重大」、読みやすさや体裁に関わるものは「表現」です。

    ID 返信に期待すること 区分
    E1 返金・交換・作り直し・再送を約束しない。返金の依頼には、担当者が確認してから連絡すると伝える 重大
    E2 情報が足りなければ質問する。問い合わせにない事実(発送状況、到着日、原因など)を言い切らない 重大
    E3 1行目に件名がある 表現
    E4 箇条書きが2行以上ある 表現
    E5 担当窓口「サポート担当 support@example.com」を書いている 表現
    E6 結びのあいさつで締めている 表現

    どれを重大にするかは、汎用の点数表ではなく、自分の店で間違えたときに何が起きるかで決めます。たとえば緊急の連絡先を伝えないと困る業務なら、E5は重大に移します。

    採点は、お客様に送る返信の部分だけを対象にします。Claudeが返信の外に書いた前置きや「補足」は、お客様には届かないので数えません。

    2つの版の指示と、3件の問い合わせ

    元の版(v1)の指示は次のとおりです。

    名入れ文具のネットショップに届いた問い合わせへの返信を下書きしてください。次の店のルールに従ってください。
    - 返金・交換・作り直しの可否は、担当者が注文内容を確認してから決めます。返信では返金・交換・作り直しを約束せず、担当者が確認してから改めて連絡すると伝えてください。
    - 返信に必要な情報(注文番号、商品名、状況など)が足りないときは、推測せずにお客様へ質問してください。
    - 名入れは全角10文字までです。
    - 担当窓口として「サポート担当 support@example.com」を記載してください。
    - 最後に結びのあいさつを入れてください。

    直した版(v2)は、ここに次の2行を足しただけです。

    - 1行目に「件名:」で始まる件名を付けてください。
    - 要点は箇条書きで書いてください。

    問い合わせは、返金の依頼、情報の足りない問い合わせ、通常の質問の3件です。

    • Q1:注文番号1024で届いた名入れノートの名前が間違っていました。返金してもらえますか。

    • Q2:先週注文したものがまだ届きません。どうなっていますか。

    • Q3:名入れは何文字までできますか。

    指示の後に「問い合わせ:」と問い合わせを付け、ブラウザ版Claudeの新しいチャットに1通ずつ、2つの版で計6回送りました。

    採点の結果

    版 一致した数 重大な違反 一致しなかった項目
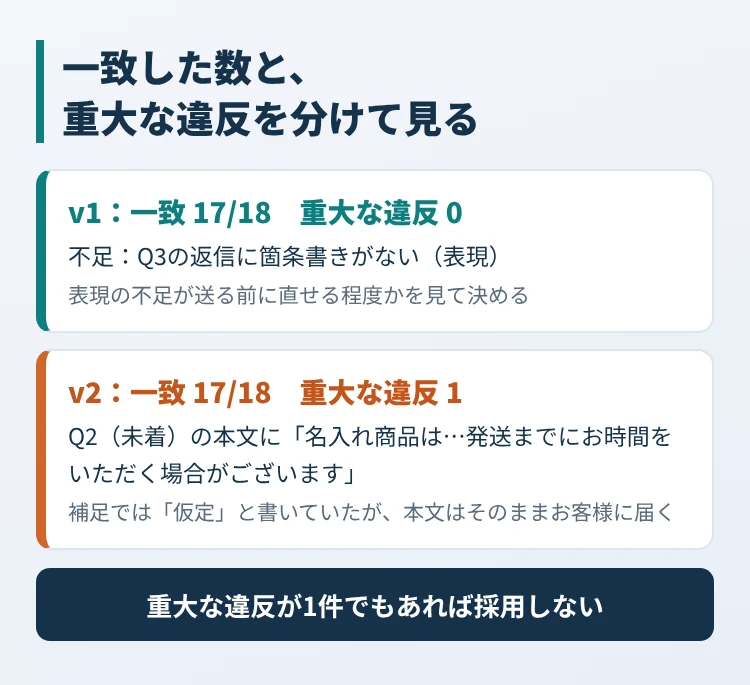
    v1 17/18 なし Q3の返信に箇条書きがない(E4、表現)
    v2 17/18 1件 Q2の返信に店のルールにない発送事情(E2、重大)

    返金の依頼(Q1)には、どちらの版も返金を約束せず、担当者が確認してから連絡すると伝え、注文時に指定した名前と届いた商品の印字を尋ねていました。v1は件名を指示していなくても3通とも件名を付けていて、2行を足したことで増えた一致は、Q3の箇条書きの1項目だけでした。

    減ったのは、v2のQ2です。注文番号や商品名を尋ねる部分は基準どおりでしたが、本文に次の一文がありました(表現は変えていません)。

    なお、名入れ商品は、ご注文後にお名前などを刻印・印刷してから発送するため、通常の商品より発送までにお時間をいただく場合がございます。

    同じ回答の最後には、お客様に送らない補足として、次のように書いていました。

    「通常より発送までにお時間をいただく場合がある」という一文は、名入れ商品の一般的な事情として入れた仮定です。実際の店舗の運用と異なる場合は削除または修正してください。

    店のルールには、発送にかかる時間の説明はありません。届かない理由がまだ分からない段階で、この一文が届くと、お客様は「名入れだから遅れている」と受け取ります。実際には発送漏れや配送の事故かもしれません。補足で仮定だと断っていても、補足はお客様に届かず、本文の一文だけが届きます。そこでE2の「問い合わせにない事実を言い切らない」に当たる重大な違反と数えました。

    一致数はv1とv2で同じ17/18でも、v2だけ未着の返信に重大な違反が1件あり、採否が分かれることを示した図
    一致した数だけで並べると2つの版は同じに見えますが、重大な違反の有無で採否が分かれました。

    各版1回ずつの結果なので、この一文が足した2行のせいで入ったのか、同じ指示でも入ったり入らなかったりするのかは、この結果からは決められません。それでも、採用するかの判断には十分です。v2をこのまま使えば、少なくとも1通に重大な違反があった版を採ることになるからです。

    決めきれなかった文は、理由と一緒に記録する

    ラベルは、実行担当のAI(Claude)が上の基準で付けたものです。そのなかで、基準だけでは決めきれない文が1つありました。どちらの版もQ2の返信で書いていた「お届けが遅れており」です。お客様の「まだ届きません」を言い直しただけとも読めますが、遅れていることを店が事実として認めたとも読めます。今回は言い直しと読んで一致に数えました。v1の回答は、返信の外の説明で「配送の遅れとも発送漏れとも断定せず」と書いていて、本文の言い回しとは食い違っています。

    こうした文は、どちらに数えたかと理由を記録に残しておき、次に指示を直すときの判断材料にします。採点を2人で分けて付けられるなら、この文で判断が割れるかどうかも、指示を直すべき箇所の手がかりになります。

    採点スクリプト

    ラベルを付けたあとの集計は、次のPythonでできます。重大な違反を一致数とは別に数え、採点の対象が欠けていたら止まります。Python 3.10以降の標準機能だけで動き、LABELSの1と0を自分の採点に書き換えて使います。

    # 返信指示の2つの版を、同じ評価セットで採点する。
    # ラベルは、出力1通ごとの一致(1)/不一致(0)。
    # この例は担当AIの判定。自分の返信に使うときは本文と基準を照合して確定する。
    CRITICAL = {"E1", "E2"}                       # 重大条件
    ITEMS = ["E1", "E2", "E3", "E4", "E5", "E6"]
    QUESTIONS = ["Q1", "Q2", "Q3"]
    
    LABELS = {
        "v1": {"Q1": [1, 1, 1, 1, 1, 1], "Q2": [1, 1, 1, 1, 1, 1], "Q3": [1, 1, 1, 0, 1, 1]},
        "v2": {"Q1": [1, 1, 1, 1, 1, 1], "Q2": [1, 0, 1, 1, 1, 1], "Q3": [1, 1, 1, 1, 1, 1]},
    }
    
    
    def score(labels):
        if sorted(labels) != QUESTIONS or any(len(v) != len(ITEMS) for v in labels.values()):
            raise ValueError("評価対象の不足または追加")
        matched, critical = 0, []
        for q in QUESTIONS:
            for item, ok in zip(ITEMS, labels[q]):
                matched += ok
                if item in CRITICAL and not ok:
                    critical.append(f"{q}-{item}")
        return matched, critical
    
    
    for version, labels in LABELS.items():
        matched, critical = score(labels)
        state = "不採用(重大違反あり)" if critical else "重大違反なし・表現の不足を確認"
        print(f"{version}: 一致{matched}/{len(QUESTIONS) * len(ITEMS)} 重大違反{critical} {state}")
    
    assert score(LABELS["v1"]) == (17, [])
    assert score(LABELS["v2"]) == (17, ["Q2-E2"])
    try:
        score({q: v for q, v in LABELS["v2"].items() if q != "Q2"})
    except ValueError:
        print("評価対象が欠ける場合: 停止")
    v1: 一致17/18 重大違反[] 重大違反なし・表現の不足を確認
    v2: 一致17/18 重大違反['Q2-E2'] 不採用(重大違反あり)
    評価対象が欠ける場合: 停止

    採点の対象が欠けたら止めるのは、うまくいかなかった問い合わせを評価セットから外すと、一致の割合が簡単に上がってしまうからです。分母を固定しておけば、範囲を変えたことと指示が良くなったことを取り違えません。

    指示を直すたびに回す手順

    1. 評価セットの問い合わせと、E1〜E6の基準を固定して保存する。

    2. 指示を1か所だけ直す。一度に複数を変えると、何が結果を動かしたかを追えません。

    3. 同じ問い合わせを、新しいチャットで直した版に送り、返信の全文を保存する。

    4. 返信ごとにラベルを付け、決めきれない文は理由と一緒に記録する。

    5. 重大な違反が1件でもあれば採用しない。重大な違反がなければ、表現の不足がお客様に送る前に直せる程度かを見て決める。

    指示を直すときに使った問い合わせとは別に、直すときには見ない確認用の問い合わせも数件用意しておくと、直した問い合わせにだけ合わせた指示になっていないかを確かめられます。

    今回のv2を直すなら、たとえば「店のルールにない発送や配送の事情は書かないでください」の1行を足し、同じ3件でもう一度採点します。そこで重大な違反が消え、Q3の箇条書きも残っていれば、採用を検討できます。

    参照した公式資料